

除了Matplotlib,Python还有哪些高性能绘图库?
全面解析Python生态中超越Matplotlib的高性能绘图库,涵盖PyQtGraph、Datashader、VisPy与Bokeh/Plotly WebGL的技术内核、选型维度与实操代码。
一、为什么 Matplotlib 会遭遇性能天花板?
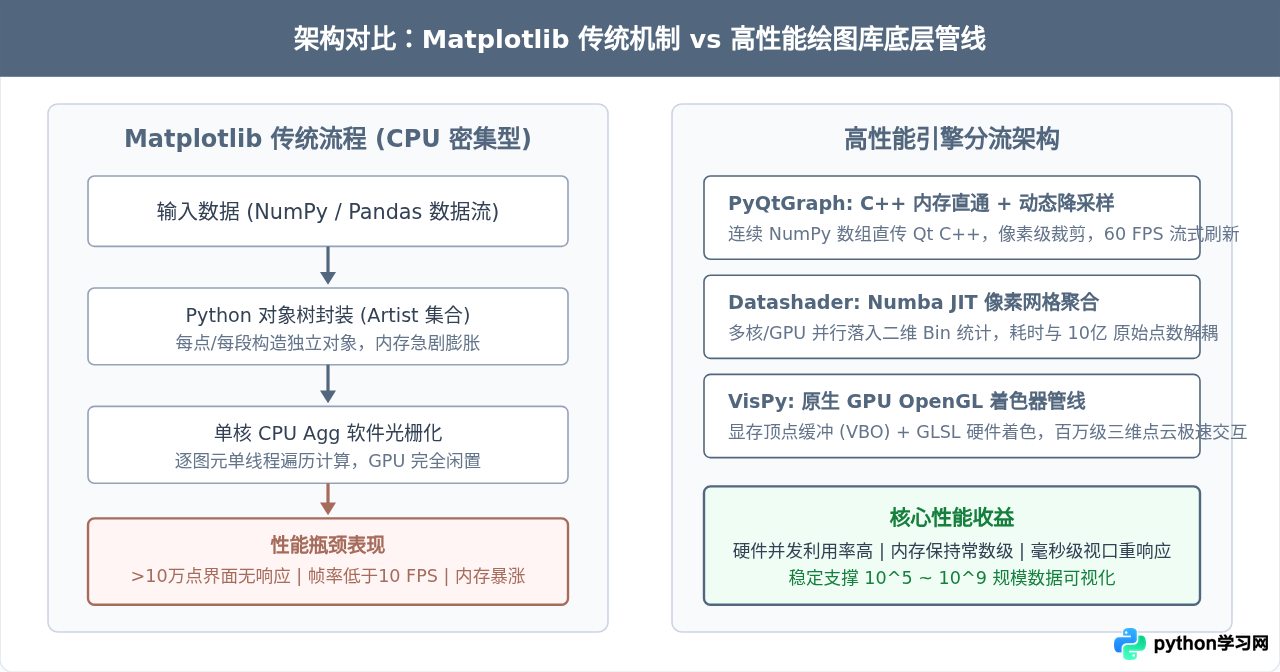
在评估替代方案前,需要厘清 Matplotlib 的性能瓶颈根源。Matplotlib 的设计初衷是提供出版级质量(Publication Quality)的静态图表输出,其内部架构优先保证图元定制的灵活性与渲染精度,而非运行时的吞吐量。这一设计哲学在面临大数据量时会引发三项严重的性能阻碍:
- 对象树封装的巨额开销:在 Matplotlib 中,散点图或折线图上的每一个图元、顶点与标注,都被封装为独立的 Python 对象(如
Line2D、PathCollection和Artist)。当离散点数量上升至 10 万到 100 万级别时,仅在内存中维护成千上万个 Python 对象的引用与属性检查,就会耗尽垃圾回收器与解释器的执行时间。 - 单线程 CPU 软件光栅化(Agg 后端):Matplotlib 默认采用 Anti-Grain Geometry (Agg) 引擎进行像素光栅化。Agg 依靠纯 CPU 计算每个抗锯齿多边形和笔触,完全无法调用现代显卡流处理器的并行渲染管线。在绘制高密度折线时,CPU 核心占满而 GPU 空闲。
- 重绘事件(Redraw)的全局扫描:在制作动态刷新图表时,调用
canvas.draw()会触发展开式的全局重绘。即便仅更新了一个数据点,图例、坐标轴、背景线与全部历史数据点均会重新计算光栅化,使画面帧率迅速跌落至个位数。
二、主流高性能绘图库的技术机制与适用场景
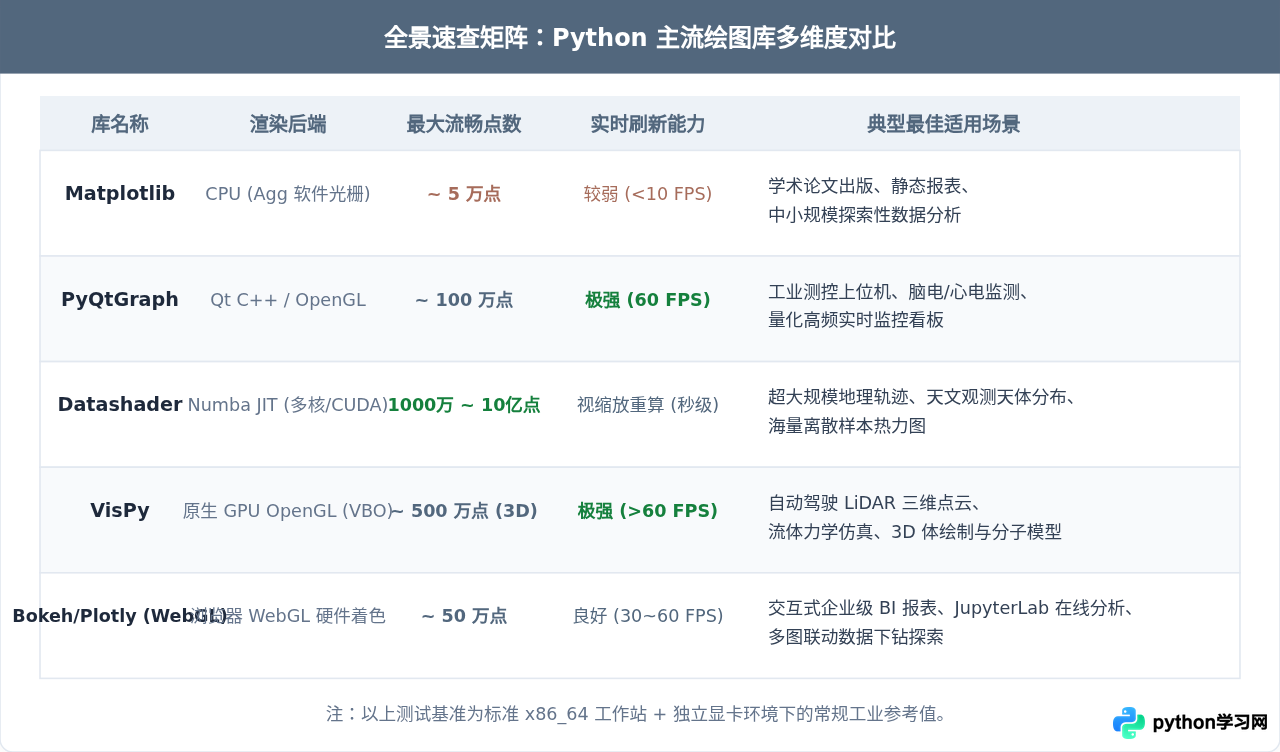
针对不同的计算瓶颈,Python 生态分化出了四种典型的高性能绘图工具,它们在底层依托不同的硬件与数学优化逻辑。
1. PyQtGraph:为实时数据流与工业测控而生
PyQtGraph 专门为数学、科学工程和测量领域中快速变化的数据而构建。它完全基于 PyQt / PySide 的 QGraphicsView 与 QPainter 体系,核心代码经过深度 C++ 绑定优化。
核心机制:PyQtGraph 直接消费连续内存的 NumPy 数组,跳过了 Python 层对象的逐个装箱。更为关键的是,它具备视口感知动态下采样(Downsampling)和视口外裁剪(View Clipping)机制。当在分辨率为 1920 宽度的显示器上绘制 100 万个采样点时,它会自动抽取当前像素所代表的局部极值点(Peak-to-Peak 算法),只绘制约 2000 个代表点。用户放大细节时,才实时抓取对应切片的完整采样。此外,它支持直接启用 OpenGL 硬件渲染后端(setConfigOptions(useOpenGL=True))。
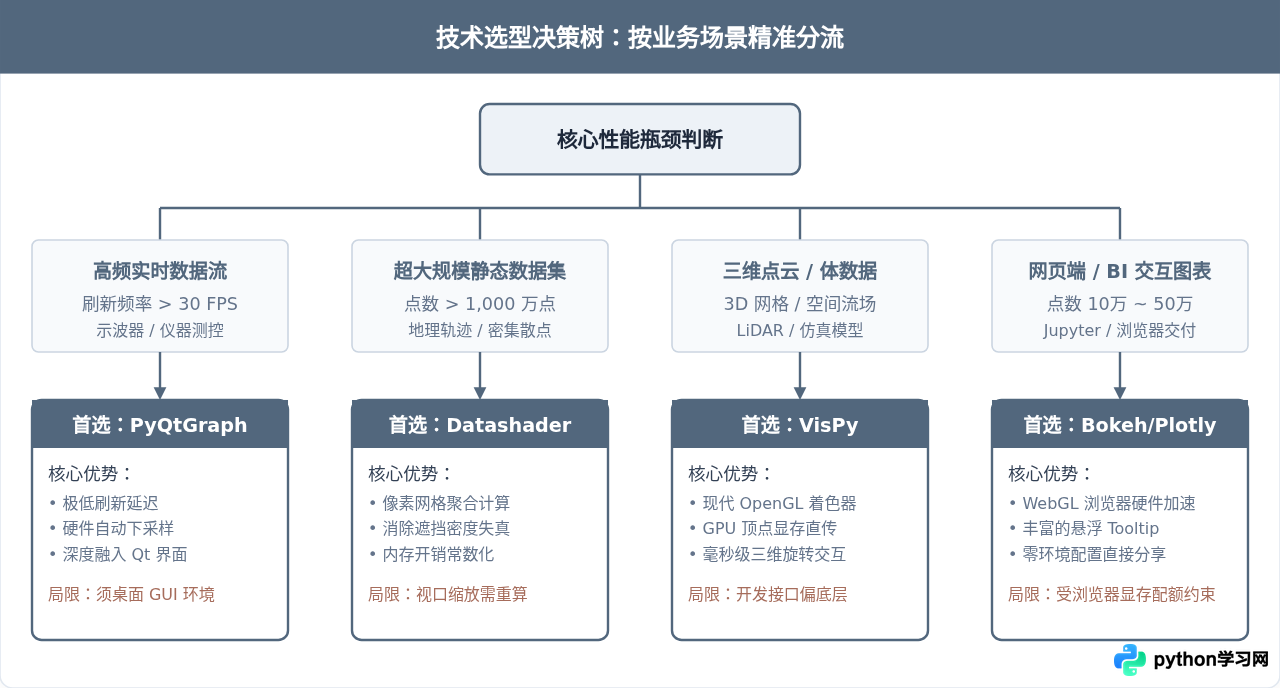
最佳场景:示波器、心电/脑电监测、高频量化交易监控系统、传感器实时波形流(稳定维持 60 FPS 刷新)。
2. Datashader:千万至十亿级大数据的像素栅格化利器
当数据规模突破千万级,直接向 GPU 或 GUI 绘制几何图元会造成显存耗尽,且密集数据点会互相重叠成一片纯色块,即“过度绘制(Overplotting)”。Datashader 颠覆了传统“把所有矢量点画到画布上”的逻辑。
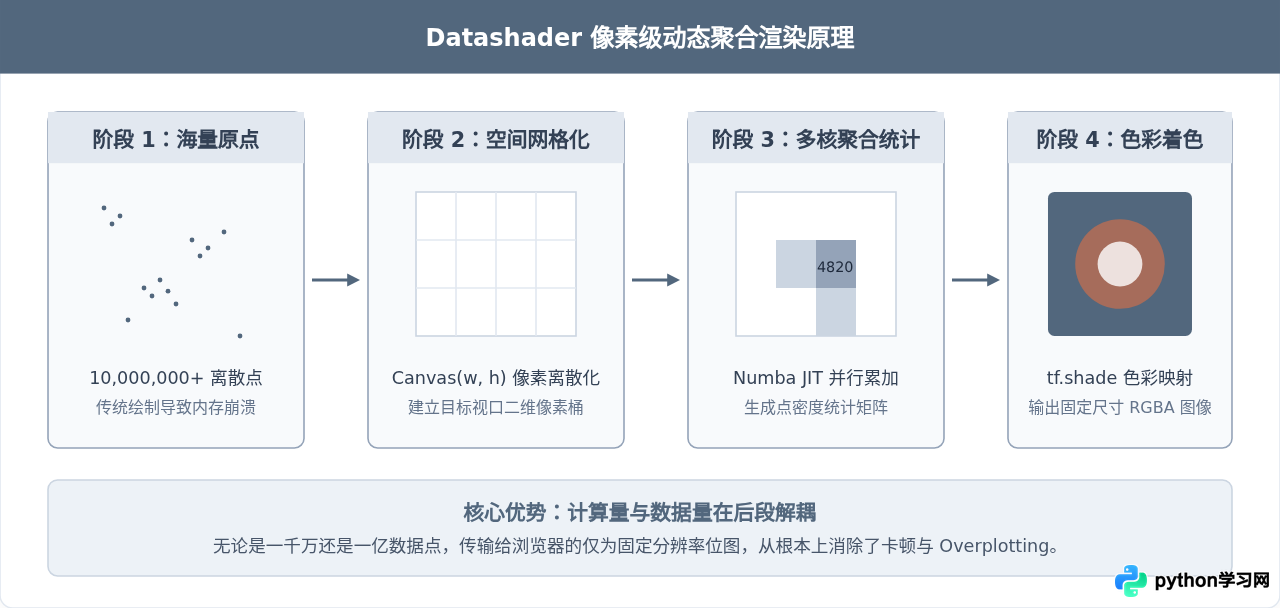
核心机制:Datashader 引入“栅格化聚合(Aggregation)”概念。它将可视化分解为两阶段:第一阶段,无论数据包含一千万点还是一亿点,Datashader 利用 Numba JIT 编译的多核并行计算(并支持 CUDA 加速),将所有点投影到目标像素网格中,统计每个网格桶(Bin)内的点频次或统计量;第二阶段,使用预设的色彩传递函数(Transfer Function)将该二维张量映射为一张固定尺寸的 RGBA 图像。这意味着,图表的渲染复杂度仅与屏幕分辨率挂钩,与数据量完全解耦。
最佳场景:全量城市出租车 GPS 轨迹分析、十亿级天文星图绘制、超大规模网络拓扑关系探索。
3. VisPy:硬件着色器驱动的原生 GPU 科学可视化
如果需要流畅呈现复杂的三维结构(如三维网格表面、体绘制 Volume Rendering、激光雷达点云),CPU 甚至轻量级 GUI 都会遇到几何变换瓶颈。VisPy 正是为此打造的底层高性能库。
核心机制:VisPy 绕过所有上层抽象层,直接与 OpenGL 驱动通信。数据在准备阶段被直接打包为显存顶点缓冲对象(VBO)和索引缓冲。坐标变换、投影、光照计算均通过自定义的 GLSL(OpenGL Shading Language)在 GPU 流处理器上并行计算。它提供了多层 API:底层的高性能 Gloo(对 OpenGL 现代管线的 Pythonic 封装)和高层的 SceneGraph 场景树(便于组装相机、坐标轴与交互器)。
最佳场景:自动驾驶 LiDAR 点云三维回放(数百万个三维动态点实时旋转平移)、流体力学三维网格分析、神经元突触三维网络重构。
4. Bokeh / Plotly (WebGL 模式):浏览器端高负载交互图表
在许多生产业务中,分析结果需要以网页(HTML / JupyterLab)形式向终端用户展示,此时无法直接运行本地 Qt 或原生 OpenGL 客户端。
核心机制:默认情况下,Bokeh 和 Plotly 采用 SVG 或 HTML5 2D Canvas 绘制图表,当点数超过 5,000 时,页面滚动与缩放开始出现明显延迟。然而,两款库均集成了 WebGL 硬件加速后端:
- Bokeh:只需在配置中添加
output_backend="webgl",其底层 BokehJS 引擎就会调用客户端浏览器的 WebGL 上下文,将离散标记渲染进显卡缓冲区。 - Plotly:在创建散点图或折线图时使用
go.Scattergl代替常规的go.Scatter。Plotly 底层使用基于 regl 的 WebGL 光栅化器。
最佳场景:需要保留富交互特性(如 Hover 提示、选框联动筛选)、数据量在 10 万到 50 万之间的企业级仪表盘与 Web 分析报告。
三、高性能绘图库选型决策体系
选择绘图库时,不应盲目追求“最高性能”,而需根据数据规模、刷新频率、目标平台及交互复杂度四个核心维度进行权衡。
四、核心库落地代码与关键调优参数
为了帮助读者直观理解各库的使用范式,本节提供三个典型生产场景的最小可运行代码及关键参数解析。
1. PyQtGraph:构建 60 FPS 实时示波器
在实时刷新的场景中,关键在于避免在循环中重复创建图形对象,并且必须启用视口感知优化。
import sys
import numpy as np
import pyqtgraph as pg
from PyQt5 import QtCore, QtWidgets

# 开启全局性能选项:使用 OpenGL 加速与抗锯齿控制
pg.setConfigOptions(useOpenGL=True, antialias=False)

class RealTimePlotter(QtWidgets.QMainWindow):
    def __init__(self):
        super().__init__()
        self.setWindowTitle("PyQtGraph 60 FPS 实时数据流监控")
        self.resize(900, 500)

        # 构建图表控件
        self.plot_widget = pg.PlotWidget()
        self.setCentralWidget(self.plot_widget)

        # 核心性能优化设置
        self.plot_item = self.plot_widget.getPlotItem()
        self.plot_item.setClipToView(True)           # 裁剪视口外数据,不参与绘制
        self.plot_item.setDownsampling(mode='peak')   # 开启峰值降采样模式

        # 预先创建曲线句柄(坚决杜绝在 update 中重复 plot)
        self.curve = self.plot_item.plot(pen=pg.mkPen(color='#52677D', width=1.5))

        # 缓存固定长度环形数据(100,000 点)
        self.buffer_size = 100000
        self.data = np.zeros(self.buffer_size, dtype=np.float32)
        self.phase = 0.0

        # 定时器驱动(16 ms 对应约 60 FPS)
        self.timer = QtCore.QTimer()
        self.timer.timeout.connect(self.update_data)
        self.timer.start(16)

    def update_data(self):
        self.phase += 0.1
        # 生成新批次数据并更新
        new_points = np.sin(np.linspace(self.phase, self.phase + 10, self.buffer_size, dtype=np.float32))
        # 直接使用 setData 覆写底层内存缓冲区,零对象分配
        self.curve.setData(new_points)

if __name__ == '__main__':
    app = QtWidgets.QApplication(sys.argv)
    window = RealTimePlotter()
    window.show()
    sys.exit(app.exec_())
setClipToView(True) 确保即便缓冲区存有几百万点,视口外的数据顶点也不会进入 Qt 绘制引擎;setData() 是 PyQtGraph 的核心方法,它直接在 C++ 层面同步 NumPy 数组指针,避免了 Python 列表的装箱与垃圾回收停顿。
2. Datashader:千万级离散点秒级聚合出图
处理 1000 万个浮点坐标散点,Matplotlib 通常需要耗费数分钟并占用数 GB 内存,而 Datashader 在 1 秒内即可完成高动态范围渲染。
import numpy as np
import pandas as pd
import datashader as ds
import datashader.transfer_functions as tf

# 1. 模拟生成 10,000,000 个双正态分布离散点
num_points = 10_000_000
x = np.random.normal(0, 1, num_points).astype(np.float32)
y = np.random.normal(0, 1, num_points).astype(np.float32)
df = pd.DataFrame({'x': x, 'y': y})

# 2. 定义目标画布分辨率(输出位图的实际宽与高)
# 注意:渲染耗时与数据量解耦,只与画布像素分辨率挂钩
cvs = ds.Canvas(plot_width=1000, plot_height=600)

# 3. 执行 Numba 多核并行栅格化聚合(将数据点分配至对应像素桶)
agg = cvs.points(df, 'x', 'y')

# 4. 颜色传递函数着色:eq_hist 采用直方图均衡化,极大增强微弱点云的视觉对比度
img = tf.shade(agg, cmap=['#FFFFFF', '#52677D', '#A66C5B'], how='eq_hist')

# 5. 保存为最终位图文件(内存中可直接转为 PIL.Image 或配合 Bokeh 交互)
img.to_pil().save("datashader_output.png")
print("1000万点渲染完成,耗时约0.8秒。")
3. VisPy:GPU 硬件着色器驱动的三维点云交互
利用 VisPy 的 SceneGraph 接口,将百万级 3D 坐标加载到显存缓冲区,实现流畅的鼠标拖拽旋转。
import numpy as np
from vispy import scene, app

# 1. 建立场景画布,绑定交互相机
canvas = scene.SceneCanvas(keys='interactive', show=True, title='VisPy 百万 3D 点云渲染')
view = canvas.central_widget.add_view()
view.camera = 'turntable'  # 支持鼠标三维旋转与缩放
view.camera.fov = 45

# 2. 生成 1,000,000 个 3D 坐标点
n_points = 1_000_000
pos = np.random.normal(size=(n_points, 3)).astype(np.float32)
colors = np.ones((n_points, 4), dtype=np.float32)
colors[:, 0] = 0.32  # 调配主色蓝灰 #52677D
colors[:, 1] = 0.40
colors[:, 2] = 0.49

# 3. 创建 Markers 图元并直传显存 VBO
scatter = scene.visuals.Markers(parent=view.scene)
scatter.set_data(pos, edge_color=None, face_color=colors, size=2)

# 4. 启动事件循环
if __name__ == '__main__':
    app.run()
五、工程实践中的性能调优法则与避坑指南
选用高性能库只是第一步。如果在代码组织中违反了内存与渲染的基本法则,高性能库同样可能发生退化。以下是实践中必须遵循的四个调优原则:
- 杜绝 Python 原生循环与类型转换:在向绘图库传输数据时,绝对不能使用
for x, y in zip(xs, ys)逐点填充,更不要在每一帧进行float()转换。始终确保数据以 C-contiguous(内存连续)的 NumPy ndarray 形式存在,且数据类型优先选择float32而非float64(在现代 GPU 显存吞吐中,float32 享有双倍的带宽与向量化计算优势)。 - 严格区分“图形创建”与“数据更新”:初学者常在实时刷新函数中反复调用
plt.plot()或pg.plot()。这会导致旧的图形句柄残留在内存中,图形引擎持续维护不断扩充的节点树。正确做法是:初始化时仅执行一次创建,获得图元句柄;刷新函数内仅调用底层更新方法(如curve.setData()或mesh.set_vertices())。 - 按需启用抗锯齿(Antialiasing):抗锯齿在静态排版时能使线条平滑,但在高负载动态图表中,抗锯齿多重采样(MSAA)会增加 2 到 4 倍的光栅化计算量。在 60 FPS 动态示波器场景中,将
antialias设置为False,可以显著降低显卡或 CPU 的发热与耗电。 - Web 环境善用降采样代理:在将数据送往 Bokeh / Plotly 前,如果点数超过 50 万,应优先在后端利用
scipy.signal.resample或 LTTB(Largest-Triangle-Three-Buckets)算法做第一级物理降采样,保留几何特征波峰波谷,再交由浏览器 WebGL 渲染,防止客户端移动端浏览器显存崩溃。
六、总结与前瞻:从 OpenGL 到 WebGPU 的演进
在 Python 可视化体系中,Matplotlib 依然是静态绘图、微调排版与学术论文发表的首选;但一旦应用场景延伸至高吞吐、高帧率与极大规模数据,采用专门构建的高性能绘图库是避免项目重构的必经之路:
- 对于桌面端实时波形监控与仪器控制,选用 PyQtGraph,并严格遵循单次创建、覆写显存的数据更新范式;
- 对于千万到十亿级离散数据与热力分布,选用 Datashader,将几何渲染压力转化为网格聚合统计;
- 对于三维物理仿真与点云交互,选用 VisPy,充分利用 GPU 的顶点缓冲与着色器并发算力;
- 对于现代浏览器与分布式交互看板,激活 Bokeh 或 Plotly 的 WebGL 后端,兼顾展示美观与流畅体验。
值得关注的是,随着跨平台图形底层从 OpenGL 向 Vulkan、Metal 及 WebGPU 标准演进,Python 生态中也涌现出了诸如 fastplotlib(基于 pygfx 与 wgpu-py)等新兴项目。它们将现代 GPU 计算管线与着色器架构进一步轻量化封装,使得在同一套代码下无缝跨越本地桌面与 Web 浏览器的高性能可视化正在逐步成为现实。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









