

Python构建CNN卷积神经网络教程:实现图像分类任务
本教程详细讲解如何使用Python与PyTorch从零构建CNN卷积神经网络,涵盖网络结构设计、卷积与池化原理、端到端训练与推理验证,配以完整代码与流程图示。
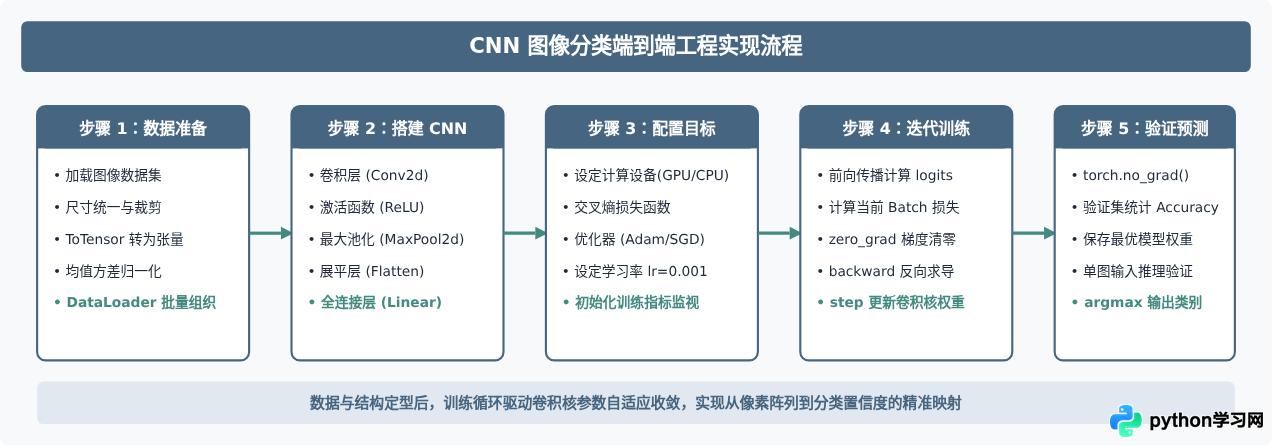
构建卷积神经网络(Convolutional Neural Network, CNN)实现图像分类的完整实现路径非常明确:首先准备图像数据并完成张量化与标准化,接着构建包含卷积层、激活函数、池化层与全连接分类器的网络结构,再配置损失函数与优化器进行多轮迭代训练,最后通过验证集评估并输出单张图片的类别预测结果。本文将基于主流的 Python 深度学习框架 PyTorch,带你完整实现这一端到端的工程流程。
一、CNN 核心组件与网络工作原理
传统的全连接神经网络(MLP)在处理二维图像时存在严重弊端:若将二维图像强行拉平成一维向量,不仅破坏了图像的空间邻域相关性,而且输入节点量随分辨率暴增,导致参数量呈爆炸式增长。卷积神经网络(CNN)通过局部感受野(Local Receptive Fields)、权值共享(Weight Sharing)和下采样(Downsampling)三大核心机制,高效提取图像特征并大幅压缩了参数空间。
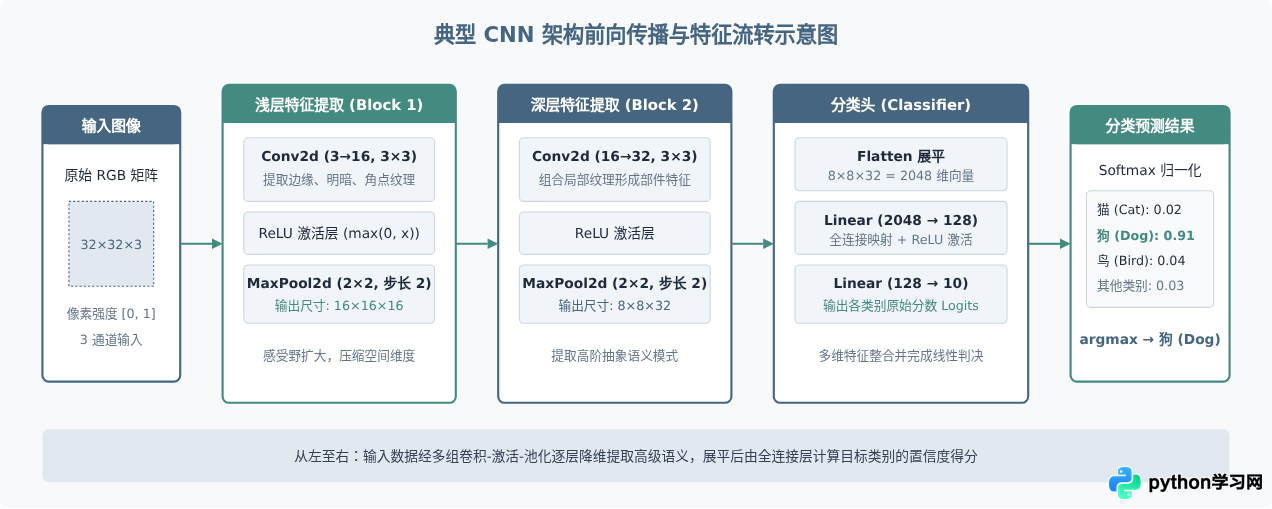
在一个标准的图像分类 CNN 架构中,主要包含以下四种基本层:
- 卷积层(Convolutional Layer):使用若干个小型权重矩阵(卷积核,如 3×3 或 5×5)在输入特征图上滑动,执行按元素相乘后求和的内积运算。每个卷积核学习一种特定的模式(如边缘、特定色彩对比或纹理)。
- 非线性激活层(Activation Layer):卷积本身是线性运算,多层线性运算叠加等价于单层线性映射。因此每层卷积后需引入 ReLU(Rectified Linear Unit)等非线性函数,保留正值并将负值置零,赋予网络拟合复杂分布的能力。
- 池化层(Pooling Layer):最常用的是最大池化(Max Pooling)。在感受野窗口内取最大值,既能压缩特征图的空间尺寸、减少后续参数量与计算开销,又能提供一定程度的平移不变性。
- 全连接分类层(Fully Connected Layer):当经过多级卷积与池化后,图像的空间信息已高度浓缩为高阶语义特征。展平(Flatten)为一维向量后,全连接层将其线性投影到分类数对应的向量空间。
二、卷积计算与输出尺寸变换原理
搭建 CNN 时的核心基本功是准确计算每一层卷积与池化之后的输出张量尺寸。如果尺寸计算有误,将直接导致全连接层输入维度不匹配而抛出报错。
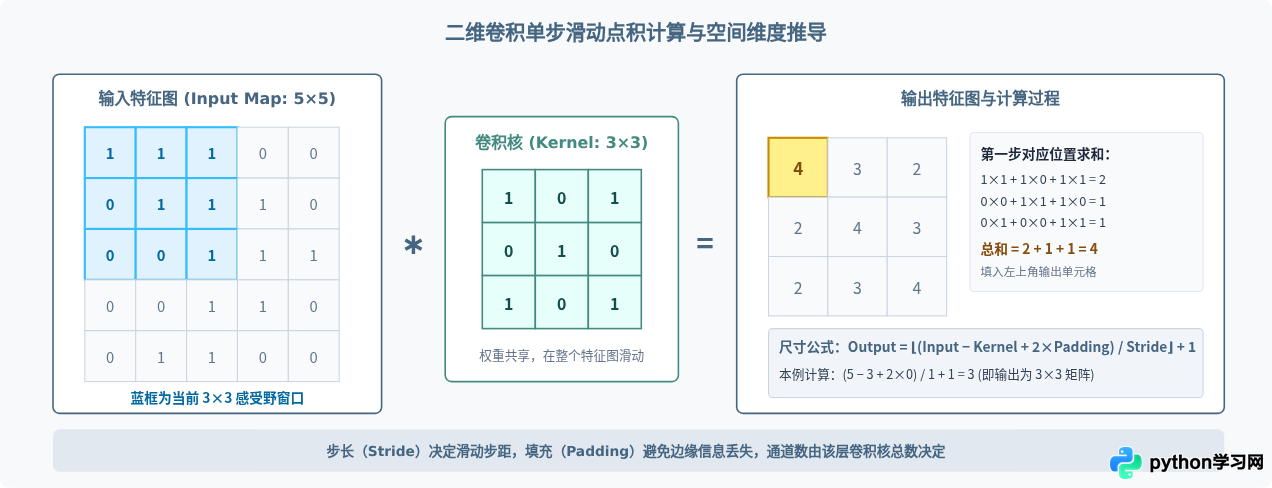
设输入空间宽度/高度为 $W_{in}$,卷积核边长为 $K$,两端填充数为 $P$,步长为 $S$。则输出尺寸为:
W_out = floor((W_in - K + 2 * P) / S) + 1
当采用 3×3 卷积(K=3),Padding=1,Stride=1 时,$(W - 3 + 2)/1 + 1 = W$,即输出与输入长宽完全一致(保持空间尺寸)。随后接一个 2×2 最大池化(Stride=2),尺寸变为原来的 1/2。掌握这一规律后,推算任意多层 CNN 的最终全连接输入尺寸便十分清晰。
三、基于 PyTorch 实现 CNN 图像分类实操
我们将使用广泛用于计算机视觉教学的 CIFAR-10 数据集 作为分类任务目标。该数据集包含 10 个类别(飞机、汽车、鸟、猫、鹿、狗、青蛙、马、船、卡车),每张图像为 32×32 像素的三通道彩色图。
1. 环境依赖配置
确保已安装 Python(推荐 3.9+)以及 PyTorch 和 torchvision 基础库:
pip install torch torchvision numpy2. 数据准备与预处理
图像加载过程中必须进行两步关键变换:transforms.ToTensor() 将 PIL 图像转换为 [0.0, 1.0] 区间且形状为 (C, H, W) 的 FloatTensor;transforms.Normalize() 将像素值中心化到标准化分布,加速模型梯度下降的收敛速度。
import torch
import torch.nn as nn
import torch.optim as optim
import torchvision
import torchvision.transforms as transforms

# 1. 设定图像预处理流水线
transform_train = transforms.Compose([
    transforms.RandomHorizontalFlip(), # 随机水平翻转,增强泛化能力
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010))
])

transform_test = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010))
])

# 2. 下载并加载 CIFAR-10 数据集
batch_size = 64

train_dataset = torchvision.datasets.CIFAR10(
    root='./data', train=True, download=True, transform=transform_train
)
train_loader = torch.utils.data.DataLoader(
    train_dataset, batch_size=batch_size, shuffle=True, num_workers=2
)

test_dataset = torchvision.datasets.CIFAR10(
    root='./data', train=False, download=True, transform=transform_test
)
test_loader = torch.utils.data.DataLoader(
    test_dataset, batch_size=batch_size, shuffle=False, num_workers=2
)

classes = ('plane', 'car', 'bird', 'cat', 'deer', 'dog', 'frog', 'horse', 'ship', 'truck')
3. 定义 CNN 网络结构
我们设计一个经典的双卷积块网络。输入为 (3, 32, 32) 的彩色图像,经过两次“卷积-激活-池化”降采样,尺寸由 32×32 降至 16×16 再降至 8×8,通道数由 3 提升至 16 再提升至 32。最后展开为一维向量输入全连接层完成 10 分类:
class SimpleCNN(nn.Module):
    def __init__(self, num_classes=10):
        super(SimpleCNN, self).__init__()

        # 卷积块 1:输入 3 通道,输出 16 通道,卷积核 3x3,padding 1
        # 输入尺寸:(3, 32, 32) -> 卷积后仍为 (16, 32, 32) -> 池化后变为 (16, 16, 16)
        self.conv_block1 = nn.Sequential(
            nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1),
            nn.BatchNorm2d(16),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2)
        )

        # 卷积块 2:输入 16 通道,输出 32 通道,卷积核 3x3,padding 1
        # 输入尺寸:(16, 16, 16) -> 卷积后仍为 (32, 16, 16) -> 池化后变为 (32, 8, 8)
        self.conv_block2 = nn.Sequential(
            nn.Conv2d(in_channels=16, out_channels=32, kernel_size=3, padding=1),
            nn.BatchNorm2d(32),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2)
        )

        # 分类器头(全连接层)
        # 展平维度:32 通道 * 8 * 8 = 2048
        self.classifier = nn.Sequential(
            nn.Flatten(),
            nn.Linear(32 * 8 * 8, 128),
            nn.ReLU(),
            nn.Dropout(p=0.3), # 随机失活 30% 节点,抑制过拟合
            nn.Linear(128, num_classes)
        )

    def forward(self, x):
        x = self.conv_block1(x)
        x = self.conv_block2(x)
        logits = self.classifier(x)
        return logits
4. 损失函数、优化器与模型训练循环
多分类任务标准配置为交叉熵损失函数(CrossEntropyLoss),该损失函数在 PyTorch 中内部整合了 LogSoftmax 与 NLLLoss,因此网络最后一层直接输出原始 logits 即可,无需在模型末尾手动加 Softmax。优化器选用自适应学习率的 Adam。
# 设备配置(优先选择 GPU)
device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
print(f"使用设备: {device}")

model = SimpleCNN(num_classes=10).to(device)
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=0.001)

# 训练轮次
num_epochs = 10

for epoch in range(num_epochs):
    model.train() # 切换为训练模式
    running_loss = 0.0
    correct = 0
    total = 0

    for i, (inputs, labels) in enumerate(train_loader):
        inputs, labels = inputs.to(device), labels.to(device)

        # 1. 梯度清零
        optimizer.zero_grad()

        # 2. 前向传播
        outputs = model(inputs)
        loss = criterion(outputs, labels)

        # 3. 反向传播与参数更新
        loss.backward()
        optimizer.step()

        # 统计批次结果
        running_loss += loss.item()
        _, predicted = torch.max(outputs.data, 1)
        total += labels.size(0)
        correct += (predicted == labels).sum().item()

    epoch_acc = 100.0 * correct / total
    avg_loss = running_loss / len(train_loader)
    print(f"Epoch [{epoch+1}/{num_epochs}] - Loss: {avg_loss:.4f} - 训练准确率: {epoch_acc:.2f}%")
5. 模型测试评估与单图预测推理
在测试集上评估模型的泛化性能。在评估阶段,必须显式调用 model.eval() 并使用 with torch.no_grad() 关闭自动求导机制,以节省显存开销并固定 BatchNorm 和 Dropout 的行为:
def evaluate_model(model, test_loader, device):
    model.eval() # 切换至评估模式
    correct = 0
    total = 0
    with torch.no_grad():
        for images, labels in test_loader:
            images, labels = images.to(device), labels.to(device)
            outputs = model(images)
            _, predicted = torch.max(outputs, 1)
            total += labels.size(0)
            correct += (predicted == labels).sum().item()

    accuracy = 100.0 * correct / total
    print(f"测试集整体分类准确率: {accuracy:.2f}%")
    return accuracy

evaluate_model(model, test_loader, device)

# 保存训练好的模型权重
torch.save(model.state_dict(), 'simple_cnn_cifar10.pth')
print("模型权重已保存至 simple_cnn_cifar10.pth")
完成模型保存后,可以通过以下函数加载权重,并对任意单张外部输入图片执行推断:
from PIL import Image

def predict_single_image(image_path, model_path, device, classes):
    # 实例化网络结构并加载权重
    net = SimpleCNN(num_classes=len(classes)).to(device)
    net.load_state_dict(torch.load(model_path, map_location=device))
    net.eval()

    # 保持与测试集完全一致的预处理
    img = Image.open(image_path).convert('RGB')
    preprocess = transforms.Compose([
        transforms.Resize((32, 32)),
        transforms.ToTensor(),
        transforms.Normalize((0.4914, 0.4822, 0.4465), (0.2023, 0.1994, 0.2010))
    ])

    # 扩展 batch 维度:(3, 32, 32) -> (1, 3, 32, 32)
    tensor = preprocess(img).unsqueeze(0).to(device)

    with torch.no_grad():
        output = net(tensor)
        probabilities = torch.softmax(output, dim=1)
        confidence, predicted_idx = torch.max(probabilities, 1)

    predicted_class = classes[predicted_idx.item()]
    print(f"预测类别: {predicted_class} (置信度: {confidence.item():.4f})")
    return predicted_class
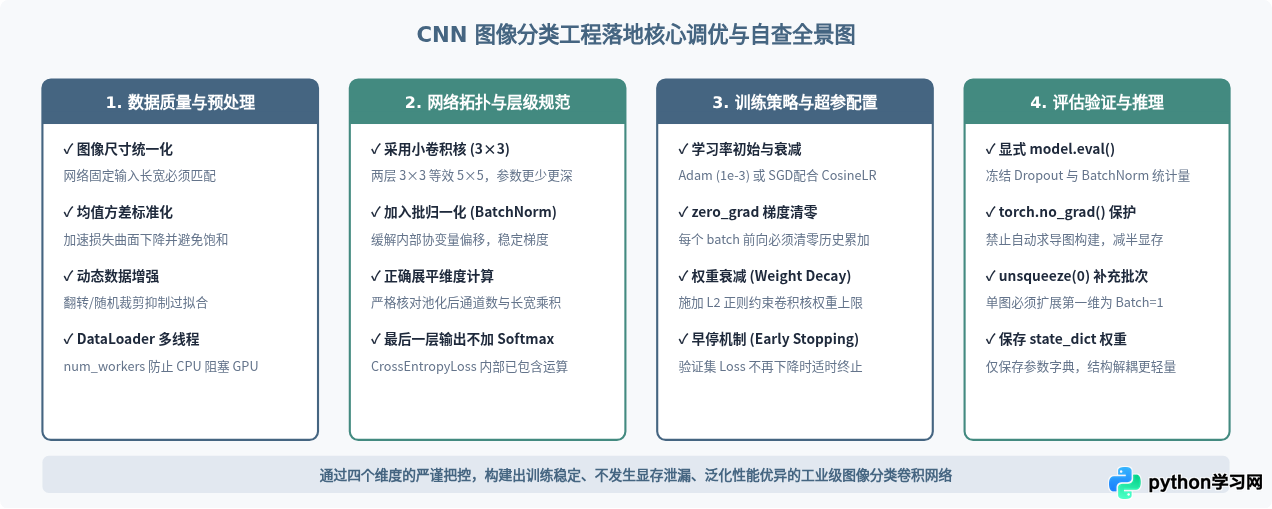
四、常见问题排查与工程调优清单
初学者在构建 CNN 图像分类网络时,往往会遇到以下典型问题:
- 问题 1:全连接层报形状不匹配错误(RuntimeError: mat1 and mat2 shapes cannot be multiplied)。
原因:卷积层与池化层交替处理后,未能精准计算展平后的神经元数量。
解决办法:在定义forward函数时,临时加入print(x.shape)打印展平前的张量维度;或直接利用 PyTorch 官方提供的自适应平均池化nn.AdaptiveAvgPool2d((1, 1))替代传统多维展平,彻底规避尺寸耦合问题。 - 问题 2:训练集 Accuracy 不断上升,但测试集准确率停滞甚至下降(过拟合)。
原因:模型参数量相对于训练样本规模过大,记住了训练集噪声。
解决办法:在全连接层前增加nn.Dropout(0.3~0.5);在卷积块中加入nn.BatchNorm2d;并在训练数据流水线中增加RandomCrop、RandomRotation和颜色抖动等数据增强手段。 - 问题 3:损失值(Loss)变成 NaN 或完全不下降。
原因:学习率过大导致权重震荡溢出;或者数据未执行标准化导致数值范围过大。
解决办法:将学习率降低一个数量级(例如从 0.01 降到 0.001 或 0.0003);检查输入张量是否包含无效值(如全零或非数字),务必使用Normalize规范化输入。
五、总结与进阶方向
通过本文的实操,我们理清了使用 Python 构建 CNN 实现图像分类的核心全貌:从图像预处理、二维卷积与池化计算、前向网络定义,到反向传播训练、验证集评估及单图预测。
当你的分类任务变得更为复杂(例如上百种高分辨率图像分类)时,手动堆叠的基础 CNN 会面临梯度消失与表达能力瓶颈。在此基础上,你可以进一步尝试:
- 引入残差连接(ResNet):通过跨层跳跃连接解决网络深度增加时的退化问题;
- 使用预训练模型与迁移学习(Transfer Learning):借助
torchvision.models中在 ImageNet 上训练好的成熟骨干网络(如 ResNet50、EfficientNet),微调最后的全连接层,在小样本场景下快速获得高准确率; - 学习率调度器(LRScheduler):在训练中期引入 Cosine 退火或 StepLR,让模型在后期能够更平稳地落在损失曲面的极小值盆地。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









