

企业使用AI翻译会泄露数据吗?隐私安全指南
本文解析企业使用AI翻译时的数据隐私风险,从输入脱敏、账户类型确认、数据留存政策到译文保存规范,提供全流程安全操作指南,帮助员工和管理者建立正确的数据安全边界。
在线翻译工具让跨语言协作变得高效,但把内部文档直接粘贴进网页框之前,需要看清数据走过的路径。能顺利返回译文,不代表这条数据流已经符合公司的保密要求。风险往往不来自工具本身是否“有名”,而来自实际使用的服务版本、账户权限以及数据处理条款的差异。
概述:先画清内容经过哪些位置
一份文档从员工电脑上传到翻译服务,再下载到本地,至少涉及输入文件、服务端处理和译文保存三个位置。若从网盘导入、通过浏览器扩展提交,或把结果继续同步给协作平台,还会增加其他参与方。
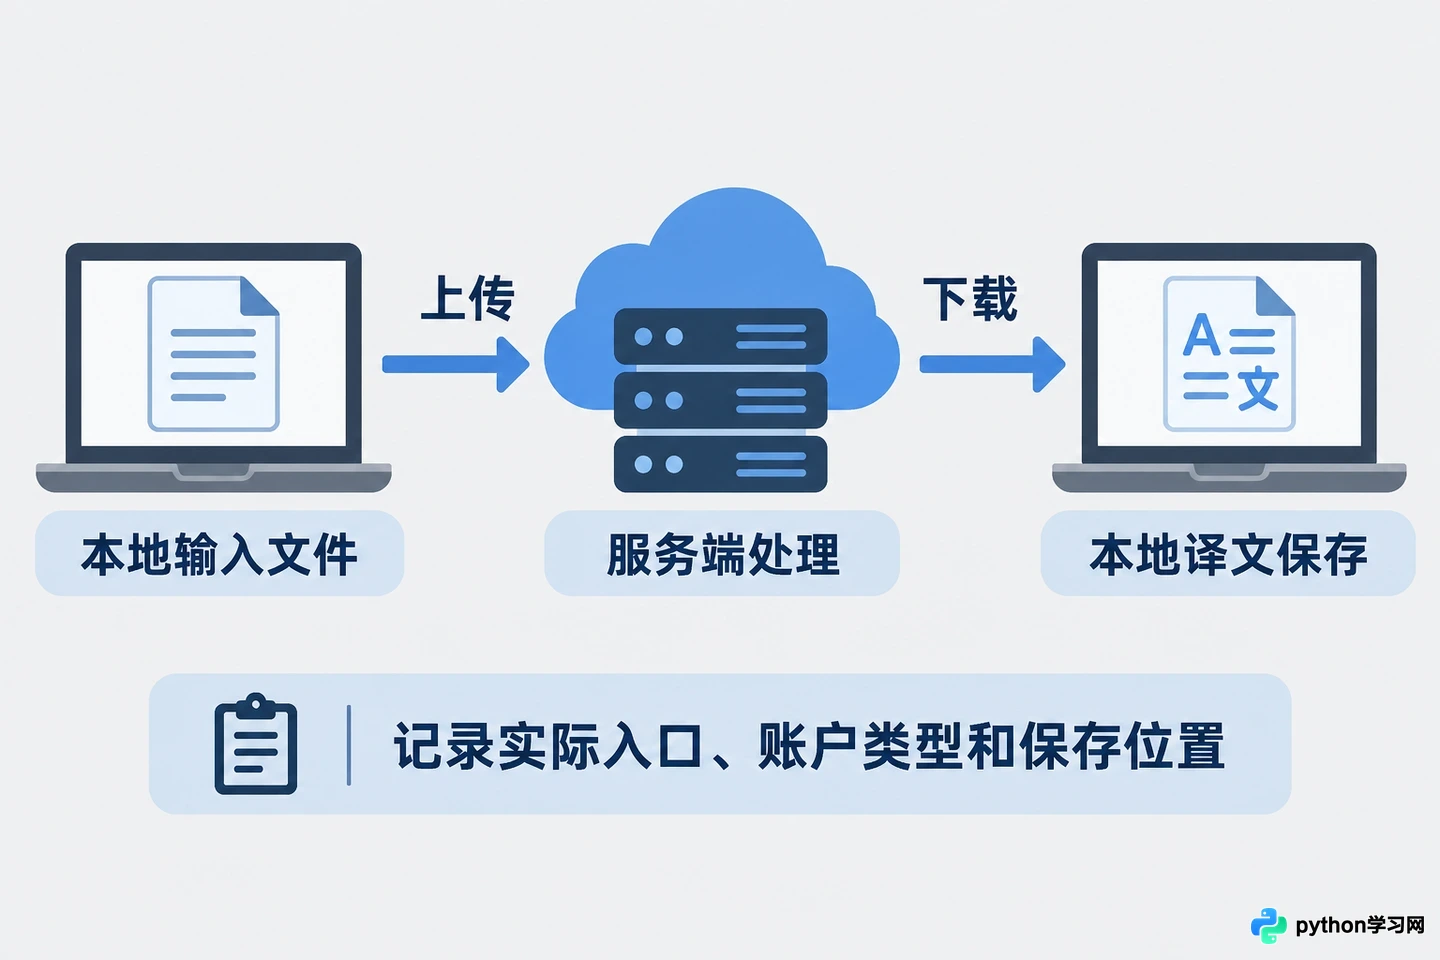
数据从本地输入到服务端处理再返回的全流程示意
因此,排查隐私风险时,应记录实际入口和账户类型。相同品牌的免费网页、付费服务、API与语音产品可能有不同的数据处理规则,不能把某一个产品的承诺自动套到其他入口。
关于输入区域:只提交确实需要翻译的内容
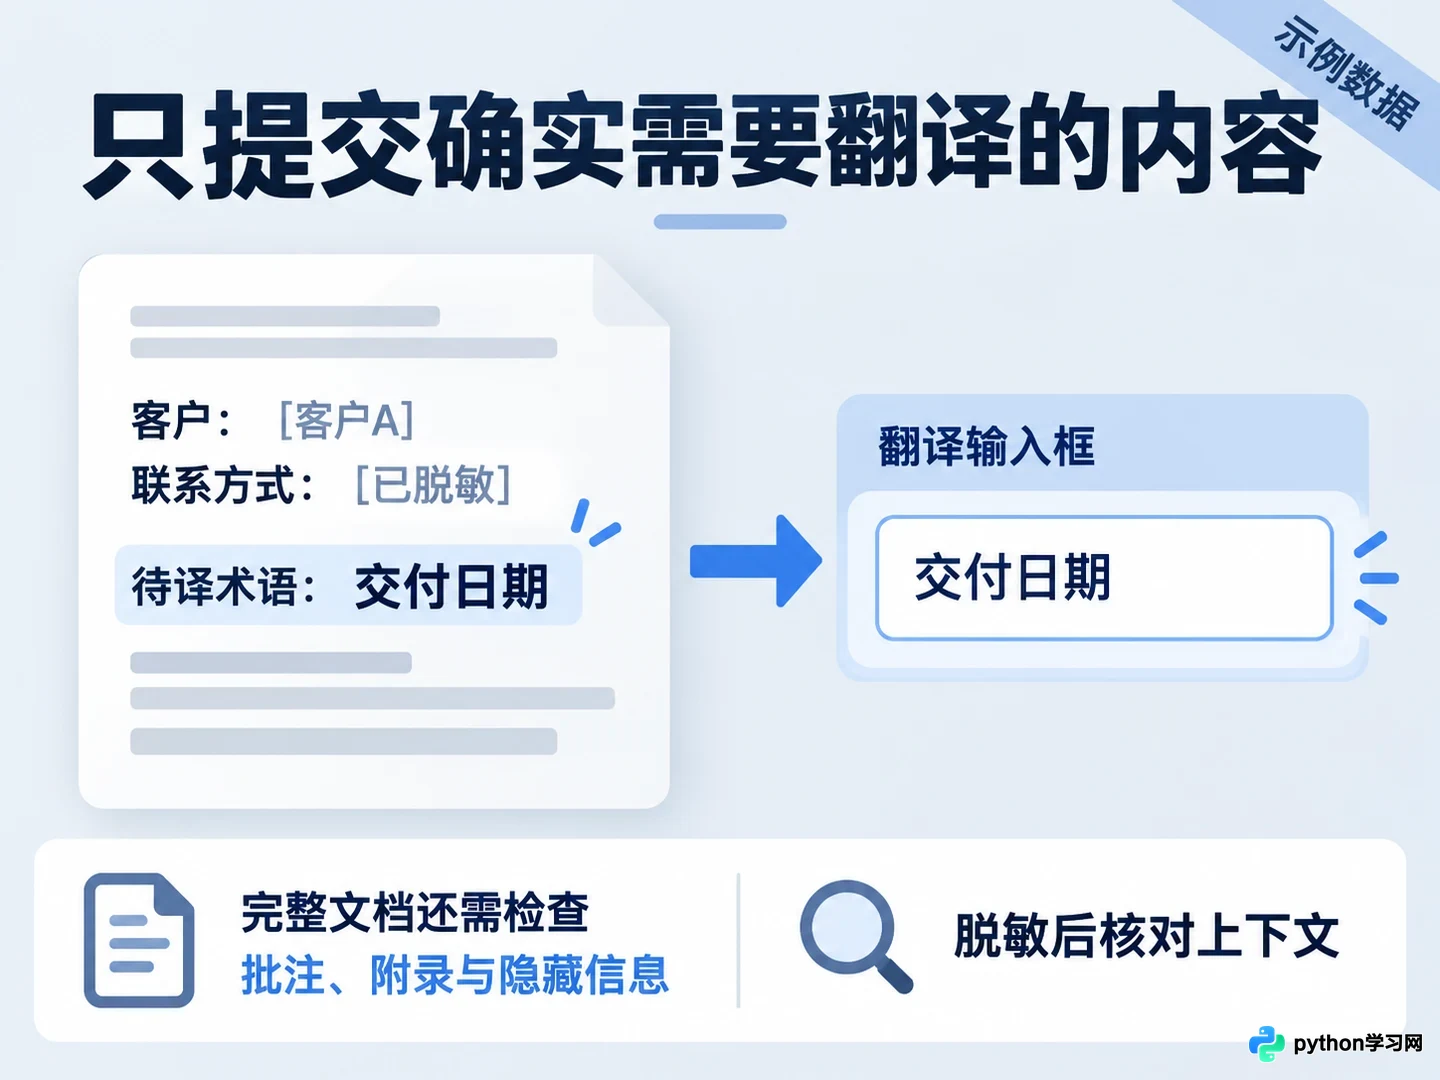
在将文字粘贴到翻译框或上传文件前,先检查其中是否包含客户姓名、联系方式、内部账号、未公开方案和其他受限制资料。文档上传还要考虑正文之外的批注、附录或隐藏信息,不能只检查第一页看起来是否敏感。
如果当前任务只需确认某个术语,可以提交不含业务细节的短句;如果确实需要完整文档,先按企业已有规则确认该类资料可以使用哪个服务。对原文进行必要脱敏后,还要检查替换是否破坏上下文,避免译文中的指代与对象对应错误。
关于输入区域:只提交确实需要翻译的内容
关于账户区域:确认使用的是哪一种服务
以 DeepL 为例,其公开隐私政策明确区分了不同服务的文本处理规则。免费服务会在有限时间内处理上传内容及译文,用于训练和改进模型;而 Translator Pro、API Pro 等付费专业服务的文本则不用于改进其服务质量。
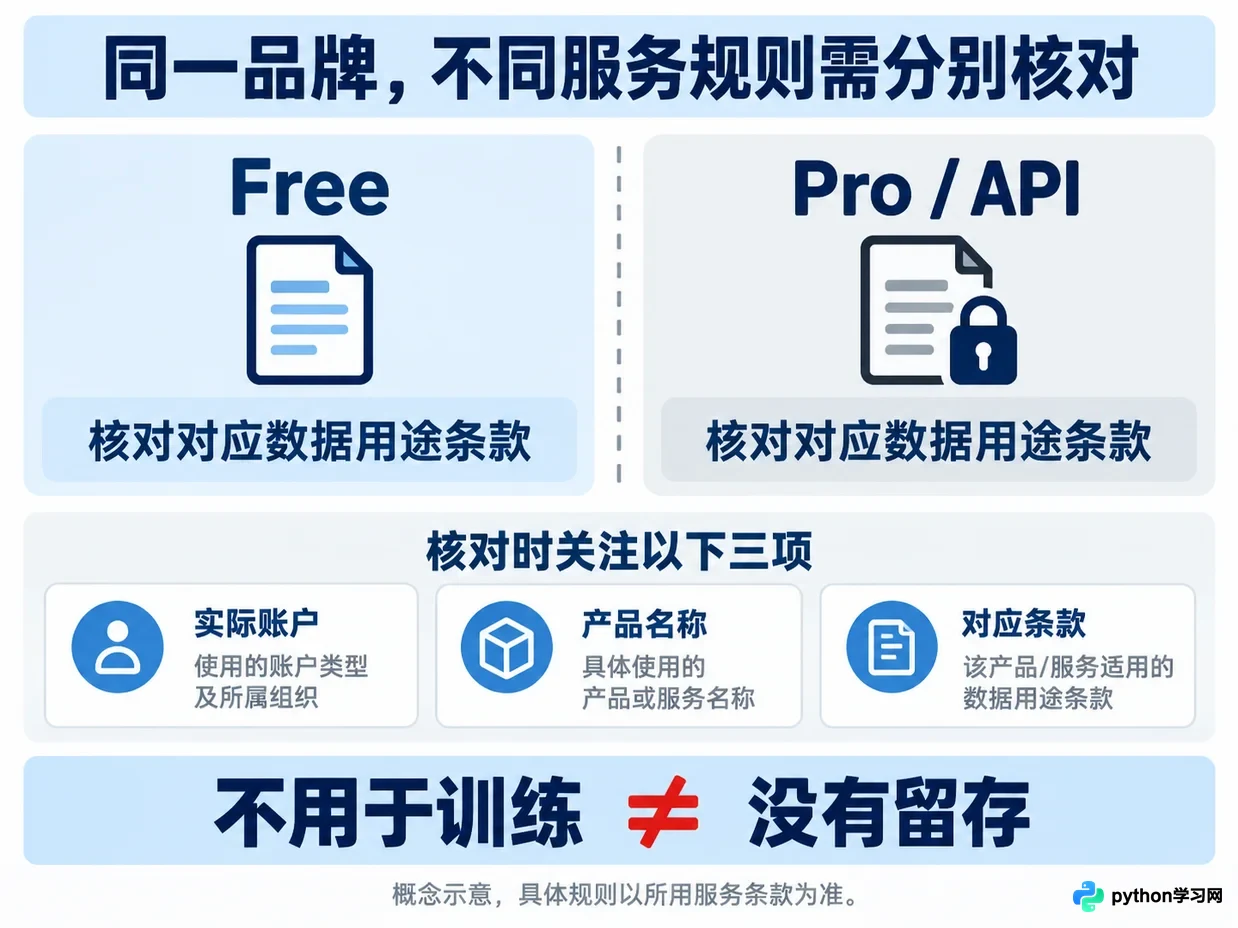
不同服务版本的数据处理政策差异
这说明“同一家厂商”并不等于“同一种数据用途”。判断时应让实际账户、产品名称与对应条款一致,而不是仅凭员工有一个付费账号,就假设所有扩展、API或临时网页会话都采用相同保护。使用前还要确认组织是否为该服务建立了相应的数据处理安排(DPA)。
关于保存区域:不用于训练与没有留存不同
“不用于训练”回答的是数据用途问题,“保存多久”回答的是留存问题,“谁可以访问”又是权限问题。这几个问题应分开核对。即使服务对提交文本采用临时处理,也不应据此推断账户资料、使用记录和其他数据全部从未保存。
企业应针对自己使用的产品核对内容保留、删除方式、处理位置、分包方以及访问控制说明。没有在设置界面看到保存记录,并不能证明后台没有任何处理记录;找不到明确说明时,应向供应商确认,不能把空白当成零风险。
关于输出区域:译文也可能包含敏感信息
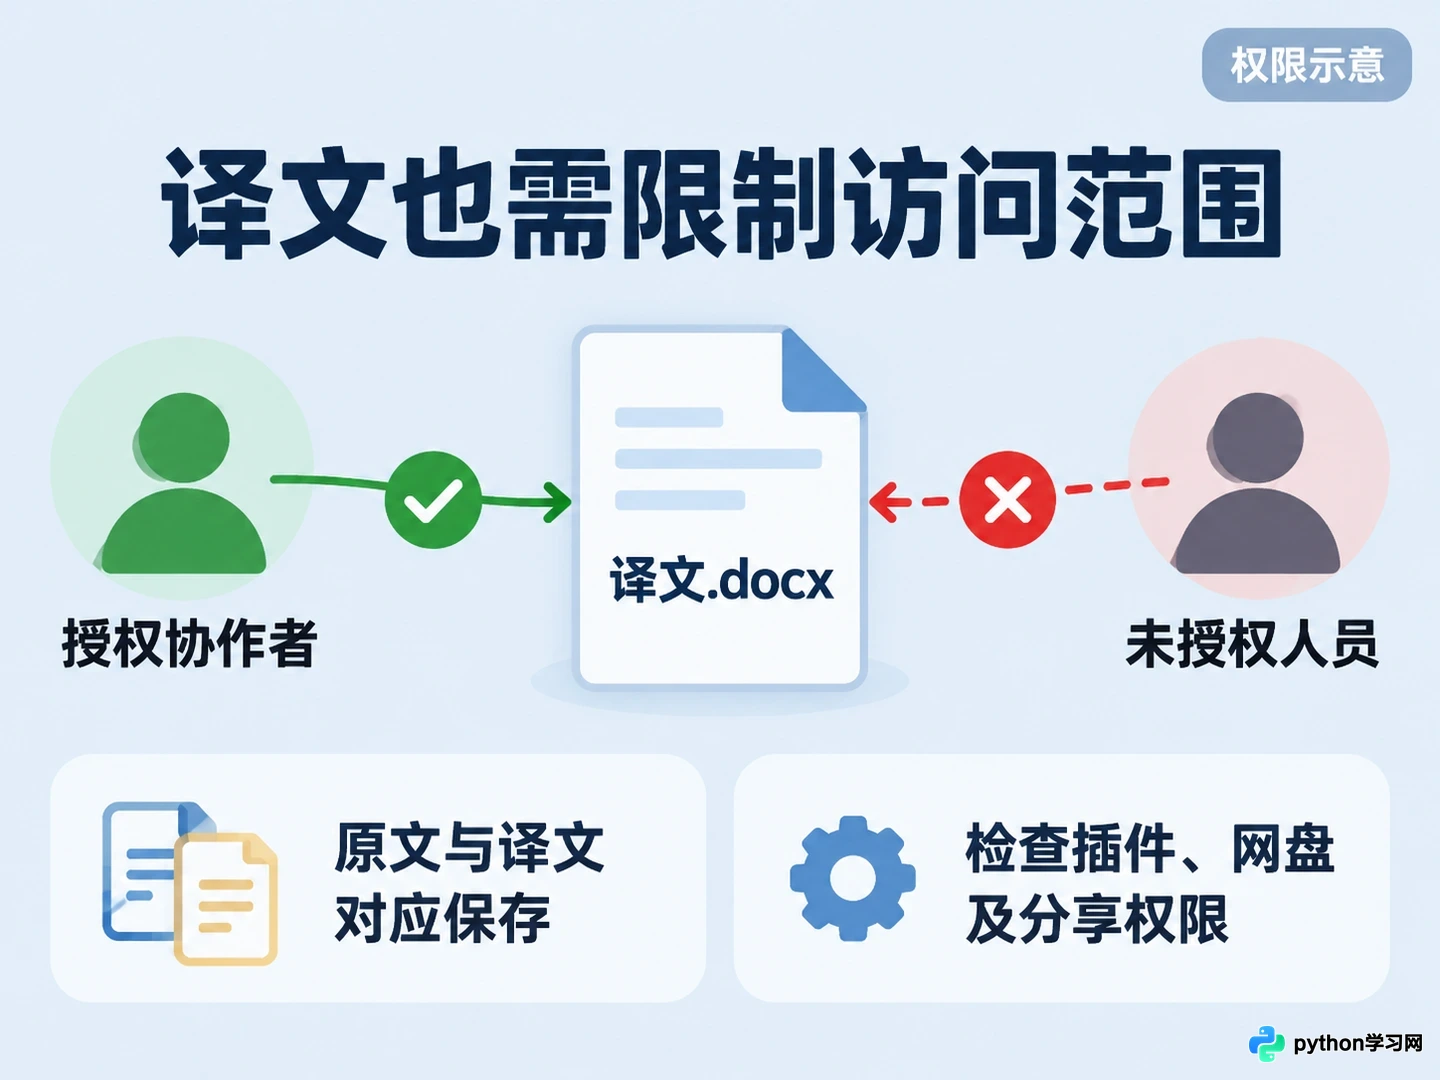
翻译成另一种语言不会自动消除保密属性。包含客户资料或内部策略的译文,仍应保存到与原文相适应的位置。不要为了方便审校,把完整译文再复制到未经批准的公开协作页面,或者通过开放分享链接分发。
译文文件的存储与协作权限设置
核对结果时,可以把原文与译文对应保存,并限定协作者范围。若使用第三方插件或网盘导入,还应检查授权对象和权限范围,确认离开项目的人员不再保有相关访问权。
关于异常处置:按实际数据流定位影响
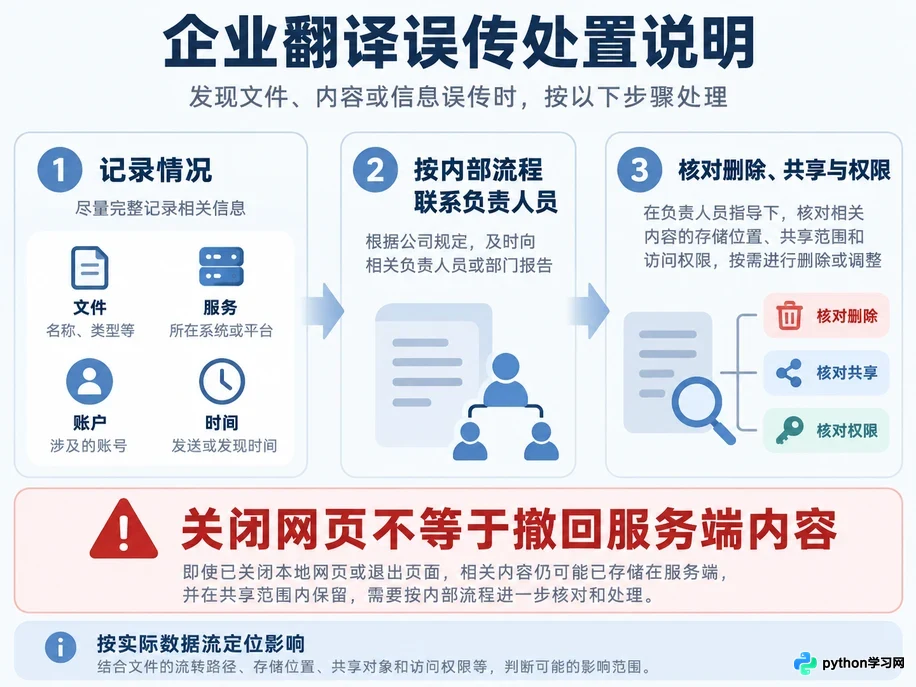
发现误传敏感数据时,先记录涉及的文件、服务、账户和提交时间,再按企业内部流程联系负责人员,核对是否能够删除内容、撤回共享或调整权限。不能因为已经关闭网页,就认定服务端内容已被撤回。
最终的可用范围应落实为员工能执行的规则:哪些资料可直接翻译,哪些需要脱敏,哪些只能进入指定环境。供应商条款或组织配置发生变化时,再检查原有规则是否仍与实际处理方式一致。
关于异常处置:按实际数据流定位影响
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









