

《Python程序设计(第3版)》课后习题参考答案与解析
《Python程序设计(第3版)》核心章节课后典型习题参考答案与深度解析,涵盖基础语法、循环分支、组合数据类型、函数递归、文件操作与面向对象编程,提供规范代码与避坑指南。
第一部分:基础语法与流程控制典型习题
基础语法篇重点考查变量命名规范、内置数值运算、分支判断(if-elif-else)以及循环控制(for与while)的边界条件处理。
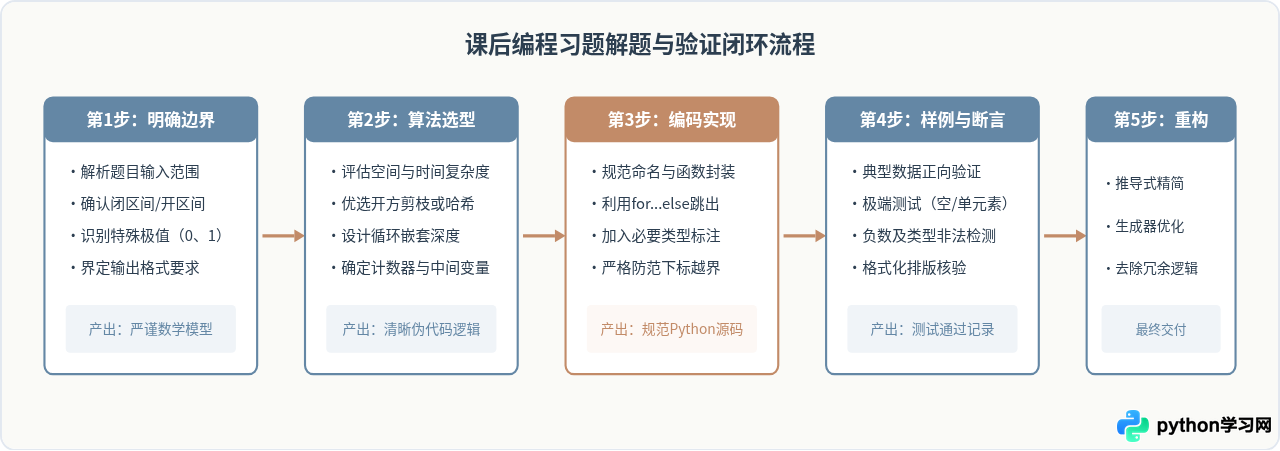
习题1.1:区间内素数(质数)筛选与格式化输出
题目要求:编写程序,输出 100 到 200 之间的所有素数,每行输出 5 个,数之间用空格分隔,并统计素数的总个数。
解题分析:判断正整数 \(n\) 是否为素数,仅需检测是否存在满足 \(2 \le d \le \lfloor\sqrt{n}\rfloor\) 的因数。使用 math.isqrt(n) 或 int(n ** 0.5) 可将时间复杂度从 \(O(n)\) 优化至 \(O(\sqrt{n})\)。在循环中配合 for...else 结构能够写出极具 Python 风格且清晰的因数排查逻辑。
import math

def find_primes(start=100, end=200, per_line=5):
    primes = []
    for num in range(start, end + 1):
        if num < 2:
            continue
        # 仅遍历至平方根整数即可判定素数
        limit = math.isqrt(num)
        for factor in range(2, limit + 1):
            if num % factor == 0:
                break
        else:
            # 循环正常结束未触发 break,说明是素数
            primes.append(num)

    # 格式化分行输出
    for i, prime in enumerate(primes):
        print(f"{prime:4d}", end=" ")
        if (i + 1) % per_line == 0:
            print()
    if len(primes) % per_line != 0:
        print()

    print(f"统计:{start} 到 {end} 之间共有 {len(primes)} 个素数。")

# 执行示例
find_primes(100, 200)
for...else 语法中的 else 块仅在循环遍历完整且未遭遇 break 时执行。初学者常误将 else 与 if 对齐,导致判断单个因数失败后立即误判该数为素数。
第二部分:组合数据类型高频习题解析
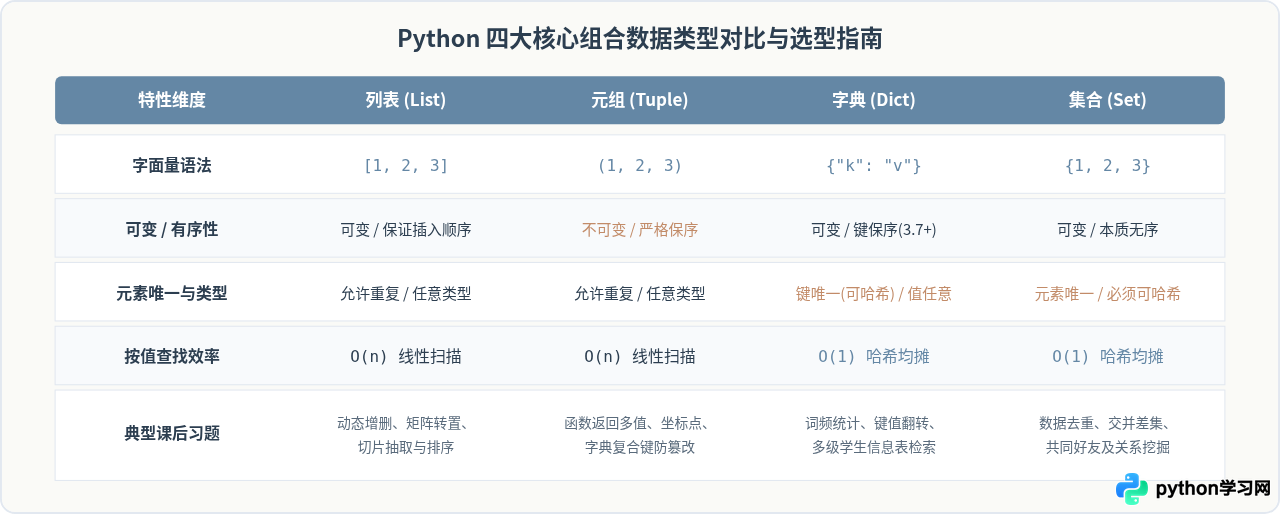
组合数据类型是《Python程序设计(第3版)》的教学重中之重,要求熟练掌握列表(list)、元组(tuple)、字典(dict)和集合(set)的操作及底层特征。
习题2.1:英文文本词频统计与降序输出
题目要求:给定一段英文文本,统计其中各个单词的出现次数,过滤标点符号,忽略大小写,并输出出现频率最高的前 5 个单词及其频次。
import string

def count_word_frequency(text, top_k=5):
    # 步骤1:清洗文本,去除所有标点符号并转为小写
    translator = str.maketrans("", "", string.punctuation)
    clean_text = text.translate(translator).lower()

    # 步骤2:拆分单词并借助字典统计频次
    words = clean_text.split()
    freq_dict = {}
    for word in words:
        freq_dict[word] = freq_dict.get(word, 0) + 1

    # 步骤3:按频次降序排序(lambda 提取值)
    sorted_freq = sorted(freq_dict.items(), key=lambda item: item[1], reverse=True)

    # 步骤4:展示前 top_k 项
    print(f"Top {top_k} 词频统计结果:")
    for word, count in sorted_freq[:top_k]:
        print(f"{word:<15} : {count} 次")

    return sorted_freq[:top_k]

# 测试样例
sample_text = """
Python is an interpreted, high-level, general-purpose programming language.
Python's design philosophy emphasizes code readability. Python is widely used.
"""
count_word_frequency(sample_text, top_k=3)
原理说明:text.translate() 结合 str.maketrans() 在底层使用 C 级别字符映射表,执行效率远高于连续调用多次 replace()。dict.get(key, default) 优雅地处理了键首次出现的默认值赋值,避免了显式的 if key in dict 检查。
第三部分:函数设计、递归与参数机制
函数部分常考查默认参数的可变对象陷阱、可变长位置与关键字参数(*args, **kwargs)、高阶函数以及递归基准条件的设计。
习题3.1:嵌套列表完全展平(递归实现)
题目要求:编写一个递归函数 flatten_list(nested),将任意深度的嵌套列表展平为一个单层扁平列表。例如输入 [1, [2, [3, 4], 5], [[6]], 7],返回 [1, 2, 3, 4, 5, 6, 7]。
def flatten_list(nested):
    result = []
    for item in nested:
        # 判断当前元素是否为可迭代列表(排除字符串等基础类型)
        if isinstance(item, list):
            # 递归深入并将展开的子列表延伸进结果集
            result.extend(flatten_list(item))
        else:
            result.append(item)
    return result

# 验证测试
raw_data = [1, [2, [3, 4], 5], [[6]], 7]
print("原始嵌套:", raw_data)
print("展平结果:", flatten_list(raw_data))
def bad_func(item, acc=[]) 这种带有可变默认参数的形式!在 Python 中,函数默认参数在模块加载时只被求值一次。若使用默认列表累积数据,多次调用该函数将共享同一个列表实例,造成极其隐蔽的状态污染 Bug。
第四部分:文件操作与异常处理
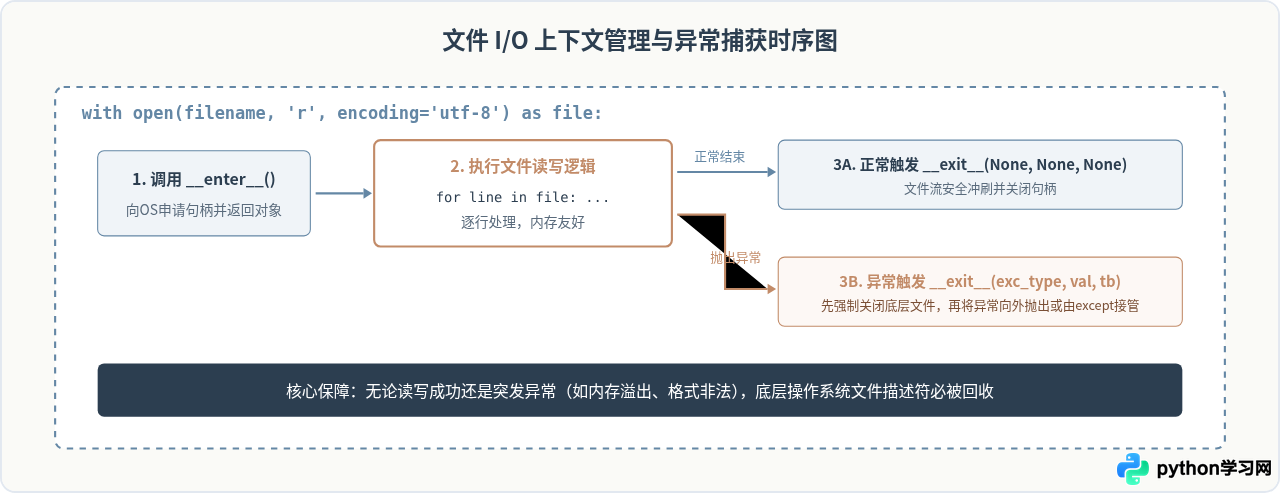
高校教材中文件章节普遍围绕文本文件与 CSV 文件的读取、清洗与保存展开。标准答案必须严格遵循 with 上下文管理语法,以确保在读写出现异常时操作系统资源能被百分之百安全释放。
习题4.1:学生信息 CSV 文件汇总与平均分计算
题目要求:有一文本文件 scores.csv,内容格式为“学号,姓名,语文,数学,英语”。编写程序读取文件数据,计算每位学生的总分与平均分,并将包含总分、平均分的新记录写入 report.csv 文件中。
import csv

def generate_score_report(input_file="scores.csv", output_file="report.csv"):
    try:
        # 打开输入与输出文件,newline='' 是处理 CSV 换行的关键参数
        with open(input_file, mode="r", encoding="utf-8") as f_in, \
             open(output_file, mode="w", encoding="utf-8", newline="") as f_out:

            reader = csv.reader(f_in)
            writer = csv.writer(f_out)

            # 读取并更新表头
            header = next(reader, None)
            if not header:
                print("错误:源数据文件为空!")
                return

            new_header = header + ["总分", "平均分"]
            writer.writerow(new_header)

            valid_count = 0
            for row in reader:
                if not row:
                    continue
                sid, name, chinese, math, english = row[0], row[1], float(row[2]), float(row[3]), float(row[4])
                total = chinese + math + english
                avg = round(total / 3.0, 2)

                # 写入包含衍生指标的完整记录
                writer.writerow([sid, name, chinese, math, english, total, avg])
                valid_count += 1

        print(f"成绩报告生成完毕,成功处理 {valid_count} 条记录,已保存至 {output_file}。")

    except FileNotFoundError:
        print(f"文件读取失败:无法在指定路径找到 {input_file}。")
    except ValueError as e:
        print(f"数据解析异常:成绩字段包含非数字内容,详情:{e}")
    except Exception as e:
        print(f"系统运行发生未知异常:{e}")

# 执行函数
# generate_score_report("scores.csv", "report.csv")
第五部分:面向对象编程(OOP)核心习题
面向对象习题侧重考查类定义、属性封装、@property 装饰器以及特殊方法(魔术方法如 __str__、__repr__、__eq__)的正确重载。
习题5.1:自定义银行账户类(封装与安全性验证)
题目要求:设计一个 BankAccount 类,具备账号(只读)、账户名和余额三个属性。提供存款 deposit(amount) 和取款 withdraw(amount) 方法。取款时需验证余额是否充足,不允许将余额透支为负数;所有金额变动需有明确的布尔值返回和状态提示。
class BankAccount:
    """银行账户实体类"""

    def __init__(self, account_no: str, owner: str, initial_balance: float = 0.0):
        if initial_balance < 0:
            raise ValueError("开户初始金额不能为负数")
        self._account_no = account_no       # 受保护属性(对外只读)
        self.owner = owner                  # 账户名(公有)
        self._balance = float(initial_balance) # 余额(内部维护)

    @property
    def account_no(self) -> str:
        """只读账号属性"""
        return self._account_no

    @property
    def balance(self) -> float:
        """只读余额属性"""
        return self._balance

    def deposit(self, amount: float) -> bool:
        """存款方法"""
        if amount <= 0:
            print("存款操作失败:存入金额必须大于零")
            return False
        self._balance += amount
        print(f"成功存入 ¥{amount:.2f},当前可用余额:¥{self._balance:.2f}")
        return True

    def withdraw(self, amount: float) -> bool:
        """取款方法"""
        if amount <= 0:
            print("取款操作失败:取款金额必须大于零")
            return False
        if amount > self._balance:
            print(f"取款失败:账户余额不足(当前余额:¥{self._balance:.2f})")
            return False
        self._balance -= amount
        print(f"成功取出 ¥{amount:.2f},剩余余额:¥{self._balance:.2f}")
        return True

    def __str__(self) -> str:
        return f"<BankAccount 账号: {self._account_no} | 户名: {self.owner} | 余额: ¥{self._balance:.2f}>"

# 验证测试
if __name__ == "__main__":
    acc = BankAccount("622202001", "张同学", 500.0)
    print(acc)
    acc.deposit(200.0)
    acc.withdraw(800.0)  # 测试超额取款
    acc.withdraw(450.0)  # 测试正常取款
    print("最终状态:", acc)
第六部分:知识体系与答题能力全景总结
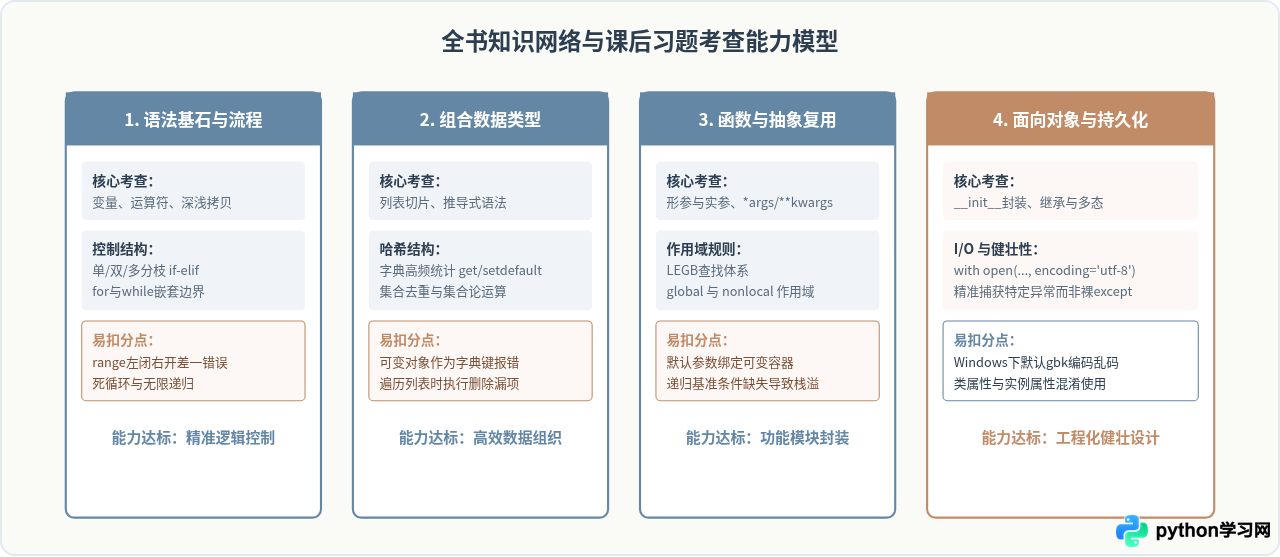
为了让读者在期末复习或自学考核中更高效地抓住核心采分点,下方梳理了《Python程序设计(第3版)》全书知识点层级与解题能力要求全景图。
总结与练习建议
完成《Python程序设计(第3版)》课后习题的关键在于从“看懂代码”跨越到“独立手写且无语法瑕疵”。读者在日常练习时,建议遵循以下三项基本原则:
- 拒绝盲目拷贝:先在纸上或注释中理清流程分支与循环边界,再编写完整代码;
- 重视异常边界:编写完功能后,主动代入空输入、负数、越界索引等极端用例验证代码健壮性;
- 坚持规范风格:严格遵守 PEP 8 命名规范,多利用推导式、切片、上下文管理器等 Python 原生语法特性,逐步写出优雅、高效的标准程序。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









