

大模型应用开发实战:怎么降低Token消耗并提升响应速度
本文针对大模型应用开发中的成本与性能痛点,从缓存机制、流式输出及上下文管理三个维度提供具体优化策略。通过设置合理的TTL缓存、启用SSE流式传输以及实施滑动窗口和摘要压缩,帮助开发者在不牺牲智能度的前提下,显著降低Token消耗并提升用户感知的响应速度。
每次看着后台账单上跳动的 Token 数字,或者听到用户抱怨“怎么转圈这么久还没出字”,大概是做 AI 应用开发时最让人头秃的两个瞬间。明明功能逻辑没变,为什么随着用户量上来,成本指数级增长,体验却反而下降了?
其实,很多时候不是模型不够快,而是我们的调用方式太“实诚”了。把每一句话都原封不动地扔给大模型,既浪费钱又拖慢速度。今天咱们不聊复杂的模型蒸馏,就聊聊在应用层能立刻动手的三个设置:缓存、流式输出和上下文管理。
别让相同的问题重复计费
很多用户的问题其实是高度重复的。比如客服场景里的“怎么重置密码”,或者代码助手里的“解释这段 Python 代码”。如果每次都要调用大模型重新生成一遍,不仅慢,还白白烧钱。
最直接的解法是加一层缓存。你可以在应用服务器和 LLM API 之间做一个中间层,用 Redis 或内存数据库存储常见的问答对。当新请求进来时,先计算问题的哈希值或语义向量,去缓存里查一下有没有现成答案。如果有,直接返回;如果没有,再调 API,并把结果存进去。
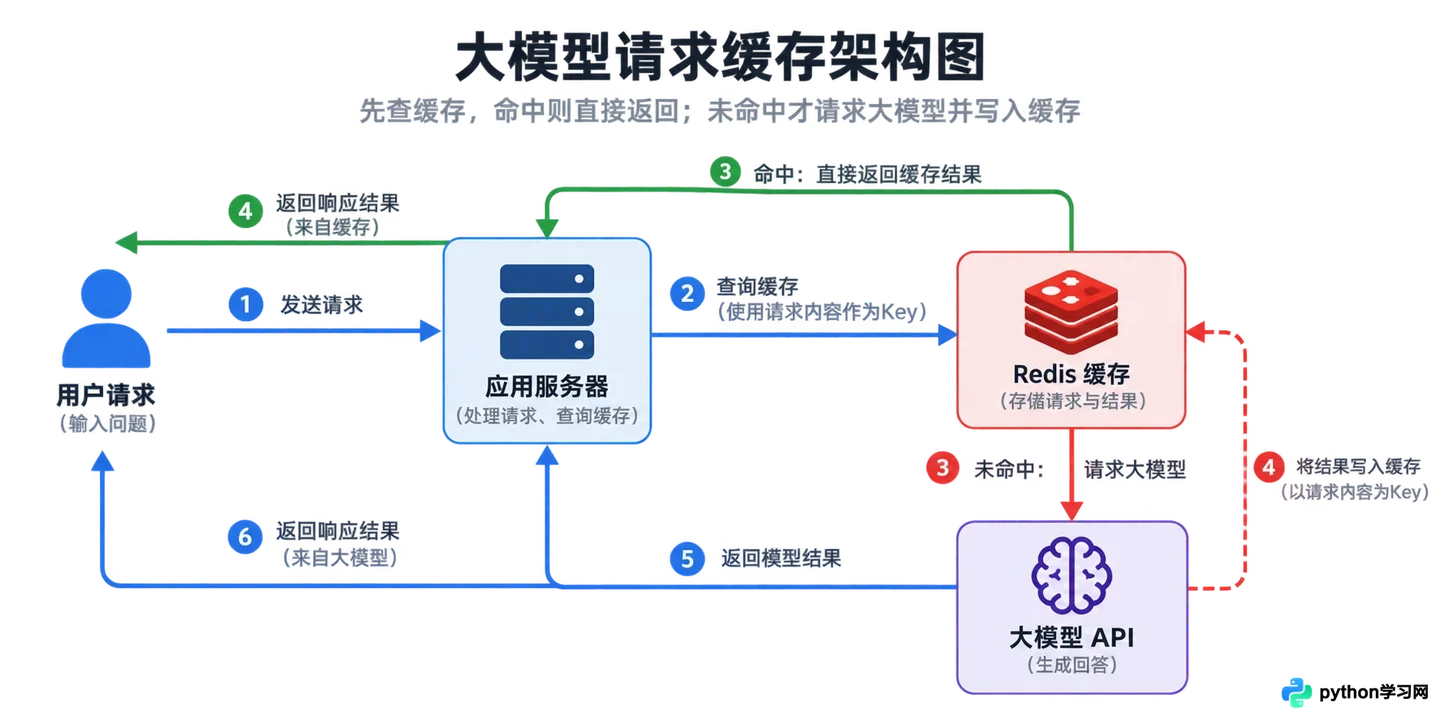
缓存层位于应用服务器与 LLM API 之间,拦截高频重复请求
这里有个细节要注意:缓存不是永久有效的。你需要设置一个合理的 TTL(生存时间),比如 24 小时或 7 天,避免用户得到过时的信息。对于时效性强的内容,比如新闻总结,可以缩短缓存时间或不使用缓存。这一步操作下来,通常能拦截掉 20%-30% 的重复请求,成本立竿见影地降下来。
让用户感觉“秒回”的流式输出
即使优化了后端,大模型生成完整回答依然需要几秒甚至更久。如果让用户盯着一个空白屏幕等 5 秒钟,他们会觉得系统卡死了;但如果第 1 秒就看到第一个字蹦出来,哪怕后面还要等 4 秒,他们的焦虑感也会大幅降低。
这就是流式输出(Streaming)的价值。它不是一次性返回整个 JSON 包,而是通过 SSE(Server-Sent Events)或 WebSocket,像打字机一样把生成的 Token 逐个推送到前端。
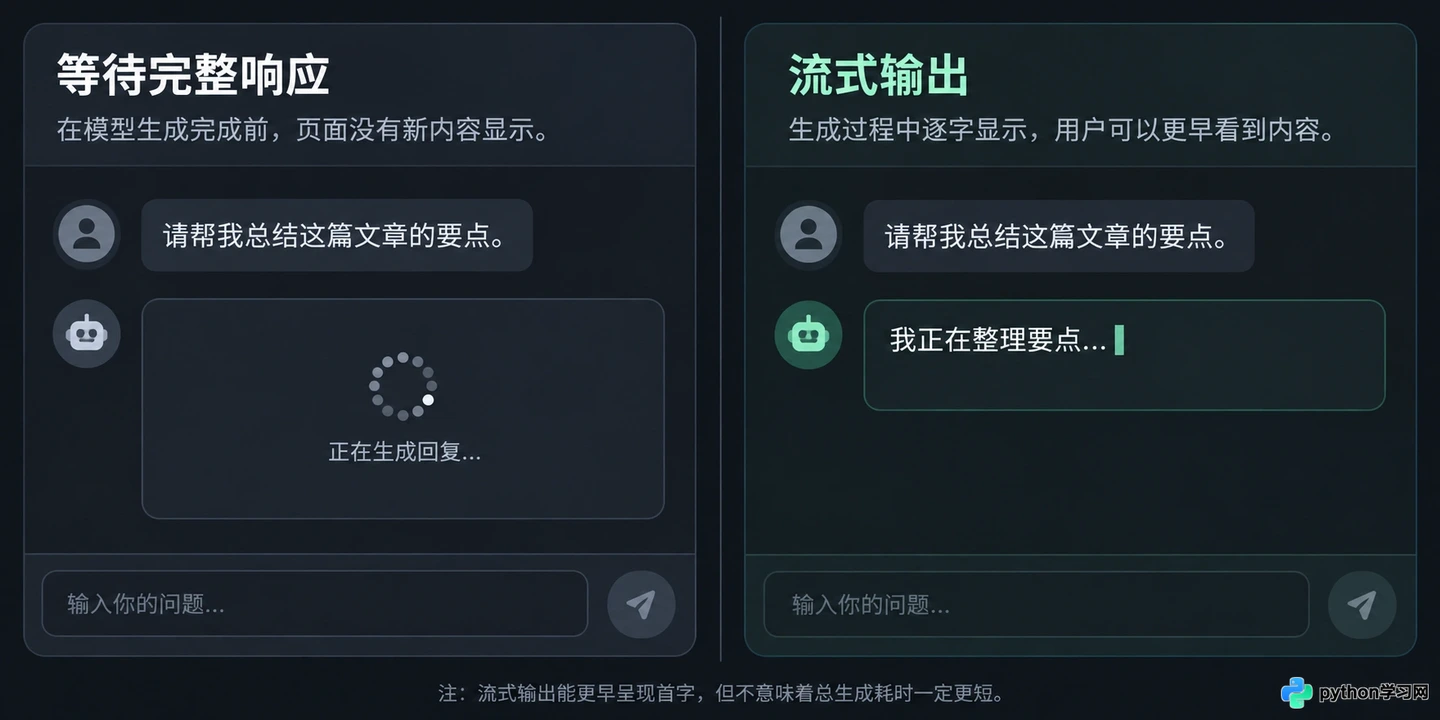
流式输出让文字逐字显示,显著降低用户等待焦虑
在代码实现上,大多数 SDK 都支持 stream=True 参数。开启后,你需要在前端处理增量数据,而不是等待完整响应。虽然总耗时可能没变,但“首字延迟”(Time to First Token)被压缩到了极致。这种“正在思考”的视觉反馈,是提升用户体验性价比最高的手段。
给上下文“瘦身”:只留必要的记忆
大模型的计费是按 Token 数量算的,而上下文窗口(Context Window)里塞入的无关信息越多,不仅越贵,推理速度也越慢。很多开发者习惯把整个对话历史全扔给模型,这在多轮对话后会导致 Token 爆炸。
试试“滑动窗口”策略。只保留最近的 N 轮对话(比如最近 5-10 轮),更早的记录直接丢弃。对于大多数日常任务,模型并不需要记得你三天前说过什么。
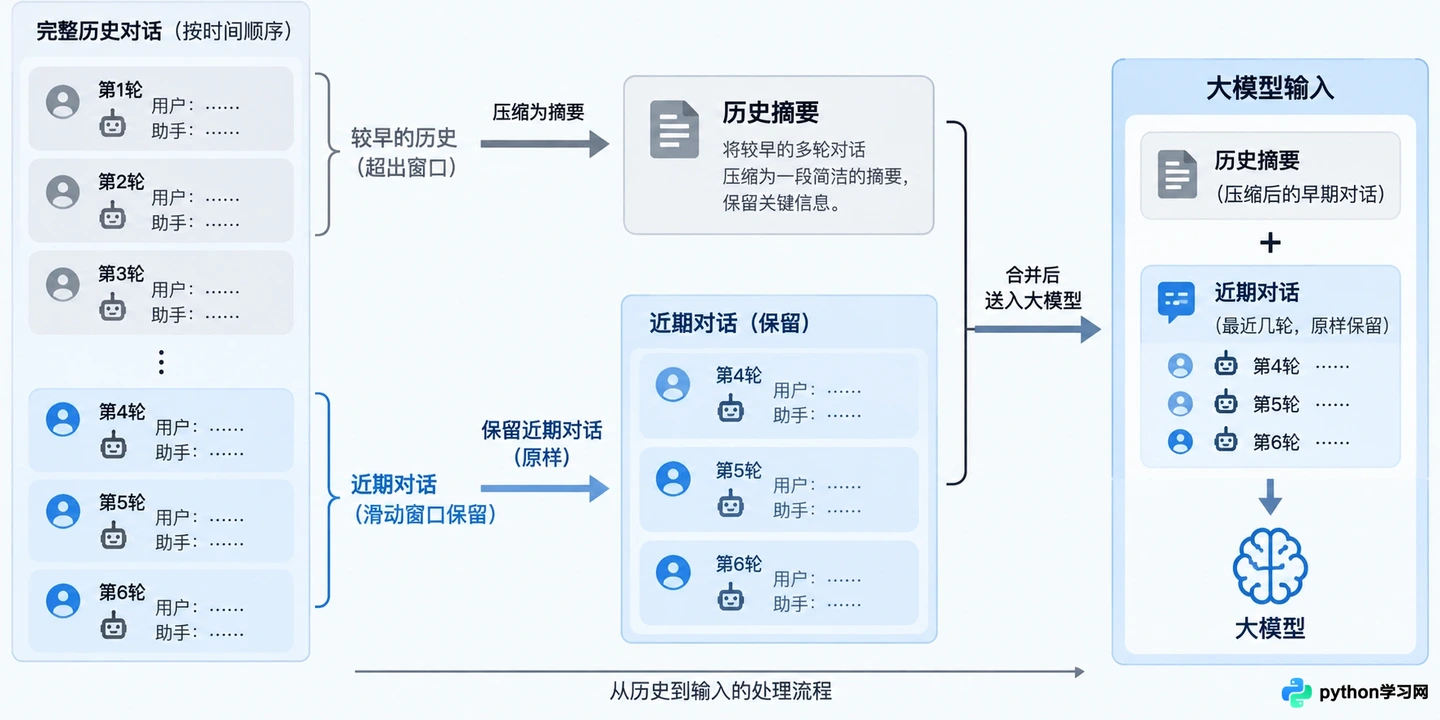
通过滑动窗口保留近期对话,并用摘要替代历史记录
如果业务确实需要长期记忆,可以用“摘要压缩”。每隔几轮对话,调用一次小参数模型(或者同一模型的低温度设置),让模型把之前的对话总结成一段简短的背景描述,替换掉原始的冗长记录。这样既保留了关键信息,又把几百个 Token 压缩成了几十个。
另外,检查你的 System Prompt(系统提示词)。很多开发者喜欢写几千字的详细人设,其实大部分是废话。精简指令,只保留核心的行为约束和格式要求,也能省下不少输入 Token。
组合拳才是最优解
单独看,缓存省的是重复钱,流式改的是感知速度,上下文管理控的是单次上限。但在实际工程中,这三者往往是组合使用的。
建议的排查顺序是:先开流式输出,解决用户“觉得慢”的主观感受;再加缓存,砍掉明显的无效调用;最后优化上下文策略,压降单次请求的平均 Token 数。不用追求一步到位,每改动一处,观察一下后台的 P99 延迟和平均 Token 消耗,数据会告诉你下一步该往哪走。毕竟,好的 AI 应用不仅要聪明,还得算得精。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









