

Python rsplit()方法:从右向左分割字符串的应用
深入讲解 Python 中 str.rsplit() 方法的语法原理、参数机制及从右向左拆分字符串的实战场景与注意事项。
在 Python 日常开发中,字符串分割是一项极为高频的基础操作。绝大多数开发者对 split() 方法了如指掌,但在面对“仅需要提取右侧若干字段”或“文件扩展名分离”等特定任务时,从头切分往往会产生冗余片段甚至导致逻辑偏差。Python 原生内置的 str.rsplit() 方法正是专门用于从右向左限制切分的利器。本文将深入梳理该方法的工作原理、参数细节、核心实战场景与常见避坑要点,帮助你在合适场景下写出更直接、健壮的代码。
一、rsplit() 的基本概念与工作机制
rsplit() 是 Python 字符串(str)对象的内置方法。其完整方法签名如下:
str.rsplit(sep=None, maxsplit=-1)该方法接收两个可选参数:
sep:用作分隔符的字符串。默认值为None,代表按空白字符(包括空格、换行符\n、制表符\t等)切分,并自动合并连续空白。maxsplit:最大分割次数。默认值为-1,表示没有分割次数限制。
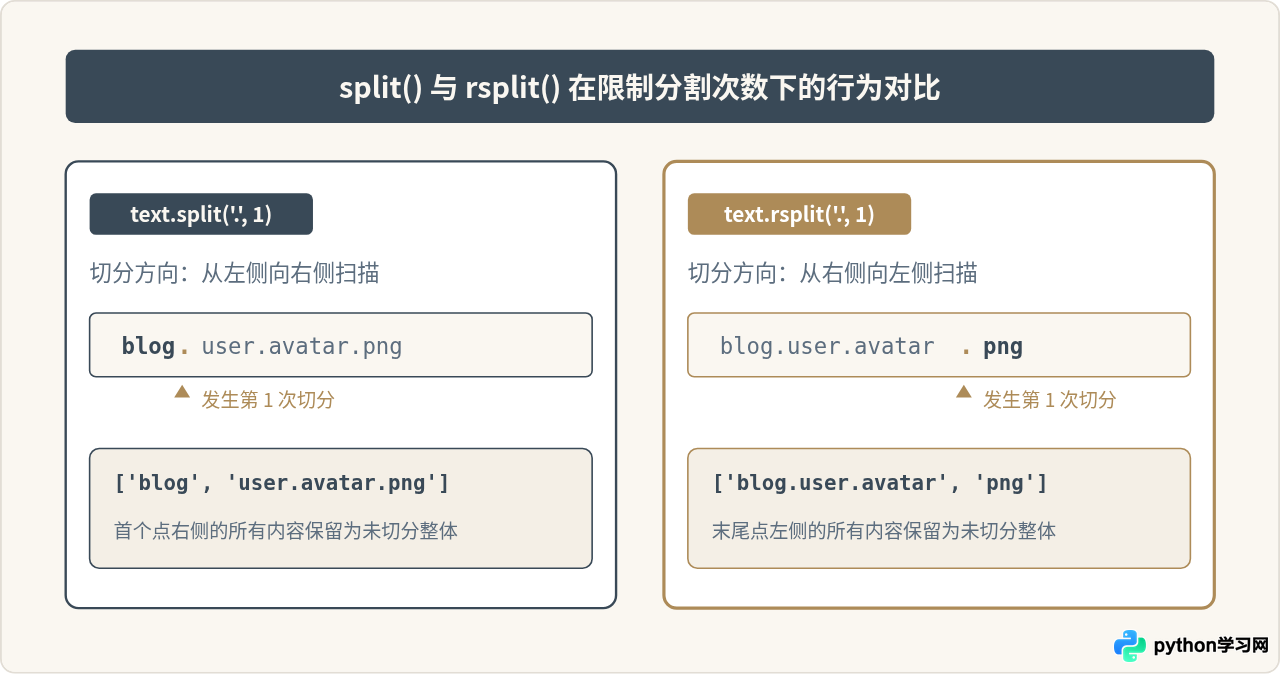
很多初学者容易产生一个误解:以为 rsplit() 会把返回的列表结果也倒序排列。事实上,无论从哪一侧切分,返回列表中各子串的排列顺序始终与原字符串在文本中的自然出现顺序保持一致。rsplit() 唯一改变的,是当设置了正整数 maxsplit 时,分割动作优先在字符串的最右侧发生。
二、rsplit() 的参数细节与求值步骤
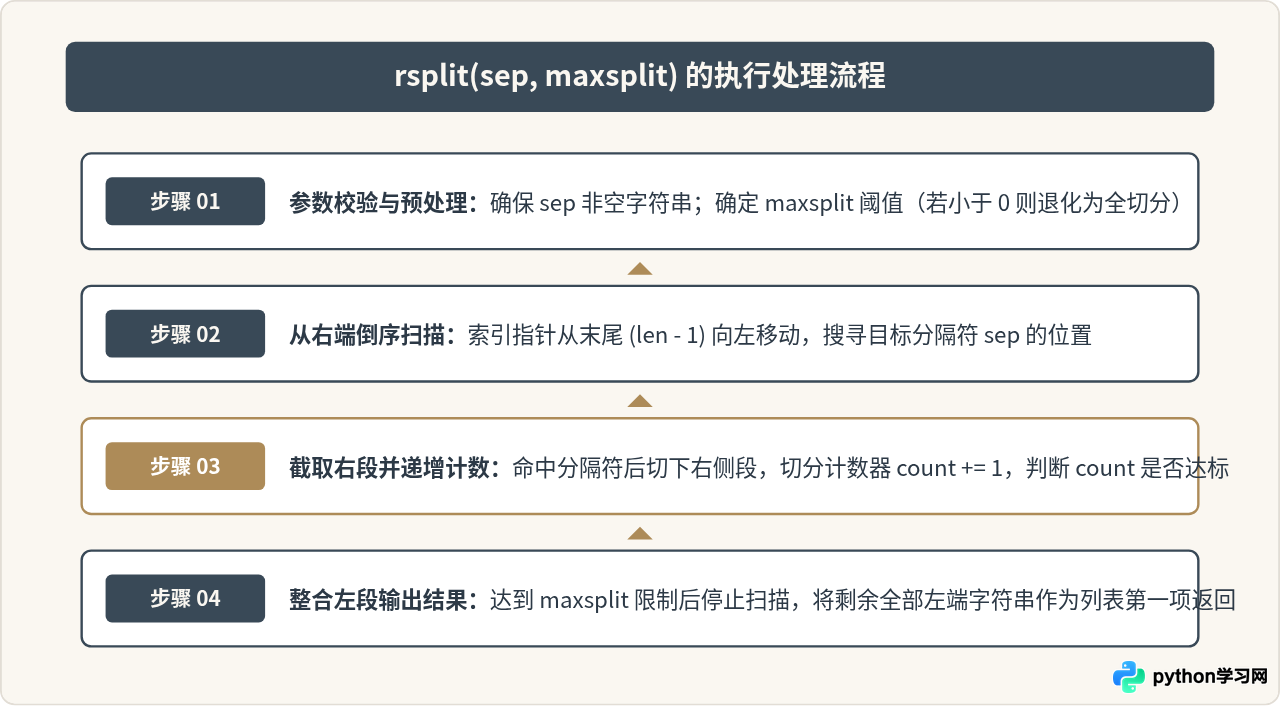
为了精确掌握 rsplit() 的内部运转,我们需要理解 Python 解释器在执行该方法时经历的标准步骤:
- 参数校验:检查
sep是否为有效字符串。如果传入空字符串sep="",Python 会直接抛出ValueError: empty separator异常。若maxsplit < 0,解释器将按全量切分处理。 - 逆向扫描匹配:内部游标从字符串右端末尾索引开始倒序向左推进,匹配分隔符
sep。 - 分段打包与计数:每当匹配到一个完整分隔符,将分隔符右侧的子串推入结果列表,同时分割计数器加 1。
- 边界收尾:当分割次数达到
maxsplit,或者游标已移动到字符串起始头部,剩余未遍历的左侧字符串将整体作为列表的第一个元素,完成返回。
当
sep=None 时,连续的空格、制表符或换行符会被整体视为一个分隔符,且首尾多余空白会自动忽略;而如果显式指定 sep=' ',则每一个空格都会触发切分,两个相邻空格之间会产生空字符串 ''。
三、典型应用场景与代码实战
在工程实践中,rsplit() 特别适用于“右侧结构规整、左侧长度与层级不确定”的数据提取。下面展示四个最常见的使用范式。
1. 安全提取文件扩展名与基础名
许多文件的名称中包含多个点号(例如 archive.backup.tar.gz 或 jquery.min.js)。如果使用 split('.'),会产生多个零散的元素;而使用 rsplit('.', 1) 可以精准地仅将最右侧的扩展名与左侧的主文件名分离。
filename = "financial.report.q3.final.pdf"

# 仅从右侧分割一次
base_name, extension = filename.rsplit('.', 1)

print("主文件名:", base_name)   # 输出: financial.report.q3.final
print("扩展名:", extension)     # 输出: pdf
2. 解析服务地址中的主机与端口号
在网络与微服务配置中,服务地址通常形如 host:port,然而主机名本身可能包含复杂前缀或冒号,使用 rsplit(':', 1) 能够准确提取末尾的端口号,避免误切前置内容。
address = "cluster-sh-node-03.internal.vpc:8080"

# 从右侧切出端口
host, port = address.rsplit(':', 1)

print(f"主机地址: {host}, 端口: {int(port)}")
# 输出: 主机地址: cluster-sh-node-03.internal.vpc, 端口: 8080
3. 解析带多级命名空间的复合键
在很多缓存系统(如 Redis 键设计)中,常采用形如 project:module:submodule:user_id 的命名规则。若只需提取最末级标识符:
cache_key = "user_center:billing:invoices:INV20261029"
prefix, item_id = cache_key.rsplit(':', 1)

print("命名空间前缀:", prefix)  # user_center:billing:invoices
print("业务单号:", item_id)      # INV20261029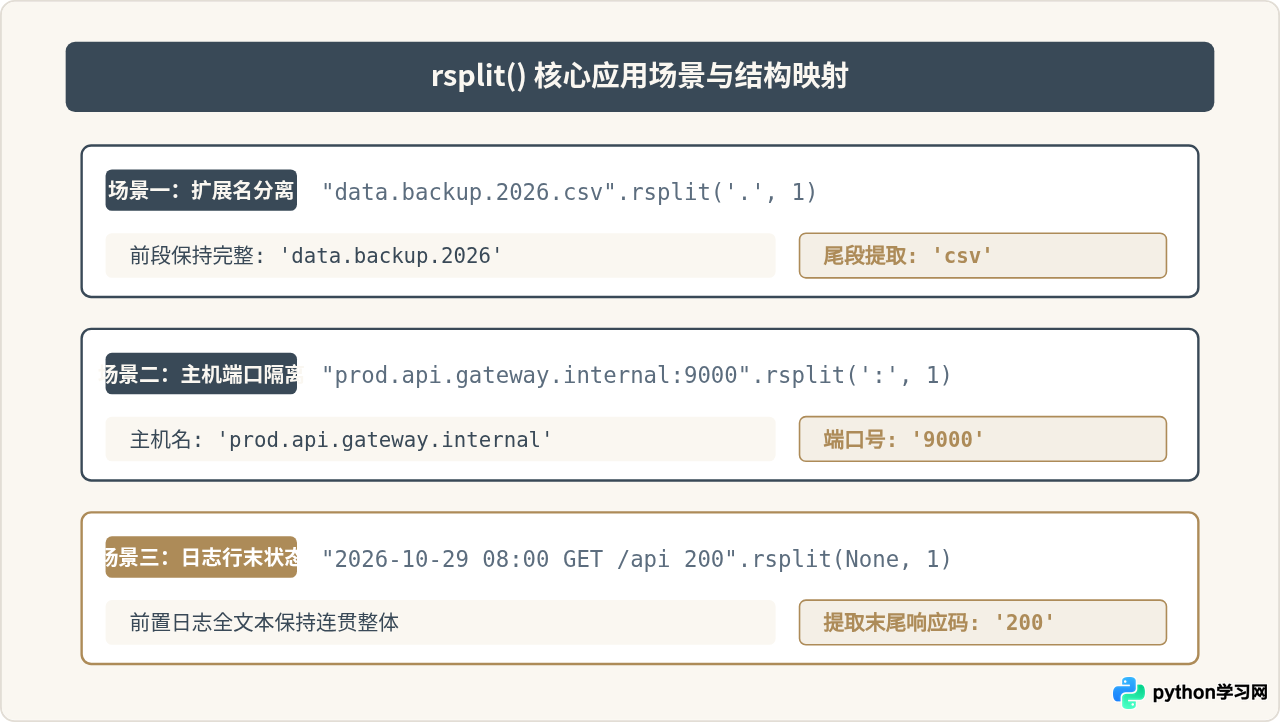
四、开发避坑与注意事项
在实际编码中,为避免潜在的异常与逻辑错误,应特别注意以下四项特性:
- 分隔符不存在时的返回形式:如果字符串中不包含给定的
sep,rsplit()不会报错,而是返回包含原始字符串作为唯一元素的单元素列表(即[str])。若直接解包(如a, b = text.rsplit('.', 1)),会抛出ValueError: not enough values to unpack。在不确定分隔符是否存在时,建议先检查或判断列表长度。 - 空分隔符限制:
rsplit("", 1)会引发ValueError: empty separator。如果需要逐字符切分,应直接使用list(text)。 - 与 os.path.splitext 的区别:在纯路径操作中,Python 标准库提供了
os.path.splitext()或pathlib.Path(p).suffix。但对于非标准路径、自定义 URL 或内存中的复合标识符,rsplit('.', 1)更加轻量且无平台路径规则干扰。 - maxsplit 超过实际存在的分隔符数量:如果
maxsplit大于实际可切分的符号数,rsplit()会在完成所有实际切分后安全停止,不会额外填充空项。
五、总结
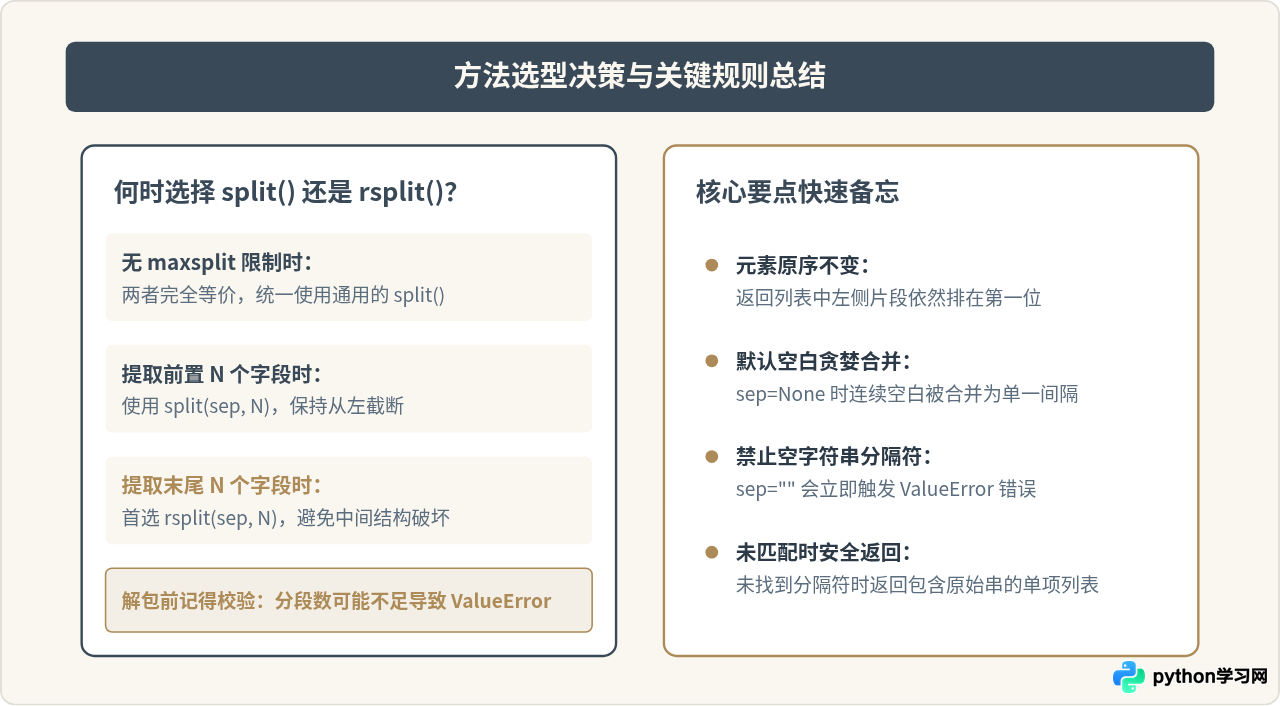
str.rsplit() 是 Python 字符串工具箱中精巧而专一的利器。当无需限制切分次数时,它与 split() 表现完全相同;而一旦赋予正整数 maxsplit,它便能由右至左稳健地剥离目标字段,保留前置内容的完整性。掌握该方法的扫描机制与默认行为,能够使日常文本解析与数据抽取逻辑更加精炼、安全。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









