

Python使用splitlines()按换行符分割字符串的方法

在 Python 中处理多行文本、文件内容或网络报文时,按行拆分字符串是一项最基础也最高频的操作。Python 字符串提供了内置的 str.splitlines([keepends]) 方法,能够自动识别常见的 \n、\r\n、\r 以及多种 Unicode 换行符,将字符串切分为由各行组成的列表。相比使用 str.split('\n'),splitlines() 不仅具备跨平台的自适应能力,而且在处理字符串末尾的换行符时不会产生冗余的空字符串,是处理行切分任务的首选方案。本文将详细讲解该方法的基本用法、关键参数以及与常规切分方法的区别。
一、splitlines() 的基本用法与执行流程
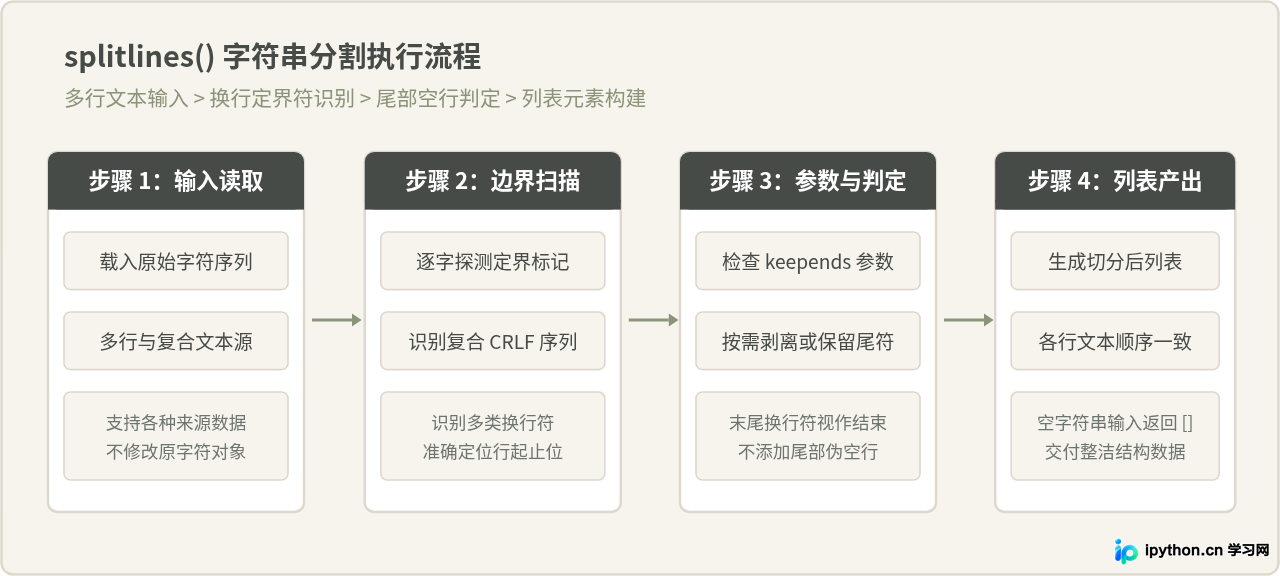
调用 splitlines() 的语法非常简单,直接在字符串对象上调用即可,不需要传递任何必选参数。方法会从头到尾扫描字符串中的行边界,并在每一个边界处截断,最终返回所有单行文本构成的列表。
# 基础按行切分示例
text = "第一行内容\n第二行内容\r\n第三行内容\r第四行内容"
lines = text.splitlines()
print(lines)
# 示例输出:['第一行内容', '第二行内容', '第三行内容', '第四行内容']
在上述代码中,输入的字符串混合了 Unix 风格的 \n、Windows 风格的 \r\n 以及老式 macOS 风格的 \r。splitlines() 能够一次性将它们统一识别并正确切分,且默认会将这些行定界符从最终的切片结果中剥离。
二、使用 keepends 参数控制行尾换行符
splitlines() 拥有一个可选布尔参数 keepends,其默认值为 False。当保持默认时,切分得到的列表项中不包含行尾换行符;如果将 keepends 显式指定为 True,切分得到的每一行都会保留该行原有的行定界符。
# 对比 keepends 的取值效果
content = "Alpha\nBeta\r\nGamma"

# 默认 keepends=False
print(content.splitlines())
# 示例输出:['Alpha', 'Beta', 'Gamma']

# 指定 keepends=True
print(content.splitlines(keepends=True))
# 示例输出:['Alpha\n', 'Beta\r\n', 'Gamma']
在实际工程中,keepends=True 非常适用于需要原样还原文件或进行逐行重构的场景。例如在编写代码格式化工具、文档比对工具或网络通信传输中,保留原行尾的 \r\n 或 \n 能够确保在修改或重组文本后,写回磁盘的格式与原文件保持字节级的严格一致。
三、深入辨析:splitlines() 与 split('\n') 的核心区别
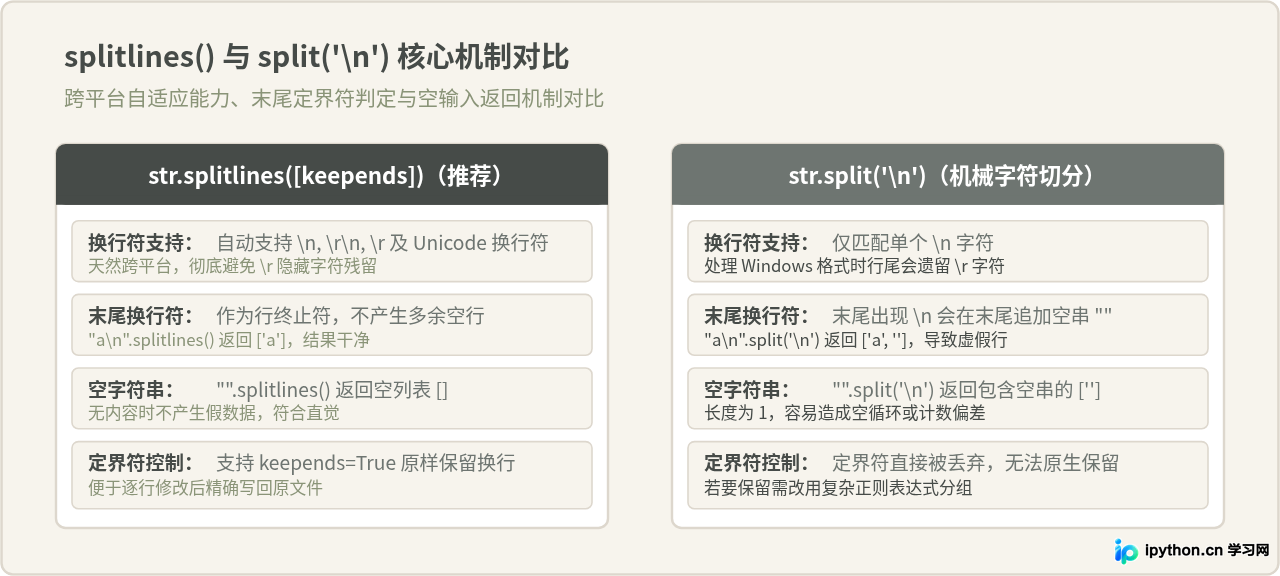
在日常开发中,有一种容易混淆的常见说法:“按行分割字符串直接用 split('\n') 就足够了,两者没有本质区别”。这种观点在文本非常简单且仅包含单个 Unix 换行符时看似成立,但在真实生产环境中,混用两者会引入严重隐患。它们在以下三个核心维度存在明确差异:
- 跨平台换行符的兼容性:
split('\n')仅按单一的\n字符切分。如果输入文本来自 Windows 环境(使用\r\n作为行定界),执行split('\n')后,每一行末尾都会残留一个不可见的\r回车符。这不仅会导致后续字符串匹配失败,还会对日志打印和正则解析造成干扰。而splitlines()会将\r\n整体视为单个行定界符予以清除。 - 末尾换行符的处理逻辑: 这是二者最显著的语义差异。当文本以换行符结尾时,
split('\n')会把末尾的换行符切分为前后两半,从而在返回列表的最后添加一个空字符串""。而splitlines()遵循“换行符用于终结当前行”的规则,末尾的换行符仅标志着该行结束,不会额外多产生一行。 - 空字符串的处理结果: 当输入为空字符串
""时,"".split('\n')会返回包含一个空字符串的列表[''];而"".splitlines()会返回真正的空列表[]。
# 末尾换行与空字符串的表现差异
trailing_text = "line1\nline2\n"

print(trailing_text.split('\n'))
# 示例输出:['line1', 'line2', ''] —— 出现了多余的空行!

print(trailing_text.splitlines())
# 示例输出:['line1', 'line2'] —— 正确切分,不产生假空行

print("".split('\n'))
# 示例输出:['']

print("".splitlines())
# 示例输出:[]
四、行定界符识别范围与末尾逻辑图解
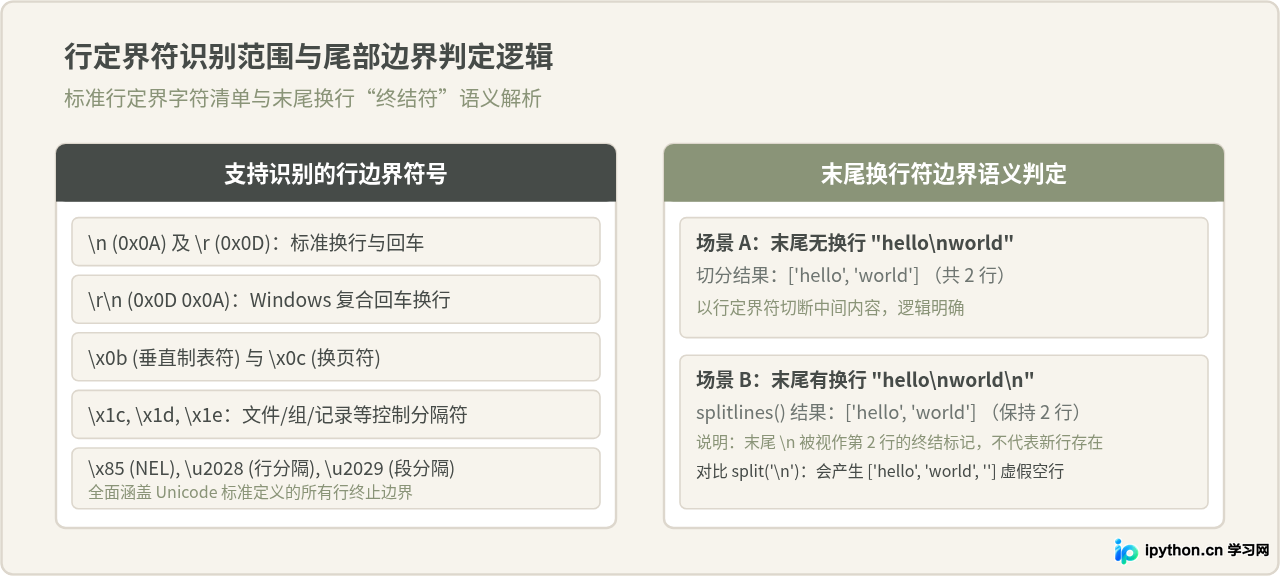
为了让跨平台文本处理更加健壮,Python 官方文档对 splitlines() 所能识别的行边界(Line Boundaries)给出了极其详尽的标准规范。它并不局限于 ASCII 字符集中的回车与换行,而是完整覆盖了多种专用换行符号。
下表列出了 splitlines() 支持识别的标准行定界符:
\n(0x0A): 换行符(Line Feed,Linux/macOS 常用)\r(0x0D): 回车符(Carriage Return,传统 Mac 常用)\r\n(0x0D 0x0A): 回车换行组合(CRLF,Windows 常用)\x0b(0x0B): 垂直制表符(Line Tabulation)\x0c(0x0C): 换页符(Form Feed)\x1c,\x1d,\x1e: 文件分隔符、组分隔符与记录分隔符\x85: 下一行(Next Line,NEL)\u2028,\u2029: Unicode 行分隔符与段落分隔符
五、实战最佳实践与文本清洗技巧
在工程开发中,splitlines() 通常与列表推导式、字符串去空方法结合使用,以完成高效、健壮的文本清洗。以下是两种最具代表性的实战场景:
1. 批量清洗混杂空行与空格的文本
从外部接口获取的数据或从网页抓取的文本,经常夹杂连续回车、前导或尾随空格。使用 splitlines() 配合列表推导式,可以优雅地过滤掉无意义的空行:
# 过滤纯空行与修剪首尾空格
raw_data = """
系统配置清单

  IP: 192.168.1.100
  PORT: 8080

  STATUS: ACTIVE
"""

# 仅保留包含实际有效字符的行,并剥离首尾空格
cleaned_lines = [
    line.strip()
    for line in raw_data.splitlines()
    if line.strip()
]

print(cleaned_lines)
# 示例输出:['系统配置清单', 'IP: 192.168.1.100', 'PORT: 8080', 'STATUS: ACTIVE']
2. 文件逐行处理与内存权衡
在读取外部文件时,有两种常见的处理路径:直接迭代文件对象 for line in file_obj: 或者先通过 file_obj.read().splitlines() 一次性载入内存。
如果文件体积较小(数兆字节以内)且需要对整体行数进行频繁统计、随机索引或反复遍历,使用 read().splitlines() 能够一次性生成去除了换行符的干净列表;但如果文件达到数百兆或几千兆字节,则应避免使用 splitlines() 一次性载入,而应改用文件迭代器逐行处理,以防内存溢出。
六、核心要点总结
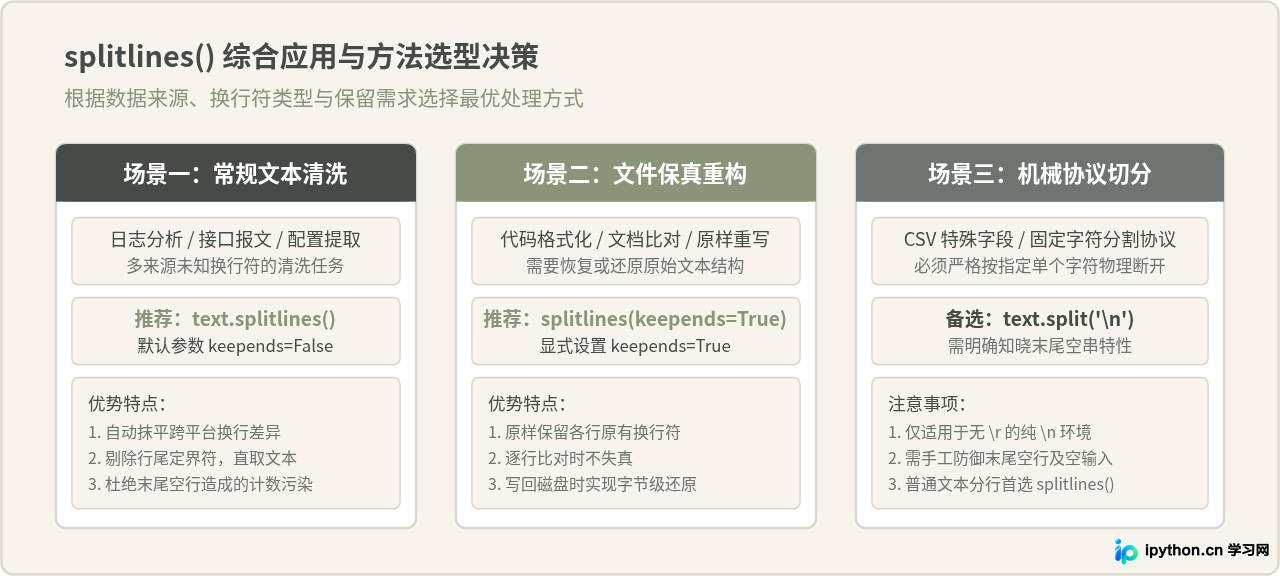
掌握 splitlines() 的关键在于理解它作为“行处理专用方法”与通用字符切分方法的定位差异:
- 按行拆分的首选: 只要处理目标是多行文本,优先选用
splitlines()。它内建了对全平台换行符(\n、\r\n、\r及 Unicode 行终止符)的自动兼容,能够杜绝由于系统差异引起的格式 Bug。 - 掌握 keepends 控制开关: 默认
keepends=False返回纯净的行文本内容;当需要保留原始换行符以供精准还原或格式比对时,传入keepends=True。 - 理清末尾换行语义:
splitlines()将末尾换行符作为当前行的正常终结,绝不在列表末尾生成虚假空行;对空字符串输入亦能严谨返回空列表[]。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









