

Python Web自动化库选型:Selenium与Playwright对比
针对Python Web自动化开发,深入对比Selenium与Playwright的底层架构、等待机制、API设计、执行性能及典型应用场景,提供系统化的工程选型决策指南。
在 Python Web 自动化、端到端测试与网页数据抓取场景中,选择合适的驱动库直接决定了脚本的开发效率、执行稳定性与维护成本。当前最主流的两个选择是成熟老牌的 Selenium 与近年崛起的 Playwright。核心结论非常明确:如果是全新启动的项目,涉及单页应用(SPA)、高并发爬虫、复杂网络拦截或追求极速执行与零配置调试,Playwright 在架构与开发体验上具备明显优势;如果项目需要兼容既有的 Selenium Grid 分布式集群、严格要求支持陈旧浏览器版本,或深度依赖传统云测平台,Selenium 依然是兼容面最广的工业标准。
一、架构差异:通信协议与执行机制
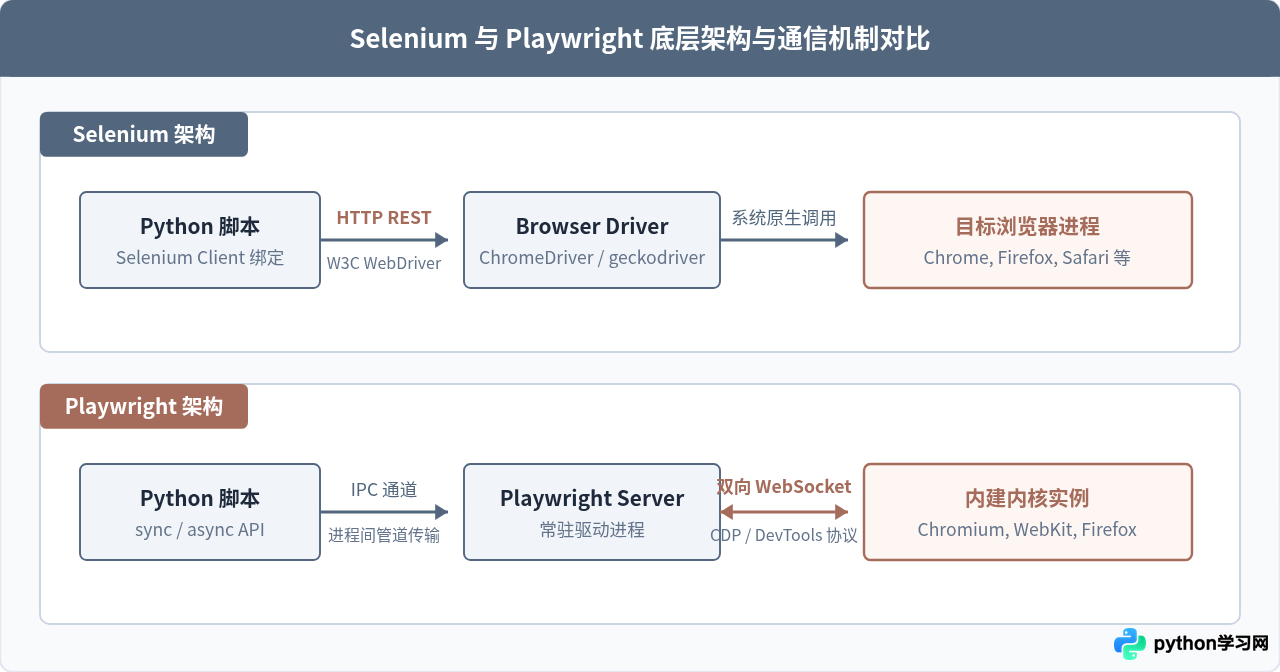
Selenium 与 Playwright 之间最根本的差异来自底层通信架构与与浏览器的交互方式。这种底层设计的不同,直接导致了它们在执行速度、并发资源消耗以及环境搭建上的截然不同表现。
Selenium 长期采用基于 HTTP 的请求响应模型。在 WebDriver 体系中,Python 客户端执行一条操作命令(例如查找元素或点击),会先通过 HTTP 协议发送符合 W3C WebDriver 标准的 REST 请求给对应的驱动程序(如 ChromeDriver 或 geckodriver),再由驱动程序转译为具体浏览器底层的私有调用。每个操作都是一次独立的网络往返(Round-trip),在庞大测试套件或高频操作下,积累的 HTTP 连接开销与延迟会十分可观。
Playwright 则由微软团队设计,采用了完全不同的长连接事件驱动架构。Python 客户端启动一个轻量级的 Node.js 驱动后端,客户端与驱动之间通过内部高效通道通信,而驱动与 Chromium、Firefox、WebKit 浏览器引擎之间通过单一的持久化 WebSocket 连接(Chrome DevTools Protocol,CDP 及类似双向通道)进行通信。这种双向长连接允许双向数据流和实时事件监听,浏览器可以直接主动向客户端推送网络事件、DOM 变更与控制台日志,不仅消除了频繁建立 HTTP 连接的开销,也让全自动化操作的响应更加迅速。
二、核心体验:等待机制与元素定位
编写自动化脚本时,最常见且令人头痛的问题莫过于由于页面异步加载(AJAX 请求、React/Vue 虚拟 DOM 渲染)造成的“元素找不到”或“元素不可交互”。两个工具在这一关键体验上的处理策略差异巨大。
1. 等待机制的实现
在传统的 Selenium 中,默认的 find_element 操作是瞬时的。如果元素尚未渲染完成,代码会立即抛出 NoSuchElementException。为了保证稳定性,开发者必须引入显式等待(WebDriverWait),结合 expected_conditions 显式指定条件与超时时间。如果漏写或过度使用 time.sleep,不仅导致代码臃肿,还会让脚本变得脆弱(Flaky)。
# Selenium 显式等待典型代码片段
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC

driver = webdriver.Chrome()
driver.get("https://example.com/login")

# 必须手动为每个动态元素设置条件等待
username_input = WebDriverWait(driver, 10).until(
    EC.visibility_of_element_located((By.ID, "username"))
)
username_input.send_keys("demo_user")

submit_btn = WebDriverWait(driver, 10).until(
    EC.element_to_be_clickable((By.CSS_SELECTOR, "button[type='submit']"))
)
submit_btn.click()
driver.quit()
而在 Playwright 中,自动等待(Auto-waiting)是默认开启的一等公民。当调用 click()、fill() 等操作时,Playwright 会在触发底层动作之前自动执行一系列“可操作性检查”(Actionability Checks),包括:元素是否已挂载到 DOM 树、是否在视口可见、是否停止了 CSS 动画过渡、是否处于非禁用状态(Enabled),以及是否未被上层遮罩阻挡。只有所有检查全部通过后,才会执行点击或输入。开发者几乎不需要手写等待条件,代码精简且稳定性大幅提升。
# Playwright 自动等待典型代码片段
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch()
    page = browser.new_page()
    page.goto("https://example.com/login")

    # 自动等待元素就绪、可见并可交互
    page.fill("#username", "demo_user")
    page.click("button[type='submit']")

    browser.close()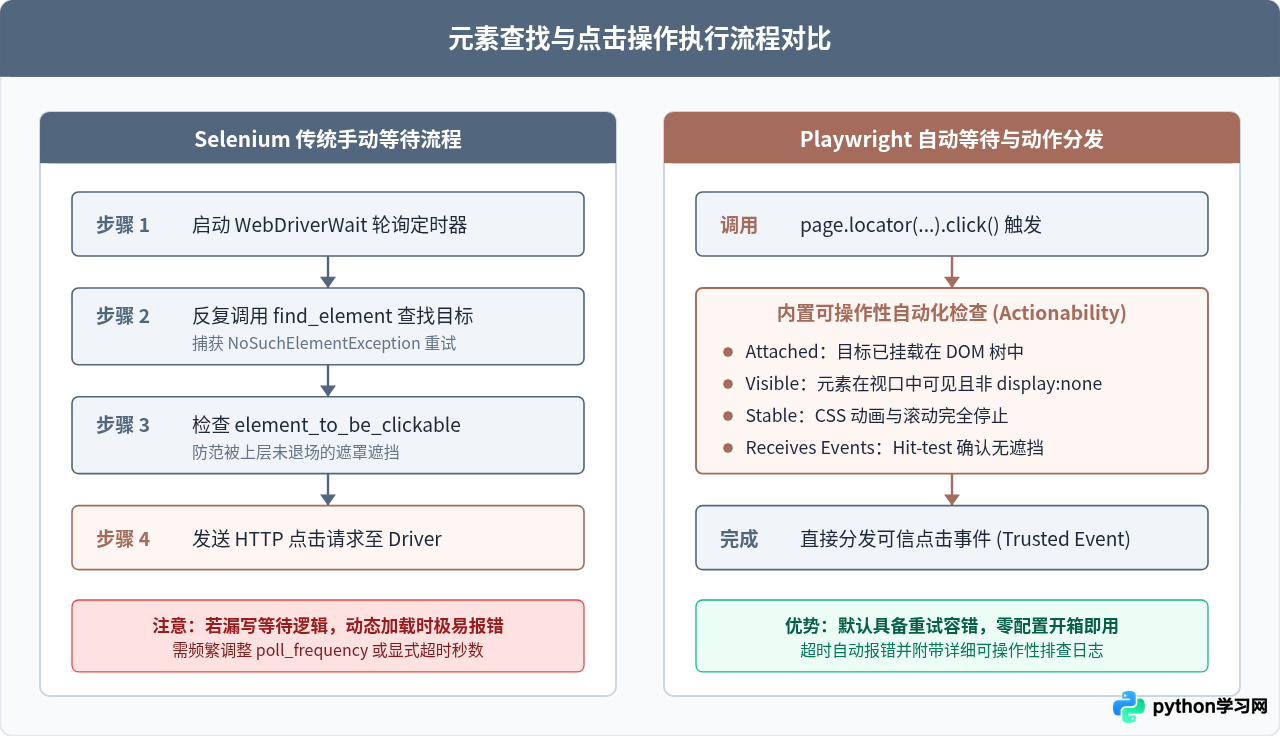
2. 定位器(Locators)与选择器设计
Selenium 的定位主要依托 By.ID、By.CLASS_NAME、By.CSS_SELECTOR 和 By.XPATH。这些定位方式与底层 HTML 结构强耦合。一旦前端组件库重构或者微调了类名,自动化用例往往大面积失效。
Playwright 推荐采用面向无障碍角色(Accessibility)和用户视角的定位器,例如 page.get_by_role("button", name="提交")、page.get_by_text("欢迎登录")、page.get_by_label("用户名")。这种定位思路促使自动化脚本模拟真实用户的感知方式,不仅对页面内部结构变更有更强的弹性,还能倒逼前端开发遵循标准的可访问性规范。
三、进阶特性对比:多上下文、网络拦截与调试生态
除了基础的 DOM 操作外,在复杂的业务测试与爬虫场景中,环境隔离能力、网络请求干预以及调试诊断工具链往往是影响团队效率的决定性因素。
1. 轻量化多上下文(BrowserContext)
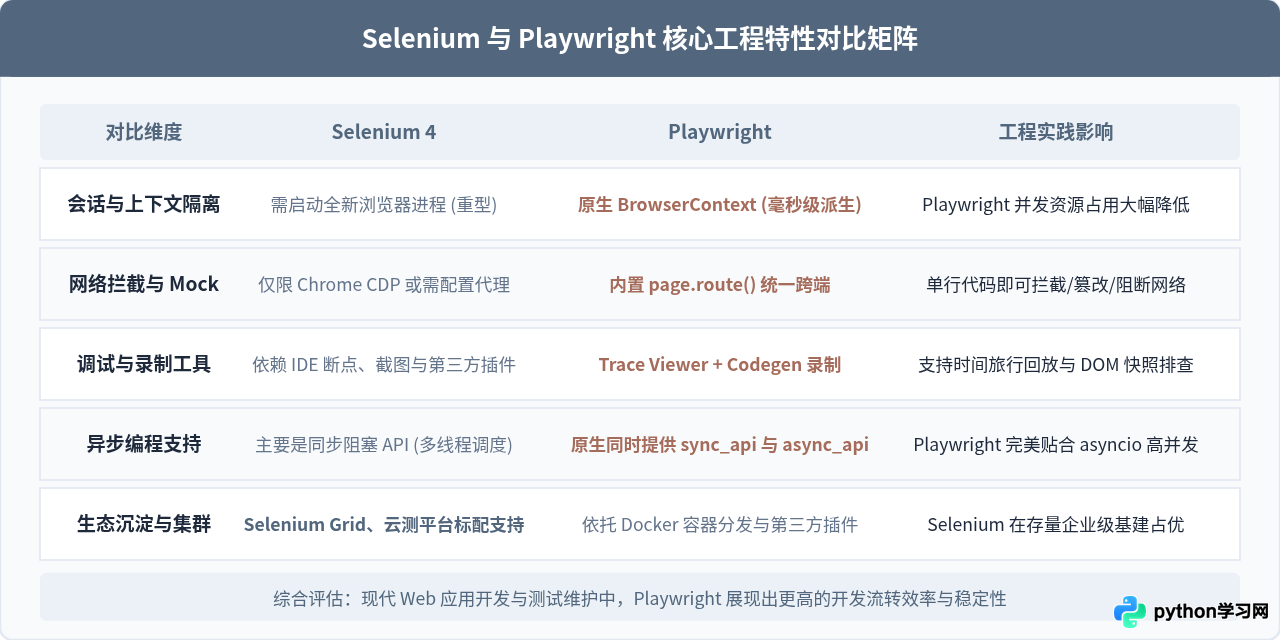
在 Selenium 中,如果需要模拟多个隔离的用户会话(例如同时测试买家与卖家的交互,或多账号并发爬取),通常需要启动多个独立的 WebDriver 浏览器实例。启动一个全新的 Chrome 实例不仅需要占用数百兆内存,启动耗时通常也在秒级以上。
Playwright 引入了类似于“无痕模式”的 BrowserContext 概念。一个运行中的浏览器实例可以轻量派生出数十个甚至上百个相互完全隔离的上下文。每个上下文拥有独立的 Cookie、LocalStorage、Cache 与会话状态,且创建耗时仅需数十毫秒,内存开销微乎其微。这使得在单台机器上以极低的资源占用运行高并发测试成为现实。
2. 网络拦截与请求 Mock
现代 Web 页面重度依赖后端 API。在测试过程中,经常需要屏蔽耗时的图片/字体加载、Mock 错误接口状态(如 500、网络超时),或者伪造鉴权响应。
- Selenium:在 Selenium 4 之前,拦截网络几乎必须配置外部代理服务器(如 Browsermob-Proxy)。Selenium 4 虽然通过 CDP 支持了部分网络操作,但语法冗长、不同浏览器实现差异大,且不支持跨浏览器标准。
- Playwright:提供了原生的
page.route()机制,仅需一行代码即可拦截特定匹配规则的请求,无论是直接中止(abort)、篡改请求头还是返回自定义 JSON,都能开箱即用,并在 Chromium、WebKit、Firefox 上保持统一的行为。
3. 诊断与时间旅行调试(Trace Viewer)
当自动化用例在持续集成(CI/CD)环境中失败时,排查问题常常极具挑战。Selenium 的传统做法是在失败时截屏、抓取当前页面源码并打印日志,但这往往无法还原发生故障前数秒内用户交互或网络接口的具体时序。
Playwright 内置了 Trace Viewer 工具。只需在代码中开启录制(context.tracing.start(screenshots=True, snapshots=True)),运行结束后即可生成一个完整的 trace 压缩包。打开该文件,开发者可以在图形化界面中进行“时间旅行”:逐帧查看每一个动作发生前后的真实 DOM 快照、鼠标轨迹、精准网络瀑布流以及控制台日志输出。这直接消除了“本地无法复现、CI 频繁报错”的调试困境。
四、工程选型决策路径
技术选型绝非盲目追新,而是基于当前团队资产、技术背景与业务场景的理性权衡。以下决策树可作为实际选型的重要参考:
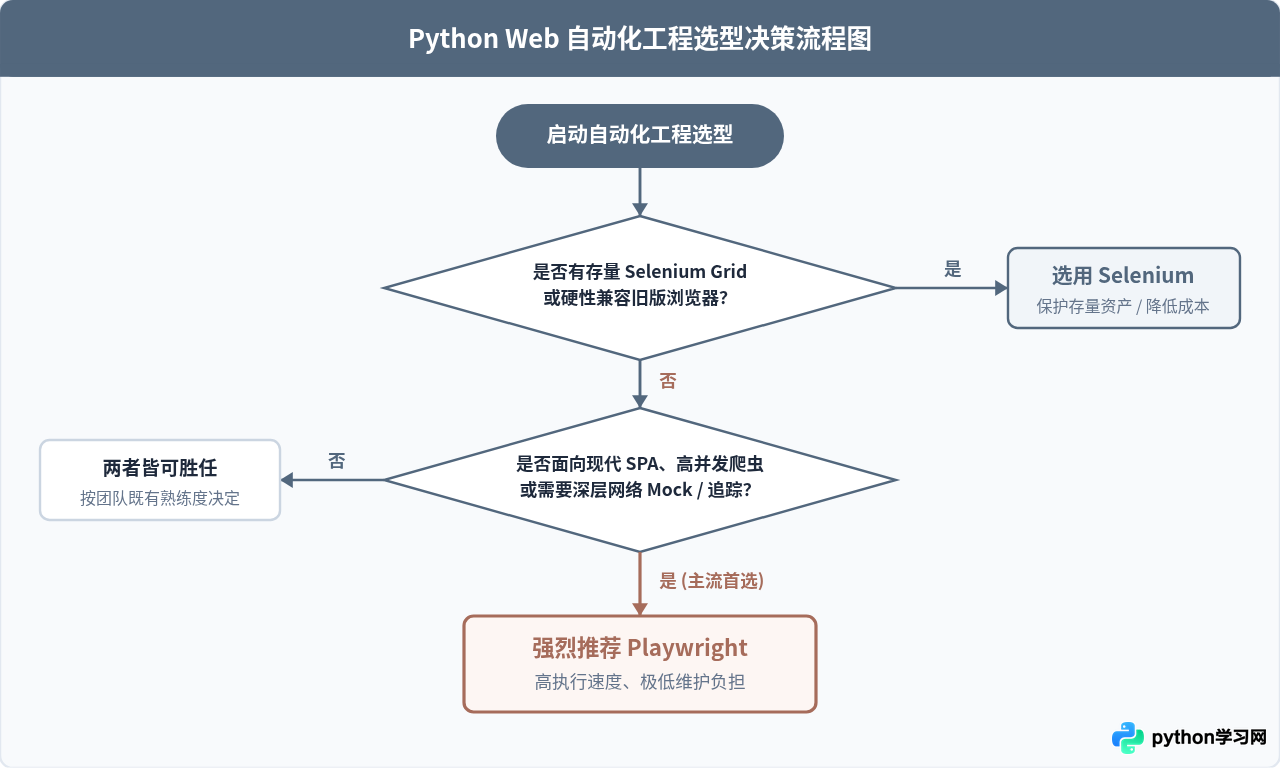
- 优先选择 Playwright 的场景:
- 新开展的前端端到端(E2E)自动化测试套件;
- 基于
asyncio协程的高并发数据抓取或批量登录脚本; - 前端使用 Vue、React、Angular 等动态渲染框架,元素状态变化复杂的应用;
- 团队测试排查成本高,急需 Trace 录制与开箱即用的代码生成器(Codegen)。
- 优先保留或选择 Selenium 的场景:
- 企业内部已有大量成熟且平稳运行的 Selenium 脚本,推倒重构收益不明确;
- 必须接入现成的庞大私有云 Selenium Grid 节点或特定企业级硬件集成;
- 目标必须测试真实旧版本 Safari、IE 模式或老版本 Edge 等冷门内核。
五、总结
从技术演进的角度来看,Selenium 为整个自动化行业奠定了标准基石,其通用性与生态覆盖面依然广泛。但 Playwright 站在前人的经验之上,直接从现代 Web 应用的痛点出发,通过持久化长连接、内置自动等待、轻量级上下文隔离以及全套可观测调试工具,大幅降低了用例的不稳定性与维护难度。
在 Python 生态中,只要没有陈旧历史设施的硬性包袱,选择 Playwright 往往能够带来显著的生产力跃升和更为丝滑的开发体验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









