

Python成员运算符in和not in在列表与字符串中的应用
全面讲解Python成员运算符in和not in在列表与字符串中的工作原理、语法规则、匹配行为差异、性能考量以及实际开发中的易错陷阱。
在Python中,in与not in被称为成员运算符(Membership Operators),用于判断一个元素或子序列是否存在于指定的目标序列中,返回布尔值(True或False)。尽管两者在列表和字符串中共享相同的运算符语法,但其底层的比对逻辑存在根本差别:在列表中比对的是单个离散元素的相等性,而在字符串中检测的是连续子序列的切片包含关系。本文将系统拆解这两个运算符在列表与字符串中的具体应用、底层匹配机制、性能开销以及实际编码中常见的认知误区。
一、快速上手:语法规则与基础行为
成员运算符的通用语法形式为 x in s 与 x not in s。其中 x 为待查找的目标,s 为容器对象。not in 在语义与功能上等价于 not (x in s),但在代码规范(PEP 8)中,直接使用 x not in s 更加自然、易读。
# 基础语法示例
fruits = ["apple", "banana", "orange"]
text = "python programming"

# 列表成员检测
print("banana" in fruits)       # 输出 True
print("grape" not in fruits)    # 输出 True

# 字符串成员检测
print("gram" in text)           # 输出 True
print("java" not in text) # 输出 TrueTrue
True
True
虽然上述代码书写起来十分相似,但在匹配深度、类型限制以及边界表现上,两者各有必须遵守的规则。
二、成员运算符在列表中的应用与完整匹配规则
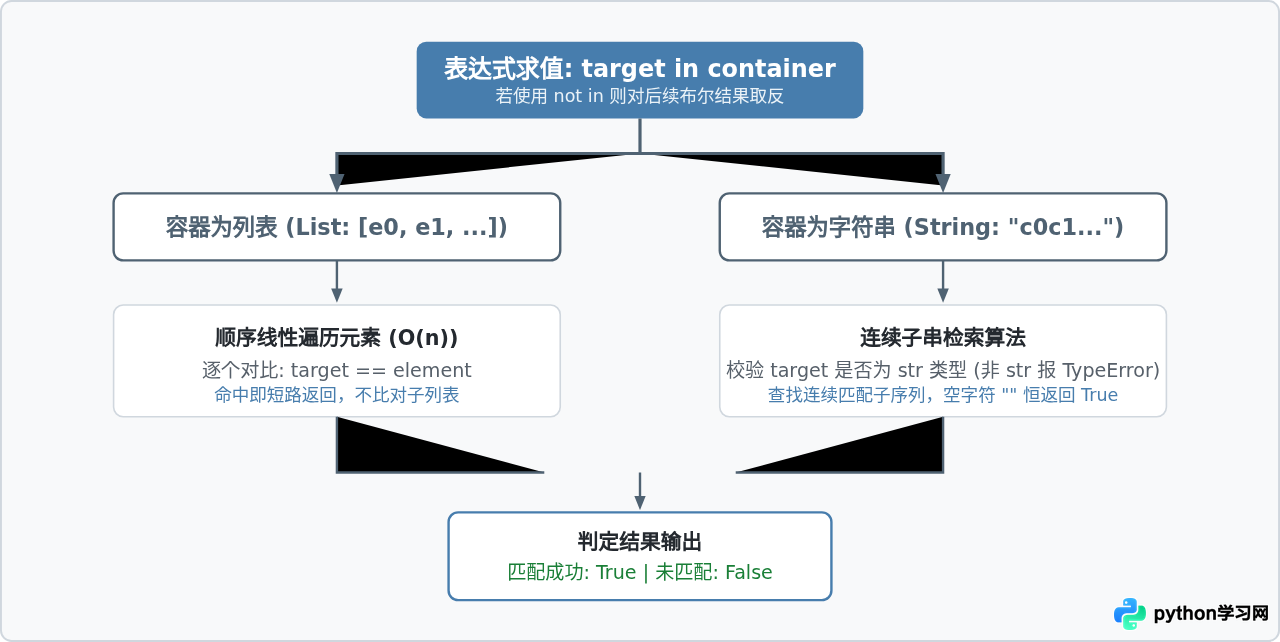
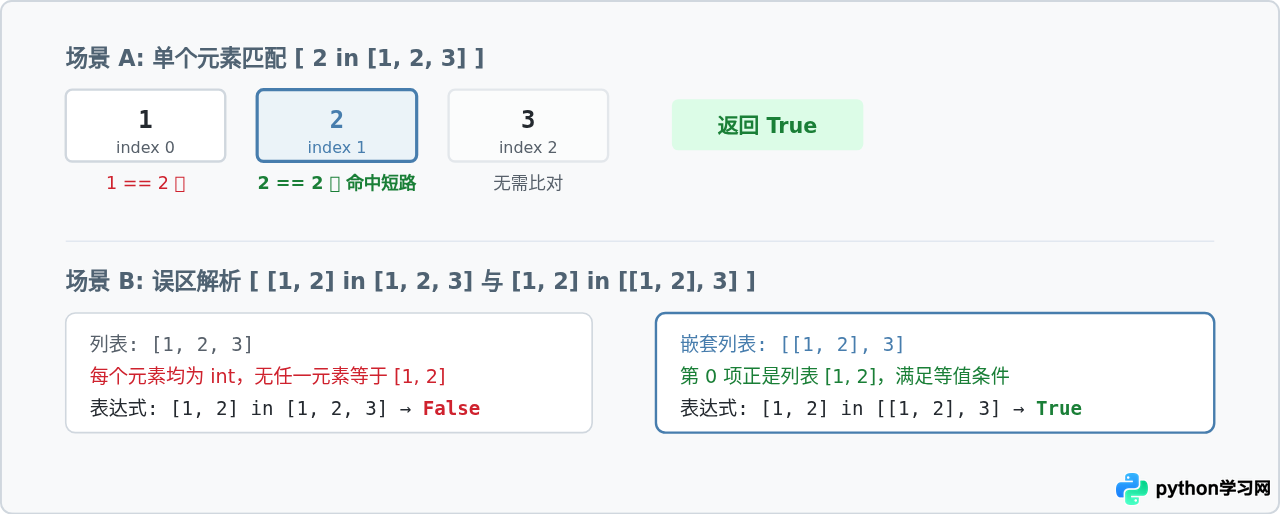
在列表中使用 in 或 not in 时,Python 遵循元素级离散比对原则。Python 会按索引顺序依次取出列表中的每一个元素,与目标值 x 进行等值比较(即 x == element)。只要其中某一个元素比对成功,检测过程立刻中止(短路求值),返回 True;若遍历到末尾仍未匹配,则返回 False。
1. 核心特性:匹配的是“独立元素”而非“子列表”
初学者容易产生一个误解,认为既然 "py" in "python" 为真,那么 [1, 2] in [1, 2, 3] 也应该为真。然而,在列表中,[1, 2] 会被视作一个单独的列表对象,Python 并不会像子串滑动匹配那样去检查列表中是否存在相邻的 1 和 2。
# 元素比对 vs 嵌套列表比对
numbers = [1, 2, 3, 4]
nested_numbers = [1, [2, 3], 4]

# 试图检测连续子集
print([2, 3] in numbers)          # 输出 False,因为列表内只有 1, 2, 3, 4 四个 int 对象

# 针对嵌套列表的成员检测
print([2, 3] in nested_numbers) # 输出 True,因为 nested_numbers[1] 等于 [2, 3]True
2. 类型宽松与布尔值等价性机制
列表中的成员检测依赖 Python 的 == 运算符。在 Python 中,布尔类型 bool 是整数 int 的子类,其中 True == 1 且 False == 0。这种特性在成员运算中会带来显式但隐蔽的表现:
items = [0, "admin", 2]

# 检查布尔值 False
print(False in items)   # 输出 True,因为 items[0] 是 0,0 == False 成立

# 检查布尔值 True
print(True in items) # 输出 False,列表中没有 1False
3. 实际应用场景:白名单校验与去重追加
在日常业务开发中,列表成员运算最常用于用户权限验证与输入过滤:
allowed_roles = ["admin", "superadmin", "editor"]
current_role = "viewer"

# 权限拦截判断
if current_role not in allowed_roles:
    print("拒绝访问:当前角色无管理权限")

# 保证数据不重复追加
tasks = ["build", "test"]
new_task = "test"
if new_task not in tasks:
    tasks.append(new_task)
else:
print(f"任务 '{new_task}' 已存在,跳过添加")任务 'test' 已存在,跳过添加
三、成员运算符在字符串中的应用与连续子串匹配机制
与列表不同,字符串是字符的不可变连续序列。当在字符串中执行 in 或 not in 时,检测的目标不是离散元素,而是连续子序列(子字符串)。
1. 核心特性:必须是连续字符序列
目标字符串中的字符必须连续、按顺序完整出现在源字符串中。如果字符被隔开,即使它们都在原字符串中存在,也会返回 False。
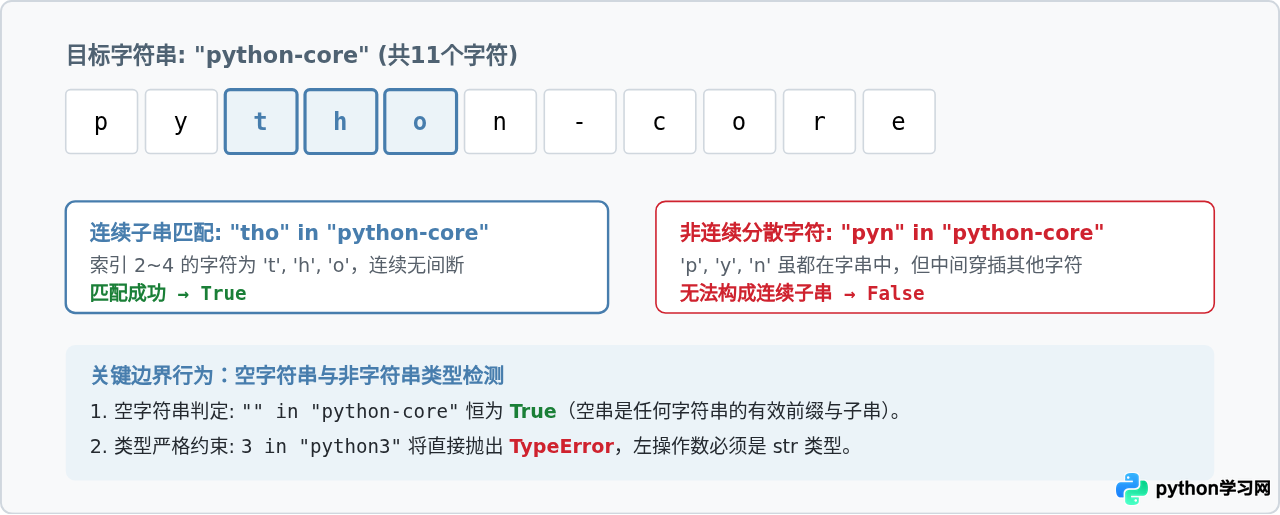
2. 类型严格限制:左操作数必须为 str
在列表中,左操作数可以是任意类型(如数字、元组、函数等)。但在字符串中,如果左侧操作数不是 str 类型,Python 解释器会直接终止执行并抛出 TypeError:
# 常见错误类型
version_str = "Python release 3.12"

# 错误写法:试图检测数字
try:
    print(3 in version_str)
except TypeError as e:
    print(f"捕获异常: {e}")

# 正确写法:显式转为字符串后再检测
print(str(3) in version_str)True
3. 大小写敏感与空字符串恒真特性
字符串的成员检测严格区分大小写。如果需要进行不区分大小写的检索,必须在判断前通过 .lower() 或 .upper() 将两侧字符串统一规范化:
filename = "Data_Report.PDF"

# 大小写不匹配返回 False
print(".pdf" in filename)                # 输出 False

# 正确的规范化比对方式
print(".pdf" in filename.lower())        # 输出 True

# 空字符串恒为 True
print("" in filename)                    # 输出 True
print("" not in filename) # 输出 FalseTrue
True
False
四、列表与字符串在匹配机制与底层性能上的深度对比
理解 in 在列表与字符串中的底层实现,对于编写高效代码至关重要。两者的底层逻辑和复杂度特性如下:
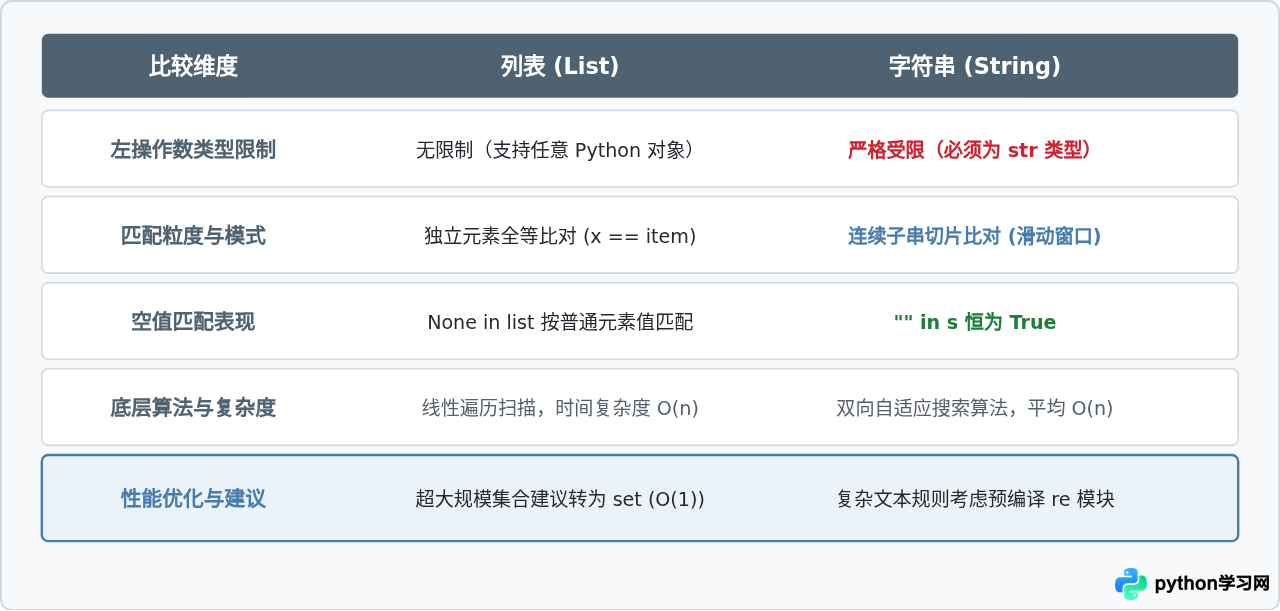
性能优化建议:为什么大列表不宜频繁用 in?
由于列表在内存中是连续指针数组,当执行 item in my_list 时,解释器必须从第一个元素逐一比对至末尾。当列表包含百万级元素且目标值位于尾部或不存在时,耗时将显著增加。
若业务场景涉及高频次成员检测,应将数据结构转换为基于哈希表实现的集合(set)或字典(dict),将查找复杂度从 O(n) 降至 O(1):
# 性能优化模式演示
large_list = list(range(1_000_000))
target = 999_999

# 方式一:列表成员检测(线性扫描,随着规模增大耗时明显)
found_in_list = target in large_list

# 方式二:转换为集合检测(哈希查找,常数时间复杂度)
lookup_set = set(large_list)
found_in_set = target in lookup_set

print(f"列表比对结果: {found_in_list}, 集合比对结果: {found_in_set}")五、常见易错陷阱与排错指引
1. 误写否定运算符顺序
在 Python 中,not x in y 与 x not in y 具有相同的运算结果,因为 in 运算符的优先级高于 not。但是,写成 not x in y 容易引起代码阅读歧义(常被初学者误以为是先求 not x 再检查),因此强烈建议遵循 PEP 8 规范,始终使用 x not in y。
编码规范建议:统一书写 if key not in mapping:,避免书写 if not key in mapping:。
2. 忘记处理字符串首尾空白字符
从外部文件、API 或表单中获取的字符串经常带有看不见的换行符(
)或空格,这会导致子串比对失败:
user_input = " admin
"
roles = "admin,editor,guest"

# 未清除空格导致匹配失败
print(user_input in roles)              # 输出 False

# 正确做法:先执行 strip() 剔除首尾空白
print(user_input.strip() in roles) # 输出 TrueTrue
3. 在数字包含判断中遗忘类型转换
在判断用户手机号、订单号、HTTP状态码等字段时,最常出现的运行时异常就是将整型数字直接用于字符串检测:
status_code = 404
allowed_codes = "200, 201, 204, 301, 302"

# 错误写法: status_code in allowed_codes (抛出 TypeError)
# 正确写法:
if str(status_code) not in allowed_codes:
print(f"状态码 {status_code} 不在允许列表中")六、总结与判断决策表
在编写业务逻辑时,可以根据以下具体决策路径选择恰当的数据结构与成员运算符:
| 需求场景 | 推荐操作方式 | 关键注意事项 |
|---|---|---|
| 检查特定元素是否属于某离散选项 | element in [item1, item2, ...] |
比对是独立的 ==;若选项超过数千项且频繁查询,转用 set。 |
| 检查文本中是否包含指定关键词 | keyword.lower() in text.lower() |
确保两侧均为 str 类型;若要求不区分大小写须显式转换。 |
| 判断某个子序列是否连续出现在原序列中 | 字符串直接使用 sub in s;列表需使用切片或双指针 |
列表的 in 不支持子切片匹配,切勿使用 [a, b] in [a, b, c]。 |
| 确保某项数据不重复追加 | if item not in collection: collection.append(item) |
列表追加操作保持原有插入顺序;若无需保持顺序,直接使用 set.add() 更高效。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









