

Python常用数据类型定义语法与基本操作示例

导读说明:编写 Python 程序的核心工作就是组织和处理数据。掌握基本数据类型(整数、浮点数、布尔值、字符串)与复合容器类型(列表、元组、字典、集合)的定义语法与常用操作,是编写高效、健壮 Python 代码的前提。本文通过具体语法规则、可执行代码范例与结构图解,系统梳理每种类型的特性、关键操作与避坑要点。
假设我们正在开发一个电商后台的用户订单结算脚本:程序需要记录订单ID(整数)、实付总额(浮点数)、是否包邮(布尔值)、收货地址(字符串)、购买商品清单(列表)、不可篡改的初始运单模板(元组)、商品唯一类别标签(集合),以及包含多维度参数的用户信息(字典)。如果类型选用不恰当,或者对类型的可变性(Mutability)理解有偏差,就容易在程序运行过程中引发意外的数据篡改、哈希错误或性能衰减。
一、Python 核心数据类型分类与内存特性
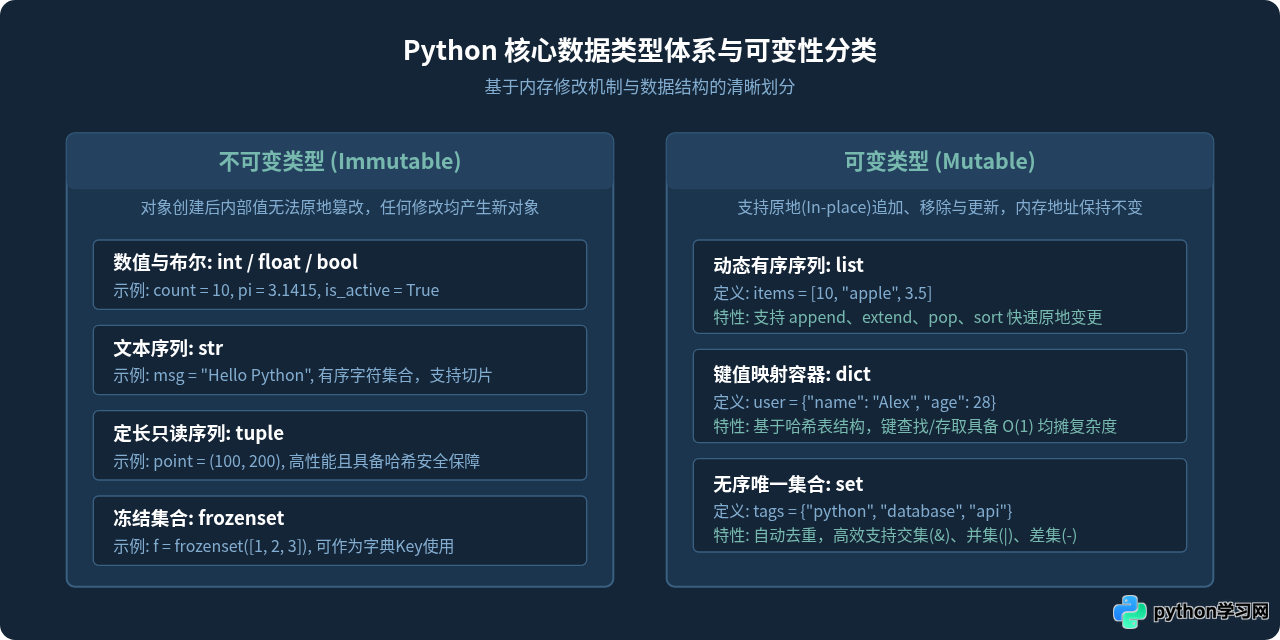
Python 是一门面向对象、动态类型的语言。每一个变量在内存中都指向一个具体的对象实例。按照数据在创建后是否允许就地修改,Python 的核心内置数据类型可以划分为两大类:不可变类型(Immutable)与可变类型(Mutable)。
- 不可变类型:包括整数(
int)、浮点数(float)、布尔值(bool)、字符串(str)和元组(tuple)。当对不可变对象进行修改运算时,Python 会在内存中开辟新空间并返回全新的对象指针,原对象不会改变。 - 可变类型:包括列表(
list)、字典(dict)和集合(set)。可变类型支持直接就地添加、删除或修改内部元素,对象的内存地址(id)保持不变。
二、标量基础类型:数值(int/float/bool)与文本(str)
标量类型用于表示最基础的离散值或文本单元。Python 的数值计算自动支持高精度与动态类型转换。
1. 整数(int)、浮点数(float)与布尔值(bool)
Python 3 中的整数具备任意精度,不会因整型溢出导致报错;浮点数遵循 IEEE 754 双精度标准;布尔值则是整型的子类,True 等价于数值 1,False 等价于数值 0。
# 整数与浮点数定义
user_id = 10086
unit_price = 49.9
discount_rate = 0.85

# 基础算术运算
total_amount = unit_price * discount_rate   # 乘法:42.415
rounded_amount = round(total_amount, 2)     # 保留两位小数:42.42
int_quotient = 10086 // 100                 # 整除:100
remainder = 10086 % 100                     # 取模:86

# 布尔判断
is_vip = True
is_free_shipping = total_amount >= 50       # 结果为 False
print(f"实付金额: {rounded_amount}, 是否包邮: {is_free_shipping}")
2. 字符串(str)的定义与核心操作
字符串是由单引号 ''、双引号 "" 或三引号 """ """ 包裹的不可变字符序列。三引号通常用于多行文本或函数文档注释。
# 字符串定义与 f-string 格式化
product_name = "机械键盘 G913"
vendor = "Logitech"
desc = f"【{vendor}】{product_name} - 旗舰级无线矮轴"

# 字符串切片语法:str[start:stop:step]
sku_code = "SKU-2026-CHERRY-01"
prefix = sku_code[:3]          # "SKU"
year_part = sku_code[4:8]      # "2026"

# 常用字符串清洗与转换方法
raw_input = "   admin@domain.com \n"
clean_email = raw_input.strip()            # 去除前后空白字符: "admin@domain.com"
domain = clean_email.split("@")[1]         # 分割为列表并提取: "domain.com"
path_segments = ["usr", "local", "bin"]
joined_path = "/".join(path_segments)      # 拼接为: "usr/local/bin"
replaced_text = clean_email.replace("domain.com", "enterprise.org")

print(f"清洗后邮箱: {clean_email}, 拼接路径: {joined_path}")
三、通用操作生命周期:从定义、检验到转换
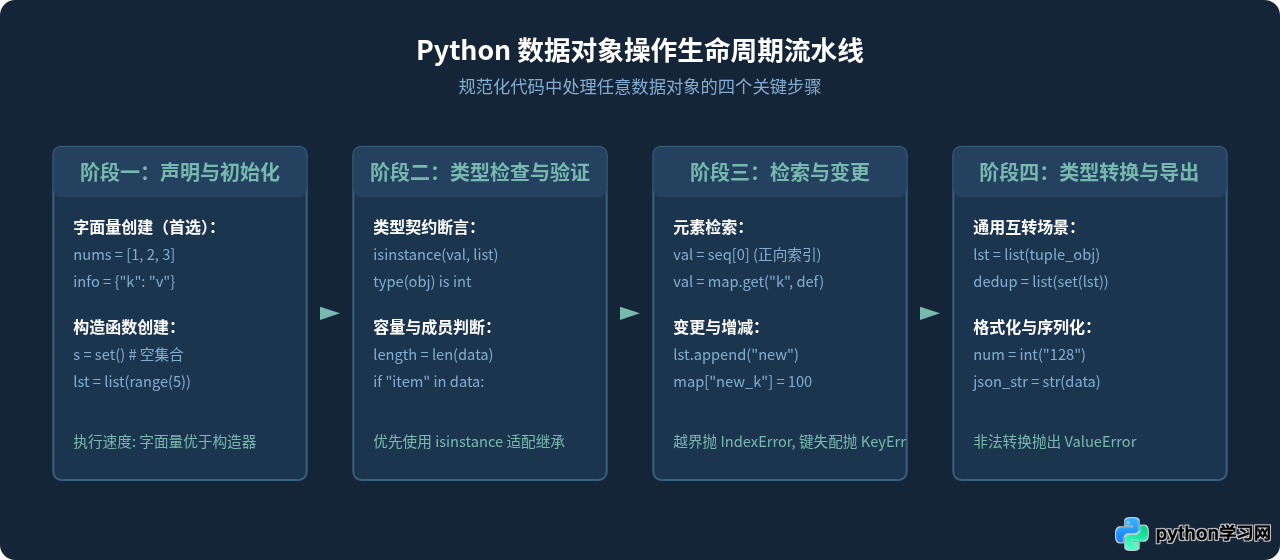
处理各类 Python 数据对象时,开发者通常遵循统一的操作链路:通过字面量初始化对象、使用内置函数校验类型与长度、通过索引/键执行读取与变更,最后按业务需要完成类型转换。
四、序列容器:列表(list)与元组(tuple)
列表和元组均按线性顺序存储数据,支持通过数字索引访问。二者最关键的区别在于是否允许修改。
1. 列表(list):动态增删与列表推导式
列表是 Python 中最常用的可变序列。方括号 [] 是其标准定义方式。
# 1. 列表初始化
shopping_cart = ["无线鼠标", "机械键盘", "4K显示器"]

# 2. 元素修改与追加
shopping_cart.append("Type-C扩展坞")            # 末尾追加元素
shopping_cart.insert(1, "人体工学椅")           # 指定索引位置插入
shopping_cart[0] = "蓝牙双模鼠标"               # 覆盖更新指定索引元素

# 3. 元素移除
removed_item = shopping_cart.pop()             # 弹出末尾元素并返回: "Type-C扩展坞"
shopping_cart.remove("机械键盘")                # 按照值查找并移除第一个匹配项

# 4. 列表切片与推导式 (List Comprehension)
scores = [78, 92, 85, 64, 99, 58]
# 筛选出大于或等于80的分数并赋予等级
high_scores = [s for s in scores if s >= 80]  # [92, 85, 99]

print(f"购物车清单: {shopping_cart}, 高分列表: {high_scores}")
2. 元组(tuple):安全只读与结构解包
元组使用小括号 () 定义。创建后内部元素禁止重新赋值。注意:定义单元素元组时必须包含尾随逗号,如 single = (42,),否则会被 Python 解释器识别为普通的括号表达式。
# 1. 元组定义
server_endpoint = ("192.168.1.100", 8080)
single_tuple = ("admin",)                      # 必须包含逗号

# 2. 尝试修改会引发 TypeError
try:
    server_endpoint[1] = 9000
except TypeError as e:
    print(f"元组不可修改异常捕获: {e}")

# 3. 序列解包 (Unpacking)
host, port = server_endpoint
print(f"服务主机: {host}, 监听端口: {port}")

# 4. 函数返回多个值的本质就是返回元组
def get_system_stat():
    cpu_usage = 23.5
    mem_usage = 68.2
    return cpu_usage, mem_usage                 # 隐式打包为元组 (23.5, 68.2)

cpu, mem = get_system_stat()                    # 优雅解包
五、哈希容器:字典(dict)与集合(set)
字典与集合底层均依赖哈希表(Hash Table)实现,能够在 $O(1)$ 的时间复杂度内完成键查找与元素存在性判断。
1. 字典(dict):键值对映射与安全访问
字典使用花括号 {key: value} 定义。在 Python 3.7+ 中,字典严格保持元素的插入顺序。字典的键必须是可哈希对象(即不可变类型),例如字符串、整数或仅包含不可变元素的元组。
# 1. 字典定义
order_payload = {
    "order_id": "ORD-20261021-001",
    "amount": 299.0,
    "status": "pending",
    "items_count": 3
}

# 2. 读取键值:避免直接使用 [] 导致 KeyError
status = order_payload.get("status", "unknown")
coupon = order_payload.get("coupon_code", None)  # 键不存在时返回默认值 None

# 3. 更新与新增
order_payload["status"] = "paid"                 # 修改已有键
order_payload["pay_time"] = "2026-10-21 09:30"   # 新增键

# 4. 字典遍历
for key, value in order_payload.items():
    # 遍历所有键值对
    pass
2. 集合(set):元素去重与集合运算
集合是无序且元素不可重复的容器。定义空集合必须使用 set(),若直接写 {} 则会被识别为空字典。
# 1. 集合定义与去重
raw_tags = ["python", "ai", "cloud", "python", "backend", "ai"]
unique_tags = set(raw_tags)                      # 自动去重: {'python', 'ai', 'cloud', 'backend'}

# 2. 增删元素
unique_tags.add("database")
unique_tags.discard("non_existent")              # discard 不存在时不抛出异常

# 3. 集合数学运算
set_a = {"python", "go", "rust"}
set_b = {"python", "java", "c++"}

union_set = set_a | set_b                       # 并集: 包含所有不重复元素
inter_set = set_a & set_b                       # 交集: {'python'}
diff_set = set_a - set_b                        # 差集: 在 A 中但不在 B 中 {'go', 'rust'}

print(f"唯一标签: {unique_tags}, 共有技术: {inter_set}")
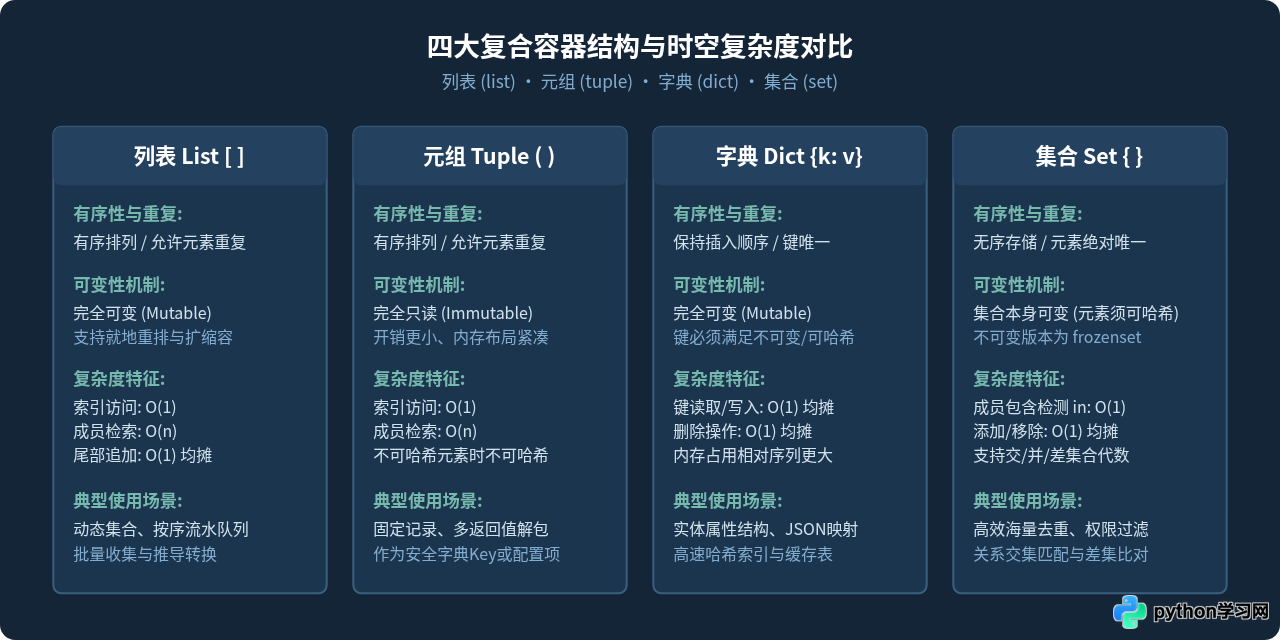
六、四大复合数据类型核心特征全方位对比
为了让不同类型之间的技术边界更加清晰,下表从语法符号、可变性、有序性、重复性及适用场景进行了直观整理:
七、必须防范的常见陷阱与编码规范
高频避坑建议:在日常 Python 开发中,大多数隐蔽 Bug 都源自对“可变对象引用传递”的忽略。务必熟记以下三个典型陷阱。
陷阱 1:使用可变对象作为函数默认参数
函数的默认参数在函数定义被解释执行时仅创建一次。如果默认参数是可变类型(如 [] 或 {}),多次调用将共享同一个对象。
# 错误示例:默认参数共享
def add_item_bad(item, container=[]):
    container.append(item)
    return container

print(add_item_bad("A"))  # 输出 ['A']
print(add_item_bad("B"))  # 意外输出 ['A', 'B'],而不是预期的 ['B']!

# 正确写法:使用不可变的 None 作为哨兵值
def add_item_good(item, container=None):
    if container is None:
        container = []
    container.append(item)
    return container

print(add_item_good("A"))  # 输出 ['A']
print(add_item_good("B"))  # 正确输出 ['B']
陷阱 2:在正向迭代遍历列表时修改其结构
在 for item in my_list: 循环体内直接执行 my_list.remove(...) 或 pop(),会导致内部索引位移,从而跳过后续元素。
nums = [10, 20, 25, 30, 40]
# 错误做法:在循环中直接 remove 会遗漏连续匹配项
# 正确做法 1:使用列表推导式生成全新筛选结果(推荐)
filtered_nums = [n for n in nums if n % 20 != 0]

# 正确做法 2:若必须在原列表上移除,倒序遍历索引
for i in range(len(nums) - 1, -1, -1):
    if nums[i] % 20 == 0:
        del nums[i]
陷阱 3:将可变对象误用作字典的 Key 或集合元素
由于字典和集合的快速定位依赖于对象的 __hash__ 方法,而可变对象的内容随时可能变化,因此它们是不可哈希的(Unhashable)。例如使用 list 作为字典的键会立即触发 TypeError: unhashable type: 'list'。若需要复合键,应使用 tuple 替代。
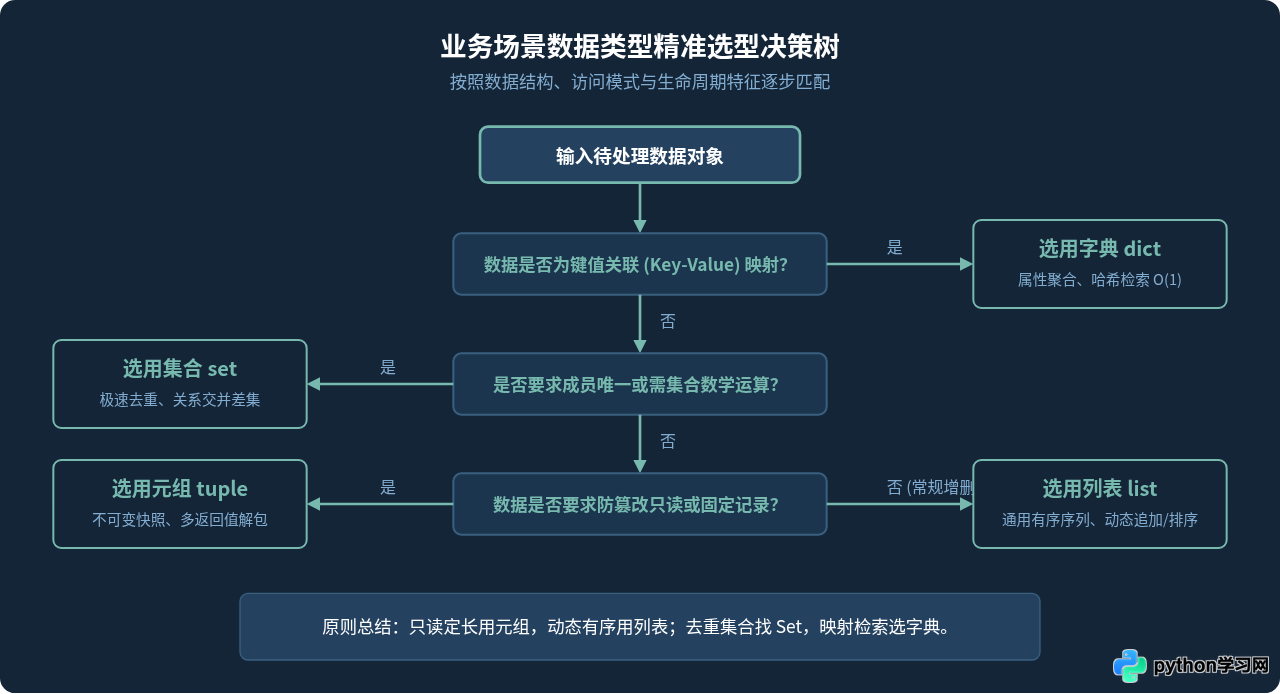
八、业务开发中的数据类型选型决策指南
面对具体业务需求时,可依照以下决策路径精准选择最适合的数据结构:
九、总结
合理选择并规范使用 Python 数据类型,是写出优雅且高运行效率代码的基础。在工程实践中,建议优先坚持以下四项准则:
- 优先采用字面量语法:使用
[]、{}、()创建容器,效率普遍优于显式调用list()、dict()等构造函数; - 警惕可变类型的副作用:在函数默认参数与多线程/共享上下文环境中,优先使用不可变类型(如
tuple、frozenset)或None哨兵机制,隔离意外修改; - 善用哈希结构的高效检索:对于高频的
in包含判断或去重操作,及时将列表转换为set,将算法复杂度从 $O(n)$ 降为 $O(1)$; - 借助类型标注提升工程质量:在现代 Python 项目中,结合
typing模块(如List[str]、Dict[str, Any]、Optional[int])明确数据结构契约,能显著降低团队协作中的调试成本。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









