

Python定时任务库选型对比:APScheduler、Celery与schedule适用场景
schedule,还是配置细致的 APScheduler,亦或是工业级的 Celery?这三个库代表了三种完全不同的架构设计哲学:schedule 专注于单进程轻量轮询;APScheduler 专注于单机进程内的功能完备型调度引擎;Celery 则是面向大规模解耦与高并发计算的分布式任务队列系统。理解三者的本质差异与适用边界,才能在业务发展中选对工具,避免过度设计或架构受限。
一、三大定时任务库的核心定位与架构机制
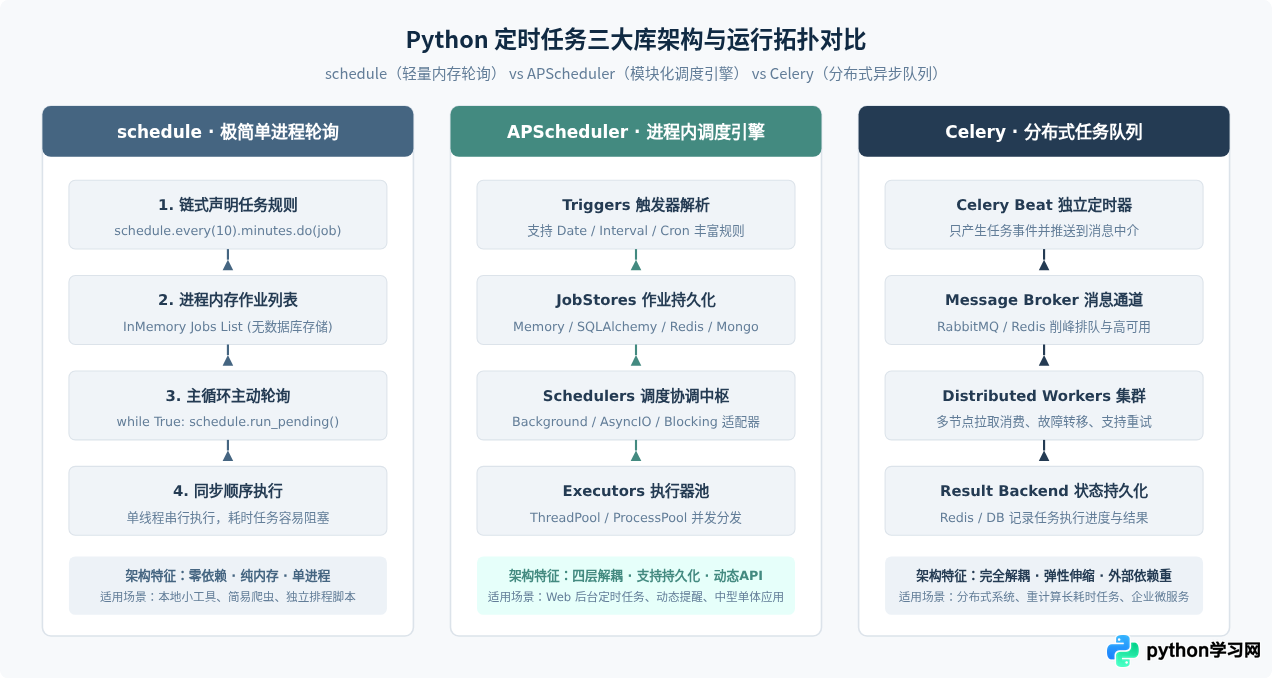
选择定时任务方案的前提,是明确任务在操作系统和应用拓扑中由谁触发、在何处排队、由谁执行。schedule、APScheduler 和 Celery 在组件构成与运行模型上存在本质区别:
-
schedule:采用极简的单线程循环轮询设计。它不依赖任何外部进程或第三方服务,开发者使用自然语言风格的流式 API 注册任务后,必须由主进程主动维护一个
while True循环,并在循环体内周期性调用run_pending()。任务全部存储在进程内存中,一旦进程崩溃或重启,所有任务状态直接丢失。 - APScheduler(Advanced Python Scheduler):基于模块化思想构建的进程内调度引擎。它拆分为四大核心组件:Triggers(触发器)负责决定任务下次执行时机(支持 Date、Interval 和标准 Cron 表达式);JobStores(作业存储)负责持久化任务信息(支持内存、SQLAlchemy、Redis、MongoDB 等);Executors(执行器)负责将任务分发到线程池或进程池中并发执行;Schedulers(调度器)协调上述三大组件并与应用环境(如 BackgroundScheduler、AsyncIOScheduler、BlockingScheduler)结合。
- Celery:面向高并发与分布式拓扑的异步任务队列。其定时调度功能由独立的 Celery Beat 服务驱动。Celery Beat 不负责执行具体的业务任务,它只根据预设的定时表(Crontab 或 Schedule)定期向 Message Broker(消息中间件,如 RabbitMQ 或 Redis) 发送任务指令;随后分布在集群各节点上的 Celery Worker 竞争消费并执行任务,最终将状态回写至 Result Backend。
二、典型代码实现与运行方式实操
为了具体感受三个库在使用心智和运维成本上的差异,下面通过标准示例展示它们各自的代码组织方式。
1. schedule:声明式链式语法
schedule 的优势在于可读性极高,几乎像自然语言一样配置定时规则。安装仅需 pip install schedule。
import time
import schedule

def send_daily_report():
    print(f"[{time.strftime('%Y-%m-%d %H:%M:%S')}] 正在生成并发送每日汇总报表...")

def clear_cache():
    print(f"[{time.strftime('%Y-%m-%d %H:%M:%S')}] 正在清理系统临时缓存...")

# 声明任务规则(支持链式配置)
schedule.every(10).seconds.do(clear_cache)
schedule.every().day.at("09:30").do(send_daily_report)

print("定时轮询服务已启动,按 Ctrl+C 退出...")

# 必须由开发者手动驱动事件循环
while True:
    schedule.run_pending()
    time.sleep(1)
[2026-10-26 10:00:10] 正在清理系统临时缓存...
[2026-10-26 10:00:20] 正在清理系统临时缓存...
schedule 是默认在单线程中顺序运行任务的。如果 send_daily_report() 执行耗时达 30 秒,后续所有任务都将被延后 30 秒,无法准点触发。若需并发执行,必须自行使用 threading.Thread 包装任务函数。
2. APScheduler:工程化配置与持久化调度
APScheduler 不需要外部 Broker,但具备完善的并发线程池与持久化能力。安装命令为 pip install apscheduler sqlalchemy。以下代码演示如何在后台运行,并将任务作业持久化到 SQLite 数据库中,即便程序重启,已注册的定时规则依然有效:
import time
from apscheduler.schedulers.background import BackgroundScheduler
from apscheduler.jobstores.sqlalchemy import SQLAlchemyJobStore
from apscheduler.executors.pool import ThreadPoolExecutor

def sync_order_status(source: str):
    print(f"[{time.strftime('%Y-%m-%d %H:%M:%S')}] 正在同步渠道 [{source}] 的订单状态...")

# 1. 配置作业存储(支持持久化至 SQLite)
jobstores = {
    'default': SQLAlchemyJobStore(url='sqlite:///jobs.sqlite')
}

# 2. 配置并发执行器(最多允许 10 个线程同时执行任务)
executors = {
    'default': ThreadPoolExecutor(max_workers=10)
}

job_defaults = {
    'coalesce': True,            # 任务积压时仅执行一次最新任务
    'max_instances': 1           # 相同任务同一时间只允许一个实例运行
}

# 3. 初始化并启动后台调度器
scheduler = BackgroundScheduler(jobstores=jobstores, executors=executors, job_defaults=job_defaults)
scheduler.start()

# 4. 注册任务(Cron 触发器,每天 02:00 执行;或间隔触发器)
scheduler.add_job(
    sync_order_status,
    trigger='interval',
    seconds=15,
    args=['WeChat_Pay'],
    id='sync_wechat_orders',
    replace_existing=True
)

print("APScheduler 后台调度线程已启动,主线程可继续处理 Web 业务或保持存活。")
try:
    while True:
        time.sleep(2)
except (KeyboardInterrupt, SystemExit):
    scheduler.shutdown()
    print("调度器安全关闭。")
[2026-10-26 10:00:15] 正在同步渠道 [WeChat_Pay] 的订单状态...
[2026-10-26 10:00:30] 正在同步渠道 [WeChat_Pay] 的订单状态...
3. Celery:分布式定时调度(Celery Beat + Worker)
Celery 将“定时计算”与“任务执行”彻底解耦。首先在 tasks.py 中定义任务与定时配置:
from celery import Celery
from celery.schedules import crontab

# 初始化 Celery 应用,指定 Redis 为 Broker 和 Backend
app = Celery('proj_tasks', broker='redis://127.0.0.1:6379/0', backend='redis://127.0.0.1:6379/1')

@app.task
def generate_monthly_invoice(user_id: int):
    # 此处为耗时计算、生成 PDF 或调用外部接口
    print(f"正在为用户 {user_id} 结算月度账单并生成报表...")
    return f"Invoice_User_{user_id}_Success"

# 配置周期性调度表(Beat Schedule)
app.conf.beat_schedule = {
    'monthly-invoice-every-midnight': {
        'task': 'tasks.generate_monthly_invoice',
        'schedule': crontab(hour=0, minute=0),  # 每天午夜 00:00 投递
        'args': (1001,),
    },
    'health-check-every-minute': {
        'task': 'tasks.generate_monthly_invoice',
        'schedule': 60.0,                      # 每 60 秒投递一次
        'args': (9999,),
    }
}
运行 Celery 需要分别启动执行 Worker 与调度 Beat:
# 启动任务消费 Worker 节点(可在多台服务器上启动多个)
celery -A tasks worker --loglevel=info -c 4

# 启动定时触发节拍器 Beat(在整个集群中必须且仅能运行一个实例)
celery -A tasks beat --loglevel=info
三、核心选型维度深度对比
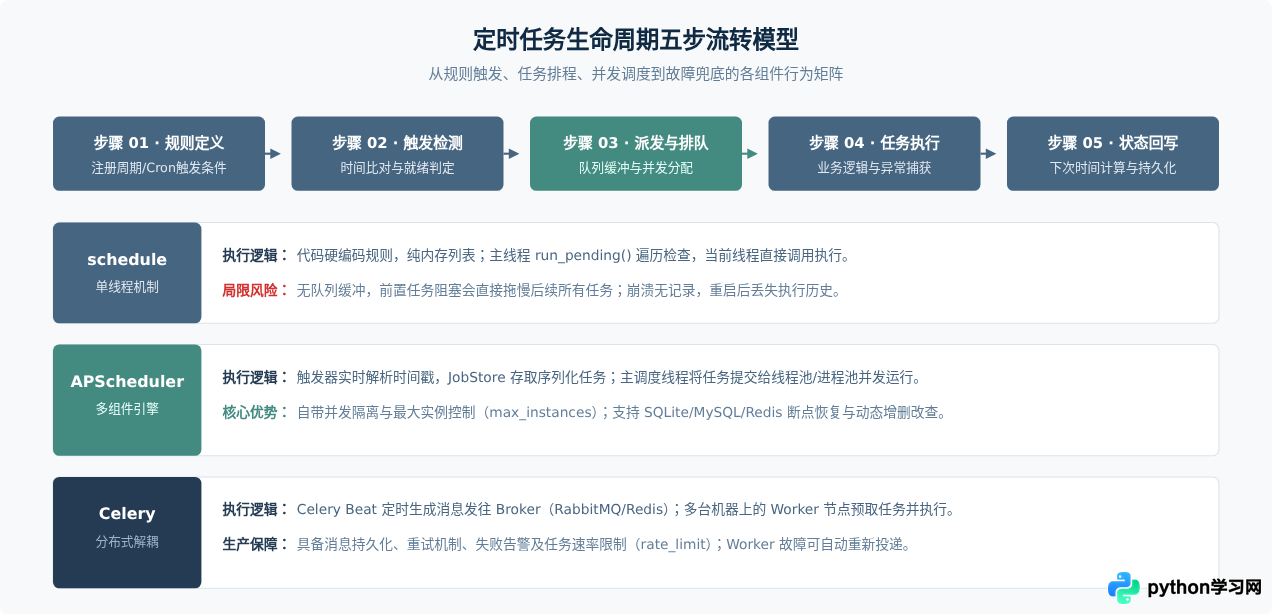
技术选型不能脱离具体的系统约束。以下围绕架构设计中最为关心的六大维度进行逐项解析:
1. 规则表达丰富度(Cron 语法与一次性任务)
在业务场景中,定时需求往往非常复杂,例如“每月最后一个周五下午 17:00 执行”或“30 分钟后执行一次并销毁”。schedule 仅支持固定的间隔与简单时间点匹配,无法原生解析复杂的 Crontab 表达式;而 APScheduler 和 Celery 原生提供标准的 Cron 触发器。特别地,APScheduler 的 DateTrigger 允许精确安排单次未来时间的任务,适合“订单 15 分钟未支付自动取消”等延迟任务。
2. 任务状态持久化与断点自愈
如果服务器发生宕机、代码热部署重启,未执行的任务是否会丢失?
schedule的任务注册完全留在内存变量中,进程退出即销毁。APScheduler提供了成熟的JobStore抽象。配置数据库存储后,任务参数、下次执行时间均序列化落盘。当调度服务重启时,会自动加载数据库中未过期的任务,并通过misfire_grace_time容忍时间窗口补跑错过的调度。Celery的 Beat 调度配置一般固化在代码中,或配合django-celery-beat将定时规则存入关系型数据库。由于任务派发至持久化 Broker(如 RabbitMQ),即便 Worker 节点重启,未 ACK 的任务也不会丢失。
3. 运行时动态增删任务的能力
不少业务系统需要“由前台用户界面配置一个定时抓取规则或提醒通知”。
在 APScheduler 中,调度器提供了开箱即用的 add_job()、modify_job()、pause_job()、remove_job() 等 API,非常容易封装为 RESTful 接口对外提供服务。
而 schedule 缺乏对单个任务的精确句柄持久索引;Celery 原生的配置文件方式不支持动态修改,若需动态添加定时任务,必须引入额外的外部扩展插件(如 django-celery-beat 或 celery-redbeat),增加了系统依赖。
4. 基础设施与运维部署成本
schedule 与 APScheduler 均为纯 Python 库,在目标机上执行 pip install 即可直接内嵌在主业务中启动,零外部基础设施依赖。
而 Celery 必须搭建并运维至少一套高可用的消息中介服务(如 Redis 哨兵或 RabbitMQ 集群),同时在部署上需要分离 Web 进程、Celery Beat 进程与 Celery Worker 集群,对于中小型团队而言,运维复杂度成倍上升。
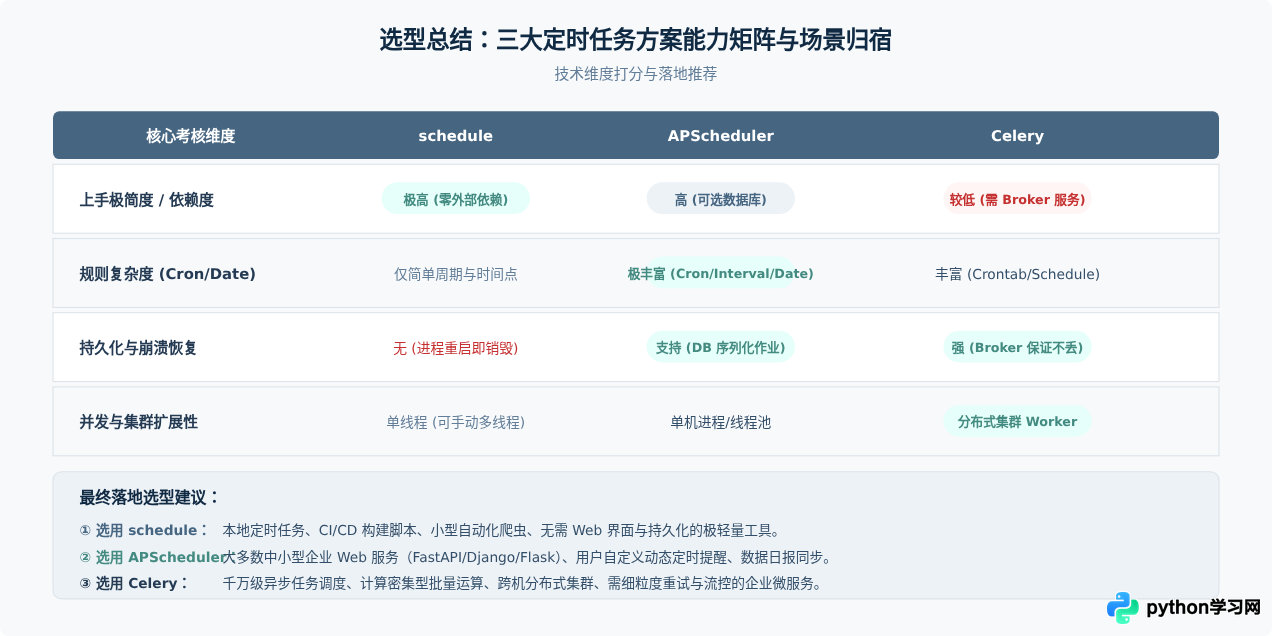
四、三大库核心功能与指标对比矩阵
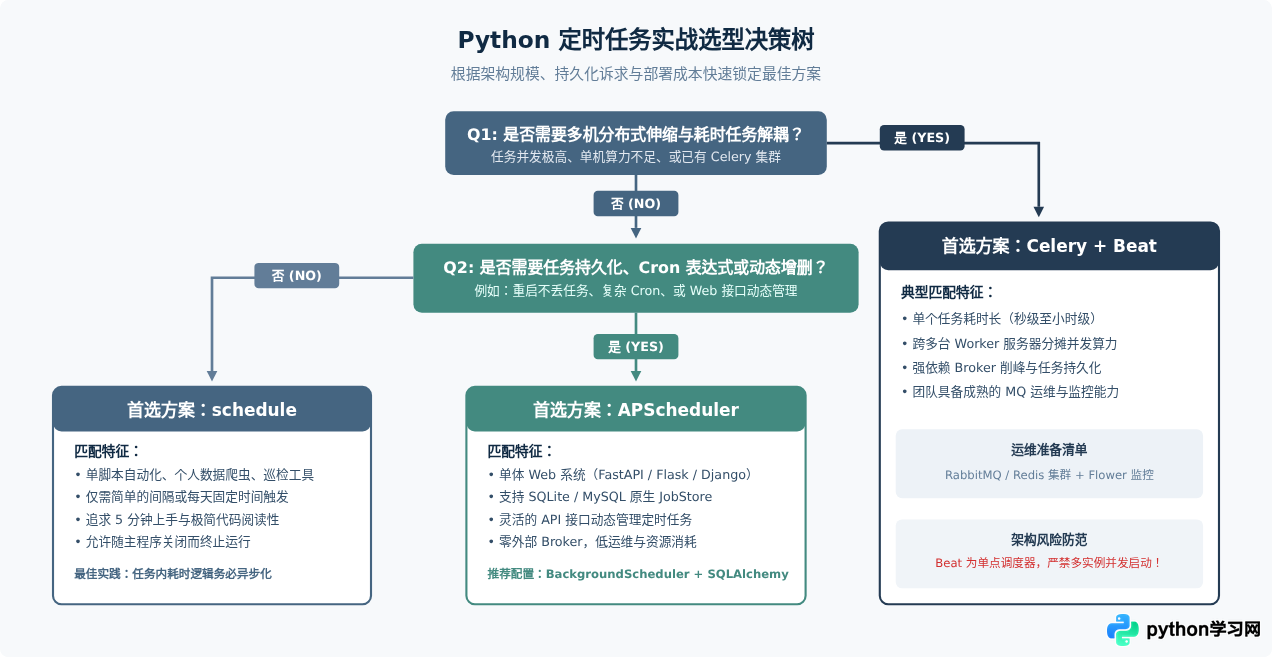
为了便于快速对照关键技术参数,下表系统梳理了三者在架构级别、并发控制、外部依赖与容灾指标上的综合表现:
| 评估维度 | schedule | APScheduler | Celery (含 Celery Beat) |
|---|---|---|---|
| 定位与适用层级 | 轻量单进程任务轮询器 | 功能完备的进程内调度引擎 | 企业级分布式异步任务队列 |
| 外部组件依赖 | 零依赖(纯 Python 代码) | 零依赖(可选 SQLite/MySQL/Redis) | 强依赖 Message Broker(RabbitMQ/Redis) |
| 触发规则支持 | 仅支持简单时间间隔、每天/每周时间点 | 支持 Date(一次性)、Interval、完整 Cron | 支持简单间隔、Crontab 表达式 |
| 并发执行能力 | 默认单线程阻塞,需手动封装多线程 | 内置 ThreadPool / ProcessPool / AsyncIO | 多机器多 Worker 进程,并发能力强悍 |
| 任务持久化能力 | 无持久化,进程销毁全部丢失 | 原生支持 SQLAlchemy / Mongo / Redis 作业存储 | 任务排队在持久化 Broker 中,结果存入 Backend |
| 动态任务管理 | 仅支持在运行时通过代码集合操作 | 提供丰富的 add/modify/pause/resume/remove API | 需搭配 django-celery-beat 或 Redis 扩展 |
| 部署与学习成本 | 极低,5 分钟上手即可投产 | 较低,需理解组件模型(Trigger/Store) | 高,需要维护 Beat、Worker、Broker 与监控体系 |
五、工程实践中的避坑指南
在实际生产环境中落地定时任务时,除了选择合适的库,还需注意以下常见陷阱:
1. APScheduler 在多 Worker(如 Gunicorn / Uvicorn)部署下的“重复执行”问题
在部署 Web 服务时,开发者通常会使用 gunicorn -w 4 app:app 启动 4 个工作进程。若在应用初始化代码中直接实例化并启动 BackgroundScheduler,会导致 4 个 Worker 进程各自运行独立的调度器,从而导致同一个定时任务在触发时刻被并发执行 4 次。
② 若必须放在 Web 进程中,可借助操作系统文件锁(如
fcntl)或 Redis 分布式锁,确保仅有获得锁的单一 Worker 启动调度器;③ 使用 Gunicorn 的
post_worker_init 或单节点专职容器运行调度。
2. Celery Beat 的单点限制与时区陷阱
与 Celery Worker 可以多机随意横向扩展不同,Celery Beat 必须是整个拓扑中的单点。如果在集群部署时不慎启动了多个 Beat 副本,消息队列中将收到多份重复的周期任务消息。另外,配置 Crontab 时务必在 settings 中显式统一 timezone = 'Asia/Shanghai' 与 enable_utc = False,否则系统默认按 UTC 时间判定,会导致日常触发时间发生 8 小时的严重偏差。
3. schedule 运行阻塞导致的任务积压雪崩
schedule 是最容易因单个任务阻塞而引发故障的库。由于其主循环是同步轮询机制,如果在某个任务中调用了没有设置超时参数的 HTTP 请求或耗时数据库查询,run_pending() 将被完全卡住。一旦卡住超过数小时,等到该请求超时返回后,积压的数百次任务将一拥而上执行,引发级联雪崩。因此,使用 schedule 时,每个任务函数内部必须设置严格的 timeout,或通过 threading.Thread(target=job).start() 释放主循环线程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









