

Python多线程编程完整代码实例:使用threading并发执行任务
本文提供Python标准库threading模块的完整代码实例,详细讲解如何创建和启动线程、传递参数、使用join等待任务完成、互斥锁Lock防止数据竞争,以及使用Queue安全收集并发结果。
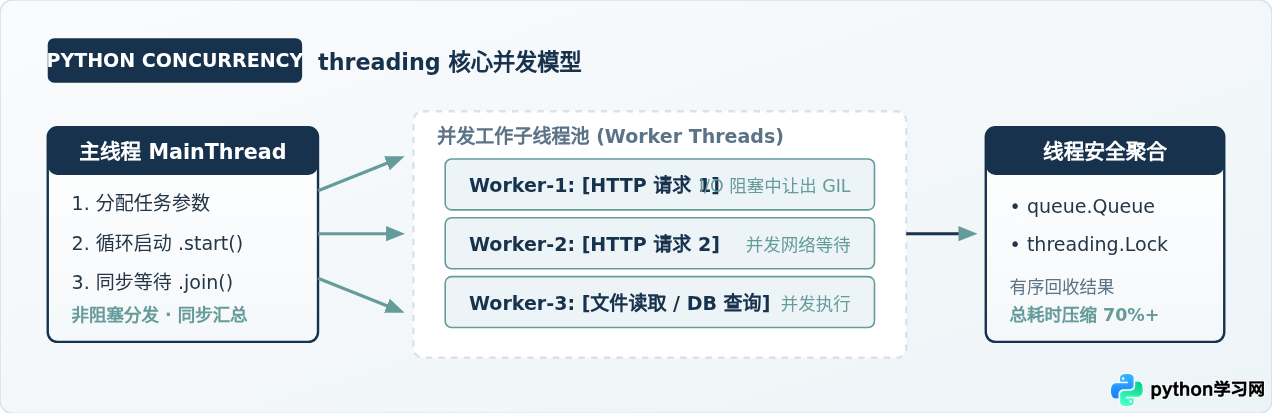
在 Python 中执行多个网络请求、下载文件或批量读取接口等 I/O 密集型任务时,若采用单线程串行方式逐个执行,程序的大部分时间都在闲置等待网络响应或磁盘应答。使用 Python 标准库内置的 threading 模块,可以轻松创建并并发运行多个线程,让多个耗时任务在等待期间交替推进,从而成倍缩短程序总耗时。本文将通过具体可执行的代码实例,详细演示如何定义工作任务、实例化并启动子线程、使用 join() 同步等待任务结束、使用互斥锁 Lock 避免数据冲突,以及使用线程安全队列 Queue 收集多线程执行结果。
一、threading 的并发机制与适用场景
在开始写代码前,需要明确 Python 多线程的适用边界与底层行为:
- GIL(全局解释器锁)的作用与影响:标准 CPython 解释器拥有全局解释器锁(GIL),保证同一时刻只有一个线程在执行 Python 原生字节码。这意味着 Python 多线程无法利用多核 CPU 加速纯算术计算(如循环大数组加法、密码暴力破解等 CPU 密集型任务)。
- 为什么多线程对 I/O 任务非常有效:当某个线程进行
socket.recv、requests.get、time.sleep或读写磁盘时,该线程会主动释放 GIL,让给其他就绪的线程执行。因此,多个网络请求或磁盘等待可以“同时”进行,大幅压减整体等待时长。
二、使用 threading 模块的标准操作步骤
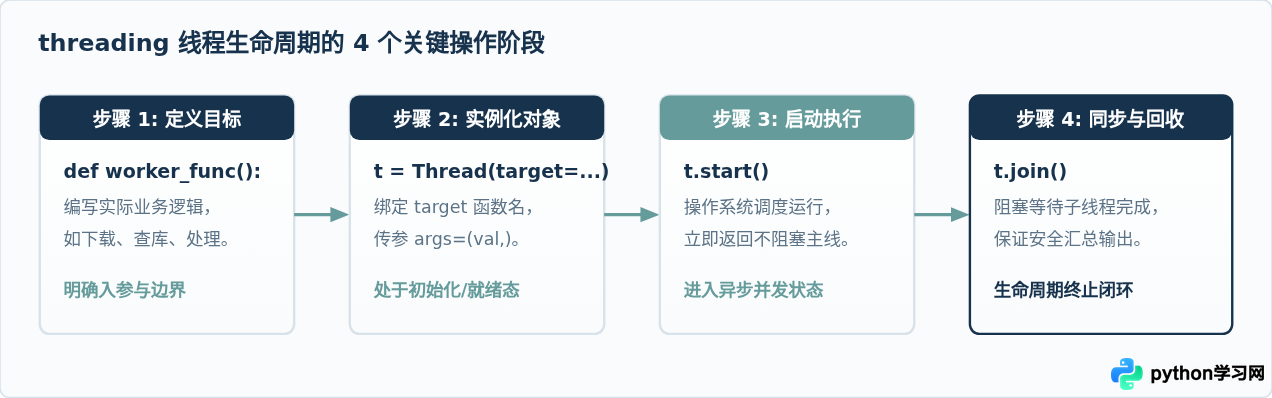
编写一个标准的多线程程序,通常包含以下 4 个清晰步骤:
- 定义任务函数:编写子线程需要执行的具体函数,支持接收位置参数(
args)和关键字参数(kwargs)。 - 实例化 Thread 对象:使用
threading.Thread(target=函数名, args=(参数1, 参数2))构建线程对象。注意args必须是元组,若只有一个参数需写成(arg1,)。 - 启动线程:调用线程对象的
start()方法。此操作会通知操作系统创建线程并在后台开始运行目标函数,主线程不会在此停留。 - 同步等待子线程完成:调用线程对象的
join()方法。主线程会在此处阻塞挂起,直到该子线程执行完毕才继续向下运行。这是确保所有异步任务全部就绪后再统一处理后续逻辑的关键。
三、完整代码实例 1:并发执行多项 I/O 任务
下面是一个完整可运行的实例。我们模拟向 4 个不同目标发起网络请求(每个请求耗时 1.2 秒),对比多线程并发模式下的实际耗时:
import threading
import time

def fetch_data(task_id: int, duration: float):
    """
    模拟一个耗时的 I/O 任务(如网络请求或数据库查询)
    """
    thread_name = threading.current_thread().name
    print(f"[{time.strftime('%H:%M:%S')}] 线程 {thread_name} 开始执行任务 #{task_id}...")

    # 模拟网络等待阻塞,此时解释器会释放 GIL,允许其他线程交替运行
    time.sleep(duration)

    print(f"[{time.strftime('%H:%M:%S')}] 线程 {thread_name} 完成任务 #{task_id} (耗时 {duration}s)")

def main():
    start_time = time.time()

    # 定义 4 个并发任务的参数 (任务编号, 模拟耗时)
    tasks = [
        (1, 1.2),
        (2, 1.2),
        (3, 1.2),
        (4, 1.2),
    ]

    threads = []

    # 1. 批量创建并启动子线程
    for task_id, duration in tasks:
        t = threading.Thread(
            target=fetch_data,
            args=(task_id, duration),
            name=f"Worker-{task_id}"
        )
        threads.append(t)
        t.start()  # 启动线程,立即进入操作系统调度

    print(f"[{time.strftime('%H:%M:%S')}] 主线程已分派所有子任务,等待全部执行完毕...")

    # 2. 依次调用 join() 确保所有子线程均已执行完成
    for t in threads:
        t.join()  # 阻塞等待对应的子线程执行结束

    total_cost = time.time() - start_time
    print(f"[{time.strftime('%H:%M:%S')}] 所有任务全部完成!实际总耗时: {total_cost:.2f} 秒")

if __name__ == "__main__":
    main()
[10:00:00] 线程 Worker-2 开始执行任务 #2...
[10:00:00] 线程 Worker-3 开始执行任务 #3...
[10:00:00] 线程 Worker-4 开始执行任务 #4...
[10:00:00] 主线程已分派所有子任务,等待全部执行完毕...
[10:00:01] 线程 Worker-1 完成任务 #1 (耗时 1.2s)
[10:00:01] 线程 Worker-2 完成任务 #2 (耗时 1.2s)
[10:00:01] 线程 Worker-3 完成任务 #3 (耗时 1.2s)
[10:00:01] 线程 Worker-4 完成任务 #4 (耗时 1.2s)
[10:00:01] 所有任务全部完成!实际总耗时: 1.21 秒
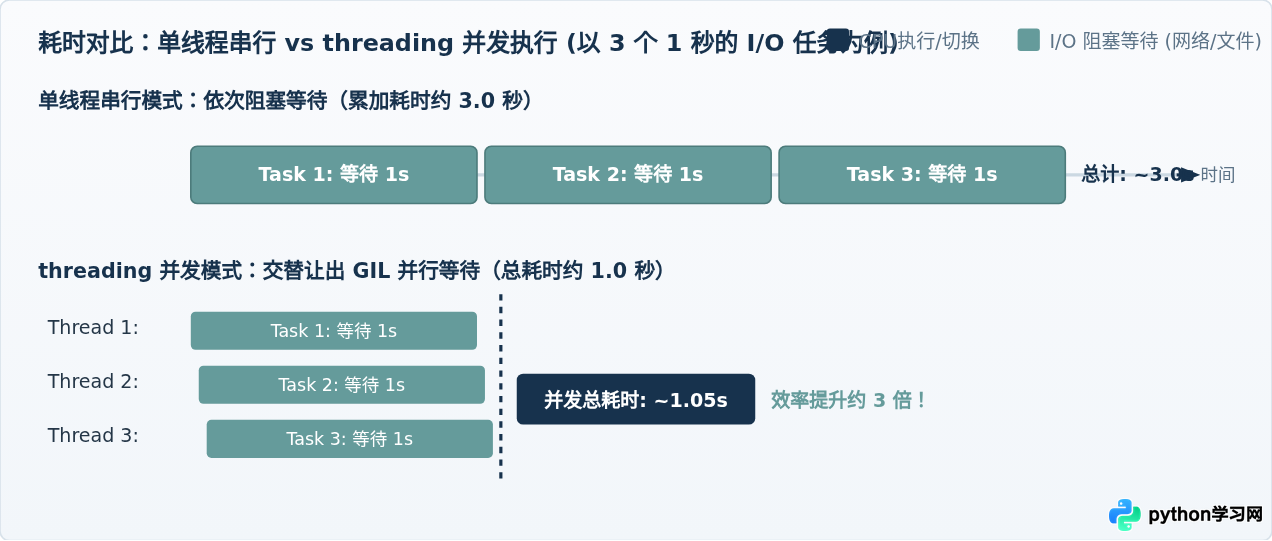
如果使用单线程顺序执行,4 个任务的总耗时将是 1.2 * 4 = 4.8 秒;而在 threading 并发下,4 个任务几乎在同一时间段内并行等待,实际总耗时仅约 1.21 秒,效率提升近 4 倍。
四、避免数据冲突:互斥锁(threading.Lock)与结果队列
多线程在带来并发速度的同时,也引入了新的问题:数据共享与竞争条件(Race Condition)。
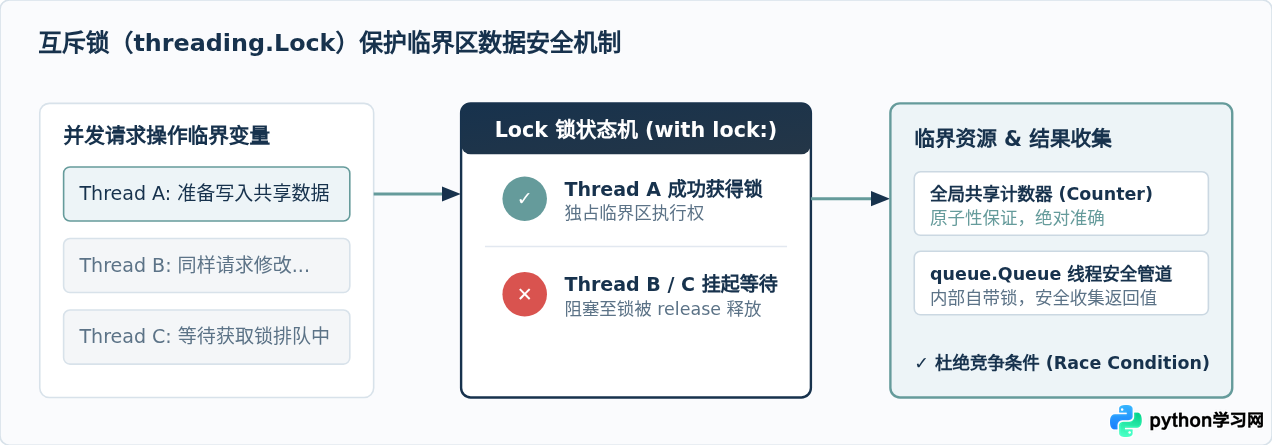
同一进程内的所有线程共享进程的内存空间。当多个线程同时对同一个全局变量进行“读取-计算-写回”操作时(例如 counter += 1),操作系统可能会在指令执行中途切换线程,导致部分更新被覆盖,最终计算结果小于预期。
1. 互斥锁(threading.Lock)的工作原理
为了保证临界区代码同一时刻只能有一个线程访问,我们使用 threading.Lock。推荐配合 Python 的 with lock: 上下文管理器语法,它能在代码块结束或抛出异常时自动释放锁,避免因忘记调用 lock.release() 导致的死锁。
2. 线程返回值与 queue.Queue 通信
threading.Thread 默认不会直接返回目标函数的 return 结果。要安全地在多线程中收集每个线程的处理成果或报错信息,推荐使用标准库的 queue.Queue。Queue 内部已经封装了线程同步锁,所有子线程可以直接执行 q.put(result),主线程再通过 q.get() 取出,无需开发者手动额外加锁。
3. 完整代码实例 2:带锁计数与结果聚合
import threading
import queue
import time

# 全局共享变量
shared_counter = 0
counter_lock = threading.Lock()  # 创建互斥锁
result_queue = queue.Queue()     # 创建线程安全队列

def worker_with_lock(task_id: int, loop_count: int):
    global shared_counter

    # 1. 模拟业务处理
    time.sleep(0.05)
    task_result = f"Task-{task_id} 处理完毕,数据指纹: {hash(task_id) % 10000}"

    # 2. 将返回结果写入线程安全队列
    result_queue.put((task_id, task_result))

    # 3. 操作共享计数器:使用 with lock 保证原子性
    with counter_lock:
        for _ in range(loop_count):
            shared_counter += 1

def main():
    threads = []
    task_count = 5
    loops_per_task = 100000

    print("启动多线程并发执行...")
    for i in range(1, task_count + 1):
        t = threading.Thread(
            target=worker_with_lock,
            args=(i, loops_per_task),
            name=f"WorkerThread-{i}"
        )
        threads.append(t)
        t.start()

    # 等待所有子线程结束
    for t in threads:
        t.join()

    # 4. 从 Queue 中汇总各个子线程的结果
    results = []
    while not result_queue.empty():
        results.append(result_queue.get())

    print("
--- 汇总执行报告 ---")
    print(f"预期计数器累加值: {task_count * loops_per_task}")
    print(f"实际计数器累加值: {shared_counter}")
    print(f"队列收集到任务返回数: {len(results)}")
    for tid, res in sorted(results):
        print(f"  * [结果] #{tid}: {res}")

if __name__ == "__main__":
    main()
--- 汇总执行报告 ---
预期计数器累加值: 500000
实际计数器累加值: 500000
队列收集到任务返回数: 5
* [结果] #1: Task-1 处理完毕,数据指纹: 8432
* [结果] #2: Task-2 处理完毕,数据指纹: 1209
* [结果] #3: Task-3 处理完毕,数据指纹: 7391
* [结果] #4: Task-4 处理完毕,数据指纹: 4518
* [结果] #5: Task-5 处理完毕,数据指纹: 9632
五、工程实践:ThreadPoolExecutor 线程池现代替代方案
虽然手动通过 threading.Thread 能清晰掌控线程创建的每一个细节,但在生产环境中若并发任务数达到成百上千个,直接无节制地创建几百个操作系统线程会导致极高的内存消耗与上下文切换开销。
Python 标准库在 concurrent.futures 模块中提供了 ThreadPoolExecutor。它底层同样使用 threading,但带来了显著优势:
- 池化复用:固定并发线程总数(例如
max_workers=5),当一个任务完成后自动拉取新任务,避免频繁创建和销毁线程的系统损耗。 - 直接获取返回值:通过
future.result()或executor.map()直接获取函数返回结果和异常,无需手动搭建队列。
from concurrent.futures import ThreadPoolExecutor, as_completed
import time

def process_url(url: str) -> dict:
    """模拟下载网页任务"""
    time.sleep(0.5)
    if "error" in url:
        raise ValueError(f"无法访问的无效链接: {url}")
    return {"url": url, "status": 200, "bytes": len(url) * 128}

def main():
    urls = [
        "https://api.example.com/item/1",
        "https://api.example.com/item/2",
        "https://api.example.com/item/error_node",
        "https://api.example.com/item/4",
    ]

    # 控制最多并发 3 个工作线程
    with ThreadPoolExecutor(max_workers=3) as executor:
        # 提交异步任务,返回 Future 对象字典
        future_to_url = {executor.submit(process_url, url): url for url in urls}

        # as_completed 谁先完成就先产出谁
        for future in as_completed(future_to_url):
            url = future_to_url[future]
            try:
                data = future.result()  # 直接拿到函数的 return 返回值
                print(f"[成功] {data['url']} -> 抓取成功 ({data['bytes']} bytes)")
            except Exception as exc:
                print(f"[失败] {url} -> 异常捕获: {exc}")

if __name__ == "__main__":
    main()
[成功] https://api.example.com/item/2 -> 抓取成功 (3968 bytes)
[失败] https://api.example.com/item/error_node -> 异常捕获: 无法访问的无效链接: https://api.example.com/item/error_node
[成功] https://api.example.com/item/4 -> 抓取成功 (3968 bytes)
六、并发技术选型与多线程开发核心要点总结
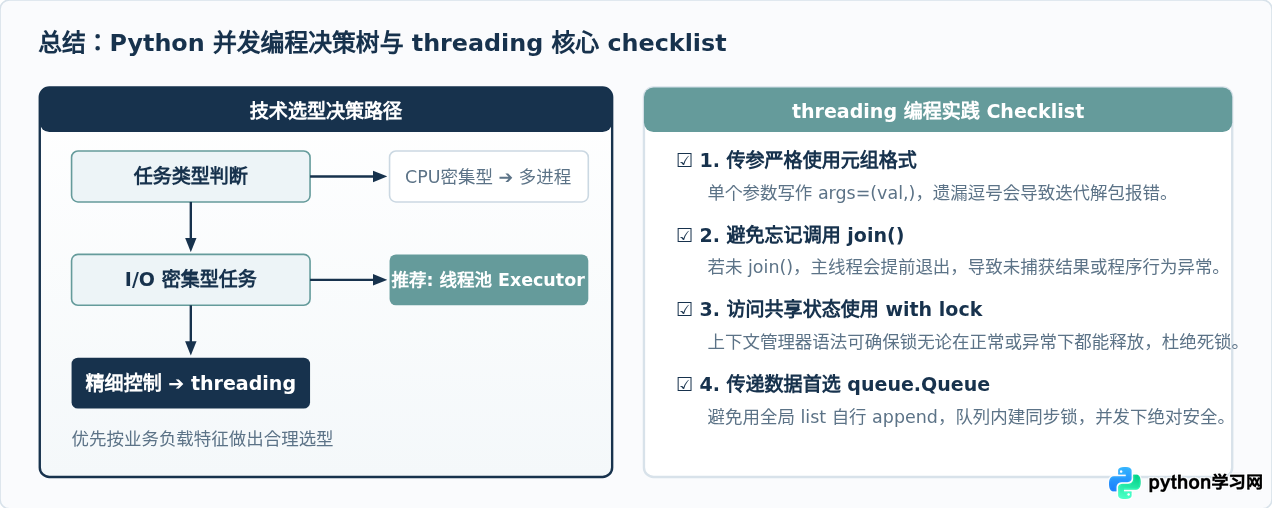
为帮助你在实际项目中准确选型并规避踩坑,下表梳理了多线程开发的关键属性对比与注意事项:
| 技术模式 | 适用场景 | CPU利用 | 数据共享方式 | 注意事项 |
|---|---|---|---|---|
| threading.Thread | 任务数量有限、需要底层精细控制生命周期的场景 | 单核 (受限于 GIL) | 共享全局内存空间 | 任务过多会导致开销暴涨,需手动使用 join 和锁 |
| ThreadPoolExecutor | 批量、动态的 I/O 任务(爬虫、批量调用第三方接口) | 单核 (受限于 GIL) | 共享全局内存空间 | 推荐用于生产环境,内置工作队列,方便获取返回值 |
| multiprocessing | CPU 密集型计算(音视频处理、图像渲染、数学运算) | 真正多核并行 | 进程隔离,需通过 IPC/管道通信 | 进程创建开销大,无法直接共享内存中的对象 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









