

为什么不建议在Python生产代码中使用中文变量名
深入解析Python 3虽然在语法层面支持Unicode标识符,但在工业级生产代码中强烈不建议使用中文变量名的核心原因,涵盖解释器机制、基础设施兼容性、排查成本与工程规范。
一、语法支持与底层原理:PEP 3131 的实际设计初衷
自 Python 3.0 起,官方引入了 PEP 3131(Supporting Non-ASCII Identifiers),允许开发者在标识符中使用 Unicode 字符。官方推行该特性的核心动机是为了便于科学计算、数学公式表达(如直接使用希腊字母 λ、θ)以及非英语国家的教学启蒙,降低初学者的理解门槛。
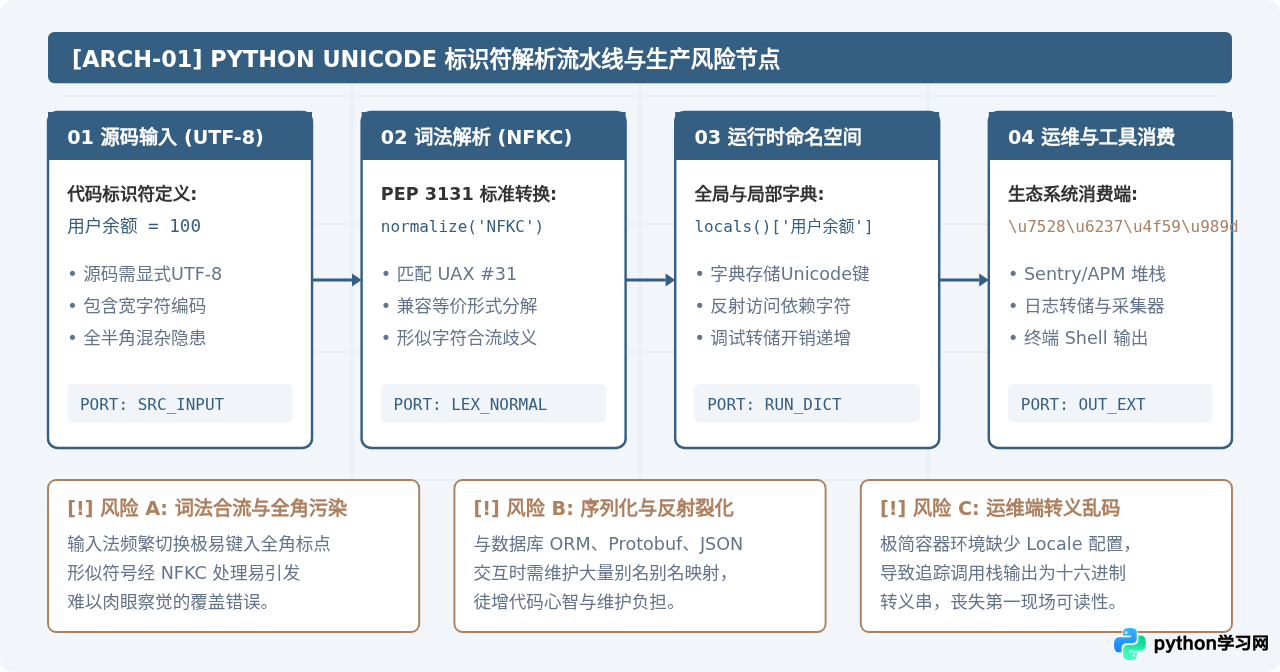
在 Python 内部,标识符的解析严格遵循 Unicode 附件标准 UAX #31。当词法分析器(Lexer)读取到中文变量时,首先会调用 NFKC(兼容等价规范化分解与合成)规则对字符进行归一化处理,然后存储于模块或类的 __dict__ 字典中。
# 语法上完全合法并能运行的 Python 3 示例
用户余额 = 1250.50
扣减金额 = 100.00
最终余额 = 用户余额 - 扣减金额

print(f"账户扣款后结余: {最终余额}")
# 输出: 账户扣款后结余: 1150.5
虽然上述代码可以正常执行,但整个 Python 生态从设计之初就是围绕 ASCII 字符体系构建的。一旦将中文变量置于复杂的端到端工业生产链路中,隐患便会迅速暴露。
二、生产基础设施与周边工具链的兼容性断层
现代软件工程绝不仅仅是“运行一段 Python 代码”,它高度依赖由 IDE、静态语法检查器、构建系统、序列化协议和代码审计工具组成的完整生态。中文标识符在这些周边生态中普遍存在支持短板。
1. 静态分析与 Linter 工具支持参差不齐
工业级开发普遍依靠 mypy、flake8、pylint 等工具进行严格的类型断言与代码规范校验。虽然近版工具逐步改善了对 Unicode 标识符的支持,但在多插件混用(如特定安全扫描插件、圈复杂度检测脚本)时,极易因正则表达式预设了 [a-zA-Z_][a-zA-Z0-9_]* 模式而报出误判或内部崩溃(Crash)。
2. 数据交换与 ORM 映射的天然隔阂
在企业级后端系统中,数据往往需要在关系型数据库(MySQL/PostgreSQL)、分布式缓存(Redis)、RPC 接口(gRPC/Protobuf)以及消息队列(Kafka)之间流转。绝大多数数据存储协议和网络交互规范强制或推荐采用 ASCII 命名的 snake_case 风格。
若在业务实体(如 Pydantic Model 或 SQLAlchemy ORM)中采用中文变量名,就必须在每一个字段上显式编写 Field(alias="user_balance") 或复杂的字段映射层,不仅导致代码臃肿,而且在多层嵌套反序列化时极易出现漏配导致的属性缺失错误。
from pydantic import BaseModel, Field

# 强行采用中文变量名导致必须编写繁琐的 Alias 映射
class 用户订单(BaseModel):
    订单标识: str = Field(alias="order_id")
    支付金额: float = Field(alias="amount")

    class Config:
        populate_by_name = True

# 数据外发时,仍需转换为标准 ASCII 键以兼容上游网关
raw_data = {"order_id": "ORD-20261029", "amount": 99.8}
order = 用户订单(**raw_data)
# 内部调试时 order.dict() 包含中文,发送给外部系统时又需额外 dict(by_alias=True)
三、故障现场与运维排障的“次生灾难”
生产环境中最宝贵的是故障发生时的响应时间(MTTR)。一旦线上出现告警,研发与 SRE 工程师必须在数分钟内精确定位根因。中文变量名在这一环节极易演变为阻碍排障的严重障碍。
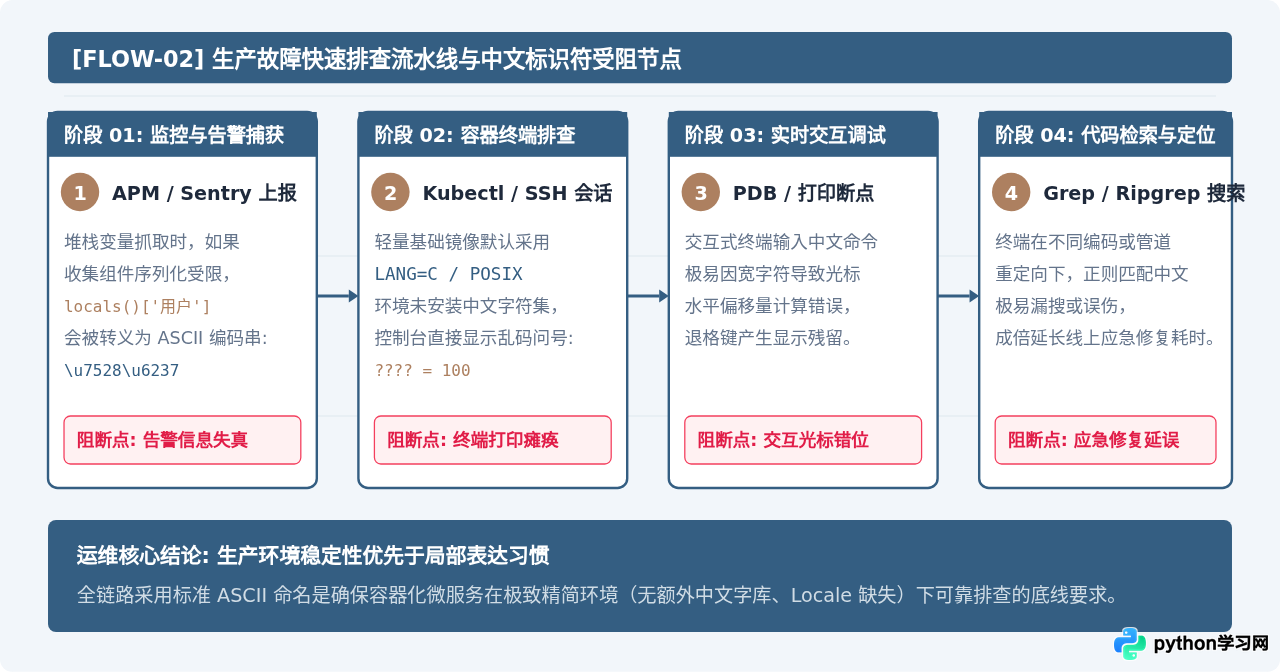
为追求极致小体积和安全防护,很多企业的生产 Docker 镜像基于 python:3.11-alpine 构建,并移除了多语言本地化包(Locale)。当未捕获异常发生时,若堆栈包含中文变量并在受限的重定向管道或早期的日志采集代理中输出,系统可能抛出难以追溯的 UnicodeEncodeError: 'ascii' codec can't encode characters in position...,直接将原本的业务异常淹没,造成“故障现场被二次破坏”。
四、输入效率、编码心流与心智负担
编写高质量代码是一个高度聚焦的思维过程。对于经常编写 Python 代码的工程师而言,使用中文变量名会带来极其显著的物理摩擦和心智消耗。
1. 输入法中英文状态的“疯狂切换”
Python 是一门强语法结构语言,所有的关键字(def、class、if、return)、操作符(=、+、-)、括号(()、[]、{})以及行尾冒号(:)和缩进,均必须使用标准 ASCII 英文输入。
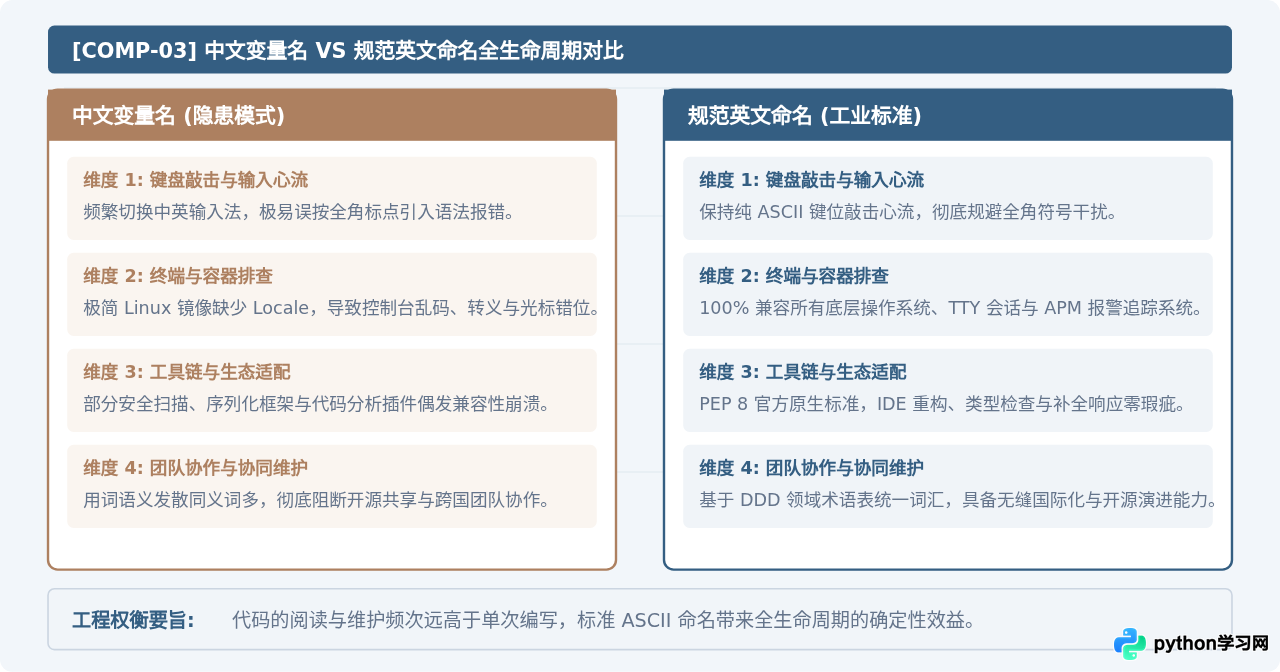
如果使用中文变量名,开发者每写一行赋值语句,就需要按下键盘上的 Shift 或 CapsLock 键多次来切换输入法。这种割裂的击键体验不仅严重打断编码心流,还会极大增加误输入全角标点(如中文全角冒号 :、中文全角括号 ())的概率,直接导致 SyntaxError: invalid character 编译错误。
2. 拼音同义词与团队语义发散
在中文语境下,同一个概念往往有多种不同的词汇表达习惯,且拼音输入容易因选词产生差异:
- 开发者 A 可能定义为
客户待付金额; - 开发者 B 在下游模块可能定义为
用户应付款项; - 开发者 C 则可能简写为
应付额。
而若遵循标准软件工程领域建模(如 DDD 统一语言),团队通常会明确约束该业务实体命名为 pending_payment_amount。英文命名不仅拼写规则明确(下划线隔开),而且具有更高的专业严肃性,能有效收敛发散的个人用词习惯。
五、生产代码命名规范的最佳实践与落地建议
明确了不建议使用中文变量名之后,团队如何在保证代码高可读性的同时,妥善处理复杂业务领域的命名难题?以下是业界通行的三项落地实践。
1. 坚守 PEP 8 命名标准
官方 PEP 8(Style Guide for Python Code) 在关于标识符字符集的部分有着明确阐述:
“All identifiers in the Python standard library MUST use ASCII-only identifiers, and should use English words wherever feasible... Global open-source projects are strongly encouraged to adopt a similar policy.”
在生产代码中,应一律遵循以下格式规范:
- 变量与函数名:全部小写字母,单词之间使用下划线分隔(如
user_account_balance)。 - 类名:大驼峰拼写法(CamelCase,如
PaymentOrderProcessor)。 - 常量名:全部大写字母,下划线分隔(如
MAX_RETRY_COUNT)。
2. 建立业务领域统一词汇表(Glossary)
很多初学者之所以倾向于写中文,是因为很多垂直业务概念(如“公摊面积”、“保理贴现”、“待分摊税费”)很难迅速找到地道对应的英文单词。对此,正确的工程做法绝非妥协写中文,而是在项目初期推行领域驱动设计(DDD)的统一语言(Ubiquitous Language):
| 业务中文概念 | 标准英文领域术语 | 代码应用示例 | 业务定义说明 |
|---|---|---|---|
| 公摊面积 | communal_area | property.communal_area |
建筑物中各产权人共同占有的公共建筑面积 |
| 待核销金额 | pending_writeoff_amount | bill.pending_writeoff_amount |
财务挂账中已收未对账结算的余额 |
| 保理贴现率 | factoring_discount_rate | contract.factoring_discount_rate |
应收账款转让时的折让资金费率比率 |
| 阶梯返佣 | tiered_rebate | policy.calc_tiered_rebate() |
根据达标销售量分阶梯结算的渠道佣金 |
3. 中文发挥价值的正确场景:Docstring 与测试用例说明
反对中文变量名,并不代表排斥在 Python 中使用中文。恰恰相反,在需要清晰表达业务意图的地方,中文是绝佳的沟通媒介——但应该放在文档注释(Docstring)、代码注释和测试用例描述中,而非用于代码语义符号:
import pytest

def calculate_tax_rebate(total_income: float, is_high_tech: bool) -> float:
    """计算企业所得税优惠返还金额。

    参数:
        total_income: 应纳税所得总额 (单位: 元)
        is_high_tech: 是否属于国家认证高新技术企业

    返回:
        float: 最终应享受的税收减免返还款项
    """
    if total_income <= 0:
        return 0.0
    rate = 0.15 if is_high_tech else 0.25
    return total_income * rate

# 在测试报告中使用清晰的中文描述,兼顾代码稳定性与报告直观性
@pytest.mark.parametrize("income, high_tech, expected", [
    (100000.0, True, 15000.0),
    (100000.0, False, 25000.0),
])
def test_calculate_tax_rebate(income, high_tech, expected):
    """验证高新技术企业与普通企业所得税优惠计算逻辑正确性"""
    assert calculate_tax_rebate(income, high_tech) == expected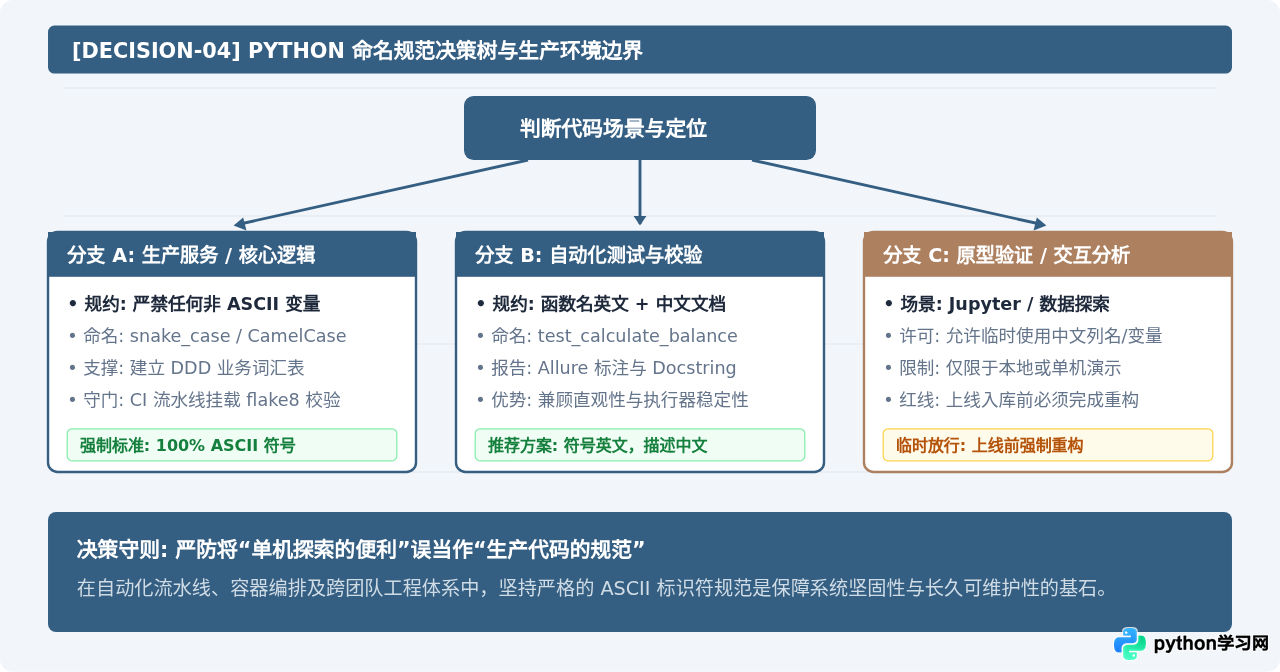
总结
编程语言的语法设计与工业软件工程的最佳实践往往追求不同的目标。Python 3 支持 Unicode 标识符,展现了语言内核对多语言文明与学术研究的包容性;但工业生产环境追求的核心指标是确定性、高吞吐、易调试与全生命周期的超低维护成本。
在生产代码中坚决使用规范的 ASCII 英文变量名,辅以精准的中文文档与注释,既是对底层基础设施健壮性的尊重,也是每一位专业工程师保障团队协作与系统平稳运行的职业素养。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









