

Python类继承的最佳实践:避免深层继承树与菱形继承陷阱
深入解析Python类继承中的深层继承树与菱形继承陷阱,详解C3 MRO算法运作原理,并提供组合模式、Mixin及Protocol的重构实战与最佳设计决策。
一、深层继承树的本质危害:脆弱基类与认知负荷
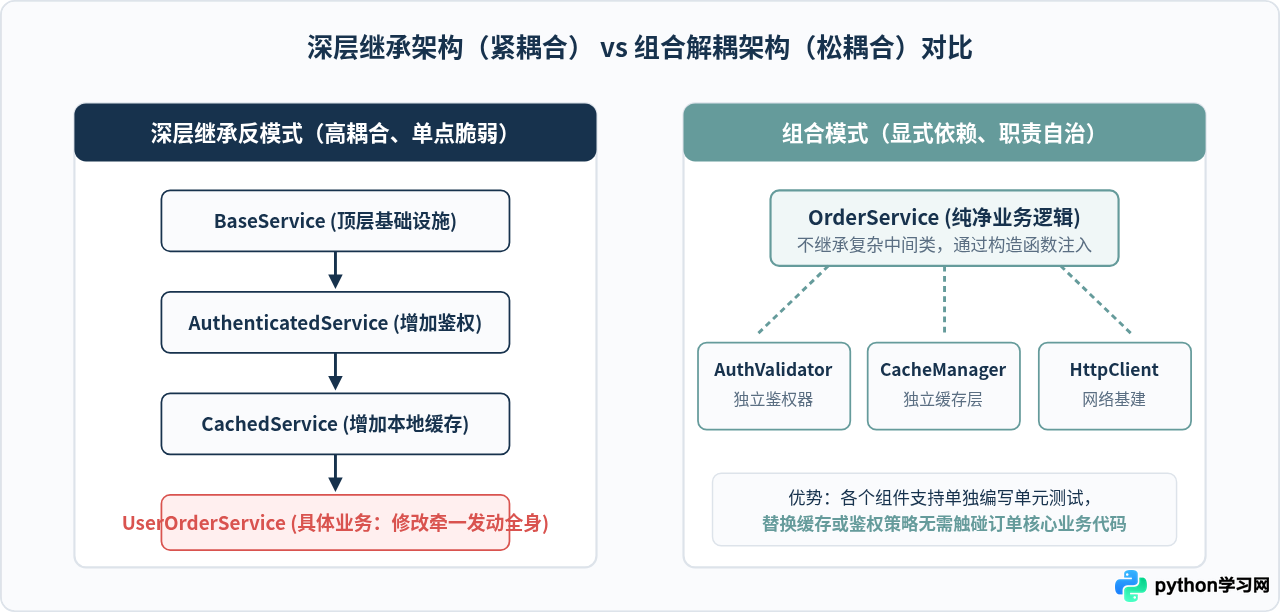
深层继承树指的是类的继承链深度超过 3 层甚至达到 5 层以上的层次结构(例如 Animal -> Mammal -> Carnivore -> Canine -> DomesticDog)。在真实的工程项目中,这种结构最常见于试图将所有业务共性逐层抽象的场景。
深层继承的核心缺陷在于它建立了一种极其脆弱的紧密耦合关系:
- 脆弱基类问题(Fragile Base Class): 底层子类的正确运行高度依赖上层所有基类的内部实现细节。一旦顶层基类为了某个子类的需要修改了某个私有属性名、方法签名或初始化顺序,整条继承链上的数十个派生类可能会毫无预警地崩溃。
- 命名空间污染与属性遮蔽: Python 拥有扁平的对象属性命名空间。当继承层级过深时,子类开发者很难清楚知道上层祖先类已经使用了哪些成员变量。偶然定义一个同名属性可能覆盖基类的关键内部状态,导致极度隐蔽的运行期缺陷。
- 心智负担剧增: 阅读深层子类的代码时,开发者必须频繁在三四个文件间反复跳转,才能弄清楚一个属性到底是在哪一层被初始化、被哪个方法所改变。
二、菱形继承陷阱与 Python MRO 的底层运作
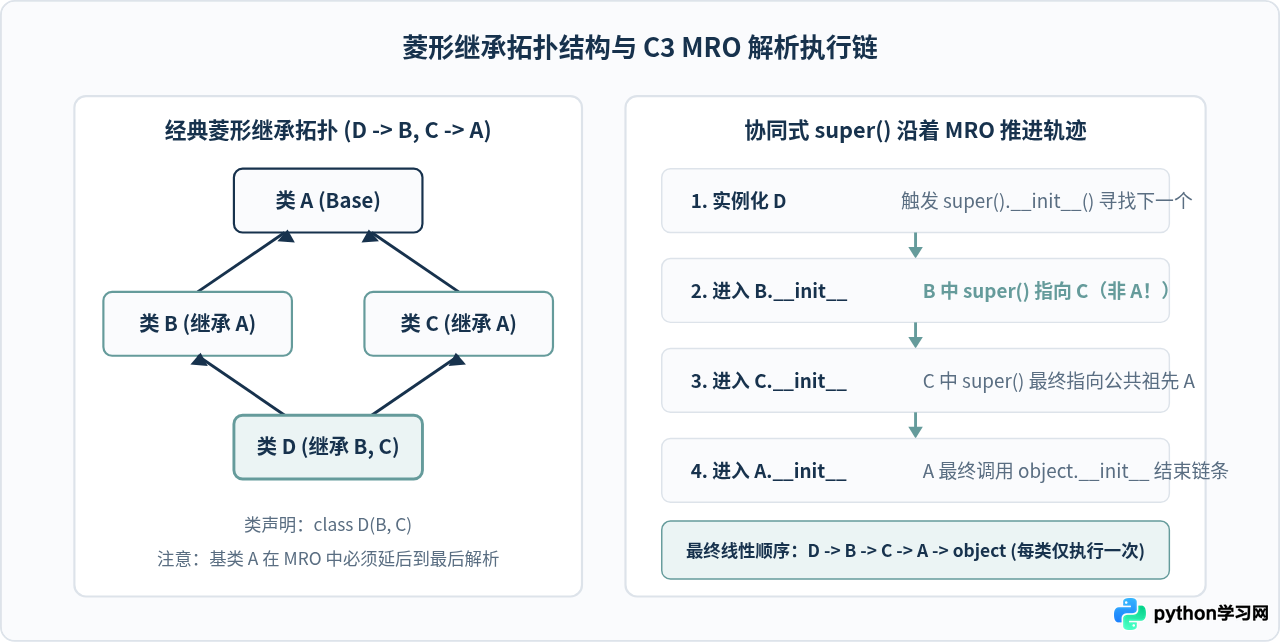
在支持多重继承的语言中,“菱形继承(Diamond Problem)”是指:类 B 和类 C 均继承自顶层基类 A,而类 D 同时继承了 B 和 C。此时如果调用某个同名方法,程序应按照何种次序执行?基类 A 的初始化逻辑是否会被执行两次?
1. 为什么传统的直觉在菱形继承中会失效?
许多刚接触多重继承的开发者误以为 super() 指的是“当前类的父类”。如果在子类中显式使用 BaseClass.__init__(self) 进行硬编码调用,极易出现基类构造函数被重复执行多次的恶性问题。
# 错误示例:硬编码父类调用导致基类重复初始化
class A:
    def __init__(self):
        print("初始化 A 资源(可能涉及昂贵的连接或计数器)")

class B(A):
    def __init__(self):
        A.__init__(self)
        print("初始化 B")

class C(A):
    def __init__(self):
        A.__init__(self)
        print("初始化 C")

class D(B, C):
    def __init__(self):
        B.__init__(self)
        C.__init__(self)
        print("初始化 D")

# 实例化 D() 的输出:
# 初始化 A 资源
# 初始化 B
# 初始化 A 资源  <-- 重复执行!可能造成资源泄露或重置已写入的状态
# 初始化 C
# 初始化 D
2. C3 线性化算法与真正的 super() 机制
Python 2.3 之后全面引入了 C3 线性化算法(C3 Linearization Algorithm),用以确定每个类的方法解析顺序(Method Resolution Order,简称 MRO)。
核心概念是:super() 调用的根本不是父类,而是当前对象在 MRO 列表中的“下一个类”!
每一个 Python 类都有一个 __mro__ 属性,展示了线性化后的搜索序列。C3 算法保证了以下三个关键性质:
- 确定性: 任何合法类的继承拓扑只有唯一的 MRO 顺序。
- 局部优先原则: 在类声明列表中靠前的父类优先于靠后的父类(例如
class D(B, C)中,B 必定排在 C 之前)。 - 单调性原则: 任何基类在子类的 MRO 中的相对前后顺序,与基类自身的 MRO 严格一致,不能反转。
3. 正确使用协同式 super() 的规则
如果必须使用菱形继承,全链路中的每个类必须严格配合,遵循协同调用的三大公约:
class A:
    def __init__(self, **kwargs):
        # 顶层必须处理并终止未知参数传递
        super().__init__()
        print("A 初始化完成")

class B(A):
    def __init__(self, **kwargs):
        super().__init__(**kwargs)  # 严格将 kwargs 透传给下一个 MRO 类
        print("B 初始化完成")

class C(A):
    def __init__(self, **kwargs):
        super().__init__(**kwargs)  # 同样透传
        print("C 初始化完成")

class D(B, C):
    def __init__(self, **kwargs):
        super().__init__(**kwargs)
        print("D 初始化完成")

# 查看当前解析顺序:
# print([cls.__name__ for cls in D.__mro__])
# 输出: ['D', 'B', 'C', 'A', 'object']super() 在运行时实际上会调用类 C,如果 B 和 C 的 __init__ 接受了不同的显式位置参数(如 B(name) 和 C(port)),协同链条就会在运行时直接抛出 TypeError: unexpected keyword argument。这是多重继承难以驾驭的关键原因。
三、方案替代一:优先使用组合(Composition over Inheritance)
面向对象领域经典的箴言是:“优先使用对象组合,而不是类继承(Favor object composition over class inheritance)”。
判断应该使用继承还是组合的标准非常直观:
- Is-A(属于关系): 类 B 真的在任何情境下都是类 A 的一种特化吗?比如苹果是水果,矩形在数学上是四边形。如果答案并不纯粹,则绝不要使用继承。
- Has-A(包含关系): 类 B 只是在运行阶段需要借助类 A 的某些能力(例如用户服务需要发邮件、需要记录日志、需要持久化数据)。这类关系必须使用组合。
代码对比:深层继承改写为组合
以下是一个在很多遗留项目中常见的深层数据处理类反模式:
# 反模式:为了复用校验与输出逻辑,滥用继承
class ValidatorBase:
    def validate(self, data):
        if not data: raise ValueError("Data is empty")

class ExporterBase(ValidatorBase):
    def export_json(self, data):
        self.validate(data)
        import json
        return json.dumps(data)

class ReportService(ExporterBase):
    def generate_report(self, raw_data):
        # 既承担报表组装,又间接背负校验和序列化
        return self.export_json(raw_data)
一旦改用组合模式,系统的职责划分瞬间变得清晰:
# 最佳实践:组合与依赖注入
class DataValidator:
    """单一职责:专门负责数据合法性校验"""
    def validate(self, data: dict) -> None:
        if not data:
            raise ValueError("Data cannot be empty")

class JsonExporter:
    """单一职责:专门负责将字典导出为 JSON 字符串"""
    def export(self, data: dict) -> str:
        import json
        return json.dumps(data)

class ReportService:
    """业务编排者:显式声明所需要的外部工具"""
    def __init__(self, validator: DataValidator, exporter: JsonExporter):
        self._validator = validator
        self._exporter = exporter

    def generate_report(self, raw_data: dict) -> str:
        self._validator.validate(raw_data)
        # 执行自身的核心业务逻辑处理...
        processed = {k: str(v).upper() for k, v in raw_data.items()}
        return self._exporter.export(processed)
此时,如果未来需要将 JSON 导出切换为 XML 或 CSV 导出,我们只需要传入一个实现了相同接口的 CsvExporter,而完全不需要动 ReportService 的任何代码,更不会波及校验逻辑。
四、方案替代二:轻量协议与严格受限的 Mixin 模式
在很多场景下,开发者之所以诉诸深层继承或多继承,是为了给不同的类“打上某种辅助功能”。在 Python 中,如果确实需要通过类层次复用逻辑,应当遵循严格受限的 Mixin(混入类) 规范,或借助现代 Python 提供的 typing.Protocol。
1. Mixin 的四项黄金守则
- 无独立实例状态: Mixin 类绝对不能定义带有独立实例变量的
__init__函数,它只提供通用方法,不维护状态。 - 单一职责与小粒度: 一个 Mixin 仅提供一个独立功能(如
JSONSerializableMixin、TimestampTrackingMixin)。 - 明确的命名约定: 类名必须以
Mixin结尾,提醒后续阅读代码的人这是一个横切功能组件,不能被直接单独实例化。 - 避免父类依赖假设: Mixin 内部尽量不假设被混入宿主类的具体属性名,若依赖特定方法,应通过抽象方法明确约束。
import json
from abc import ABC, abstractmethod

class SerializableMixin:
    """标准的单功能无状态 Mixin"""
    def to_json(self) -> str:
        # 借助宿主对象的 __dict__ 或约定属性
        if hasattr(self, "__dict__"):
            return json.dumps(self.__dict__, ensure_ascii=False)
        raise NotImplementedError("宿主类未提供可序列化字典属性")

class User(SerializableMixin):
    def __init__(self, name: str, age: int):
        self.name = name
        self.age = age

# 使用:User 获得了 to_json 能力,但并未建立复杂的上下级耦合
u = User("Alice", 28)
print(u.to_json())  # 输出: {"name": "Alice", "age": 28}
2. 现代 Python 利器:基于 typing.Protocol 的结构化子类型
在 Python 3.8+ 中,使用 typing.Protocol 可以实现静态类型系统下的“鸭子类型”。类不需要显式继承任何接口基类,只要具备对应的方法签名,就能被类型检查器与业务代码安全消费。
from typing import Protocol

class Renderable(Protocol):
    def render(self) -> str:
        ...

class MarkdownDocument:
    # 完全不需要继承 Renderable
    def render(self) -> str:
        return "# Markdown Content"

class HtmlWidget:
    # 同样完全解耦
    def render(self) -> str:
        return "<div>Widget</div>"

def publish_content(item: Renderable) -> None:
    # 任何具备 render 方法的对象均可传入,彻底告别类继承树
    print("Publishing:", item.render())
五、实战重构:消除深层继承树的四个步骤
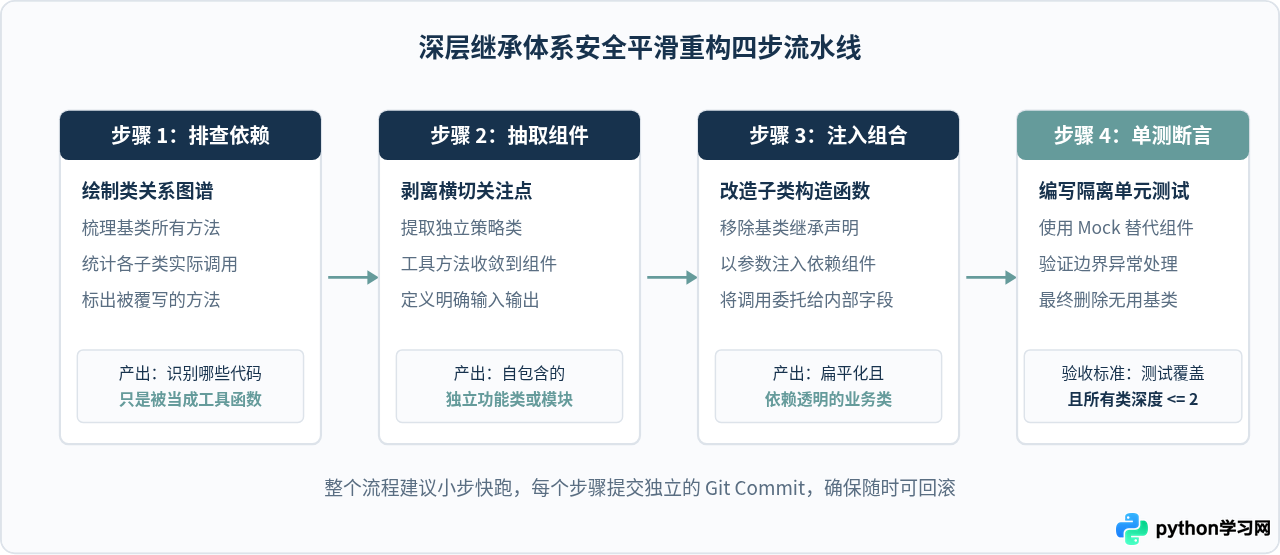
当面对项目中现存的 4 层或 5 层复杂继承类时,切忌盲目一次性推倒重来。应该遵循如下标准重构流程:
六、面向对象技术选型决策与自检清单
在进行 Python 架构设计时,究竟何时允许使用继承,何时必须使用组合?下面的决策矩阵可以作为技术选型时的直接参考:
| 设计模式 / 技术 | 核心适用场景 | 状态耦合程度 | 推荐指数与注意事项 |
|---|---|---|---|
| 类继承(单继承) | 明确的 Is-A 概念特化、扩展成熟框架约定的钩子(如 Django CBV、unittest.TestCase) |
强耦合(完全继承基类全部命名空间) | 谨慎使用: 继承链严禁超过 2 层,严禁仅为了复用 1~2 个辅助函数而建立父子关系。 |
| 对象组合(Composition) | 绝大多数业务逻辑拼装、运行时策略切换、外部组件集成(数据库、缓存、消息队列) | 极松散(仅通过公共方法契约进行交互) | 最高优先级推荐: 具备极高的可维护性与测试便利性,构造参数显式传参。 |
| Mixin 混入模式 | 为多个不相关的类批量赋予某种正交的辅助能力(如序列化、审计打标、权限校验) | 无状态(不设实例变量,仅提供纯逻辑方法) | 受限推荐: 必须以 Mixin 为后缀,禁止定义 __init__。 |
| 协议(typing.Protocol) | 定义系统内部的抽象接口契约,需要严格的 IDE 自动补全和 mypy 静态类型检查 |
零运行时开销(完全基于结构化鸭子类型) | 现代 Python 强烈推荐: 替代传统侵入式的 Abstract Base Class。 |
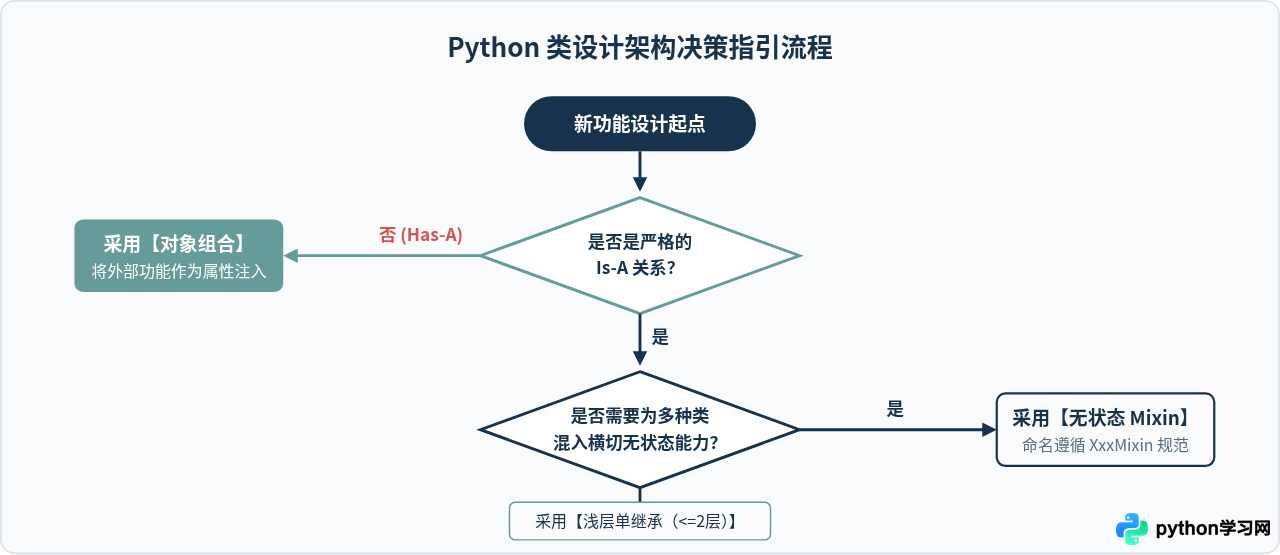
日常编码自检清单(Checklist)
- [ ] 类继承层级核验: 在当前新建类的祖先链中,层数是否在 2 层以内?若达到或超过 3 层,是否能拆解为组合模式?
- [ ] 父类成员认知: 你是否能在不查阅文档的情况下,清晰说出当前类所直接调用的父类属性是哪个?是否存在意外重名覆盖私有成员的风险?
- [ ] 多重继承安全性: 如果使用了多继承,每个父类是否都协同调用了
super().__init__(**kwargs)?有没有硬编码直接调用ParentClass.__init__(self)? - [ ] 单测可测性: 实例化该类进行单元测试时,是否需要 Mock 上层 3 个以上基类的外部环境(例如网络、数据库、环境变量)?如果是,说明该类已经被深度耦合绑架,必须立刻重构。
总结而言,Python 灵活的动态特性赋予了开发者极高的自由度,但也因此更需要架构自律。告别深层继承树与复杂的菱形继承,拥抱小巧、独立、可测试的组合对象与轻量 Mixin,才能让系统在长期的业务迭代中保持敏捷与健壮。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









