

Google Colab与Replit对比:哪个更适合在线运行Python代码?
深入对比Google Colab与Replit在在线运行Python代码时的核心差异。从架构设计、算力配置、会话生命周期、开发工作流到多文件工程支持,帮助你根据实际业务需求精准选择最适合的云端Python开发环境。
核心结论:如果你需要进行数据清洗、机器学习实验、算法推导或使用免费 GPU 加速计算,请选择 Google Colab;如果你需要构建多文件工程、编写 Web API 接口、开发自动化 Bot 或需要让代码长期持续在线运行,请选择 Replit。
很多开发者在选择云端 Python 运行平台时,常把 Google Colab 与 Replit 视作同台竞争的替代品。但在实际使用中,两者的底层架构与设计目标有着根本分歧。Google Colab 本质是托管在 Google Cloud 上的交互式 Jupyter Notebook,面向的是数据科学家、算法研究者与学生群体;而 Replit 本质是一个基于 Linux 容器的全功能云端集成开发环境(Cloud IDE),面向的是现代通用软件工程、全栈应用搭建与快速原型部署。
一、架构模式差异:交互式 Notebook 对比全栈 IDE
要理解哪个工具更适合你的场景,首先需要剖析它们是如何组织与运行 Python 代码的。
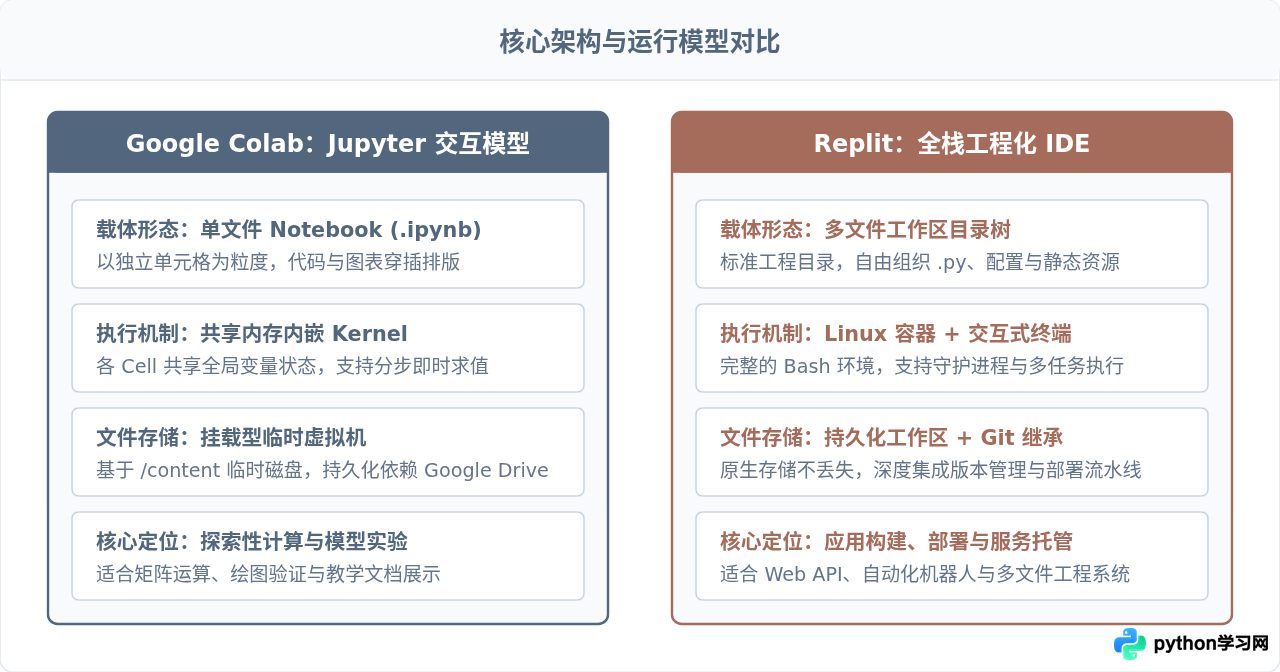
Google Colab 采用经典的单文件 .ipynb 结构。代码被切分成一个个独立的单元格(Cell),每个单元格可以单独执行,执行结果与图表会直接内嵌保存在文档中。底层的 Python 内核(Kernel)在内存中维护着全局状态,上一个单元格声明的变量或导入的包可以直接供下一个单元格调用。这种架构非常利于数据探索,但缺点也显而易见:代码执行顺序取决于人工点击次序,缺乏对多文件模块化拆分、包管理文件依赖(如 pyproject.toml)的原生工程化组织能力。
Replit 则完全遵循现代软件工程标准。新建一个 Python Repl 会直接为你提供一个标准的项目工作目录树(Workspace),你可以在其中任意创建子文件夹、拆分 main.py 与辅助模块、维护静态资源,甚至通过内置的 Linux 终端执行 Shell 命令。Replit 基于 Nix 虚拟环境管理依赖,不仅支持单个脚本,更能轻松处理多模块协同的大型代码库。
二、算力规格与生命周期:硬件加速 vs 持续服务
运行 Python 代码不仅需要考虑编写体验,更依赖底层的计算硬件与网络环境。这一维度的差异直接划定了两者的能力边界。
1. 硬件加速与算力倾斜
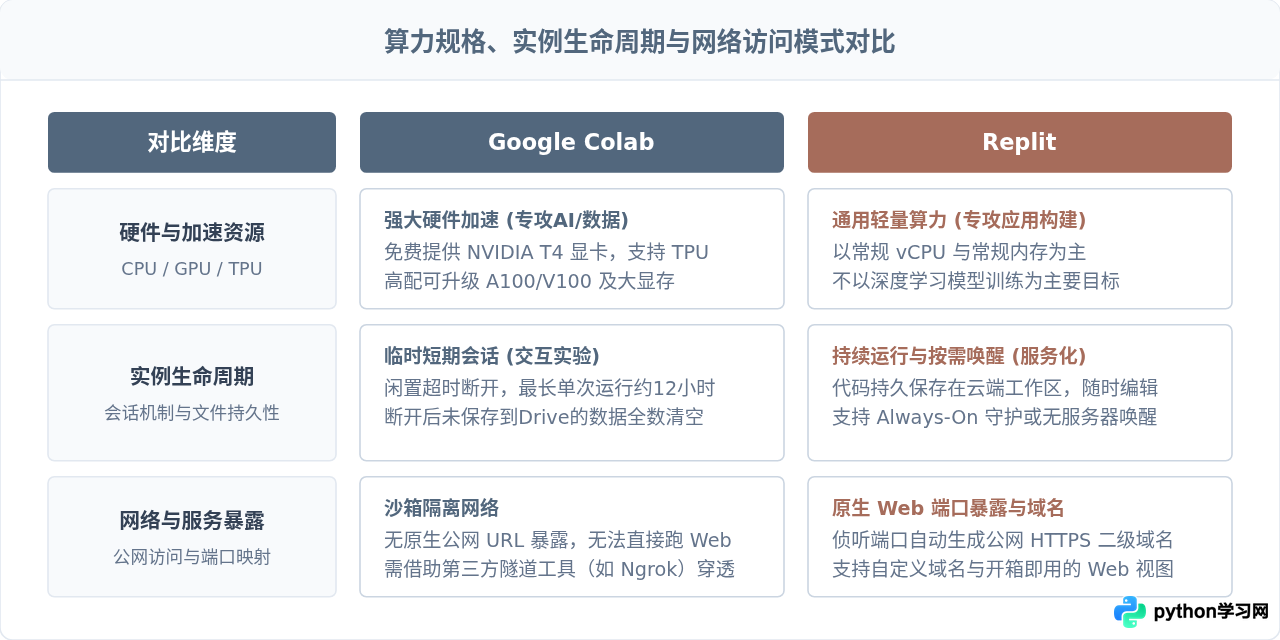
Google Colab 最具吸引力的特性在于算力支持。即使是免费版账户,Colab 也会动态分配 NVIDIA T4 独立显卡甚至 TPU 资源,付费版(Colab Pro / Pro+)更支持挂载 A100 或 V100 GPU。对于 PyTorch、TensorFlow、Scikit-learn 等库,Colab 出厂即预置完毕,用户进入环境后可以直接启动张量运算与神经网络训练。
Replit 的定位则不是重型算力平台。其免费或入门套餐主要分配 0.5 到 2 个共享 vCPU 以及 512MB 至 2GB 内存。这种配置足以支撑常规的自动化爬虫、数据整理、Telegram Bot 或 Web API 运行,但在处理大规模矩阵乘法或运行百兆以上的深度学习模型时,极容易因触发内存上限(OOM)而崩溃。
2. 会话生命周期与网络拓扑
Colab 的虚拟机具有强烈的“临时性”特征。只要页面闲置超过一定时间(通常在几十分钟内),或者单次运行时长达到上限(免费版约 12 小时),当前容器就会被强制回收重置,存放在虚拟机本地磁盘(/content)中的未保存数据将全部清除。此外,Colab 没有开放直接的外部公网 IP 或长期稳定的 HTTP 端口,外界无法直接向 Colab 内部的进程发起 HTTP 请求。
Replit 专为服务在线化打造。在 Replit 中编写并启动 Web 服务(如 FastAPI 或 Flask),平台会自动识别服务侦听的端口,并在右侧开箱提供内嵌的 Webview 预览,同时生成一个专属的公网二级域名(如 https://project-name.username.repl.co)。通过其提供的 Always-On(常驻)或 Deployments 功能,你的 Python 服务可以 7x24 小时在线对外响应请求,不需要用户常开浏览器标签页。
三、实操工作流对比:数据分析实验 vs Web 工程构建
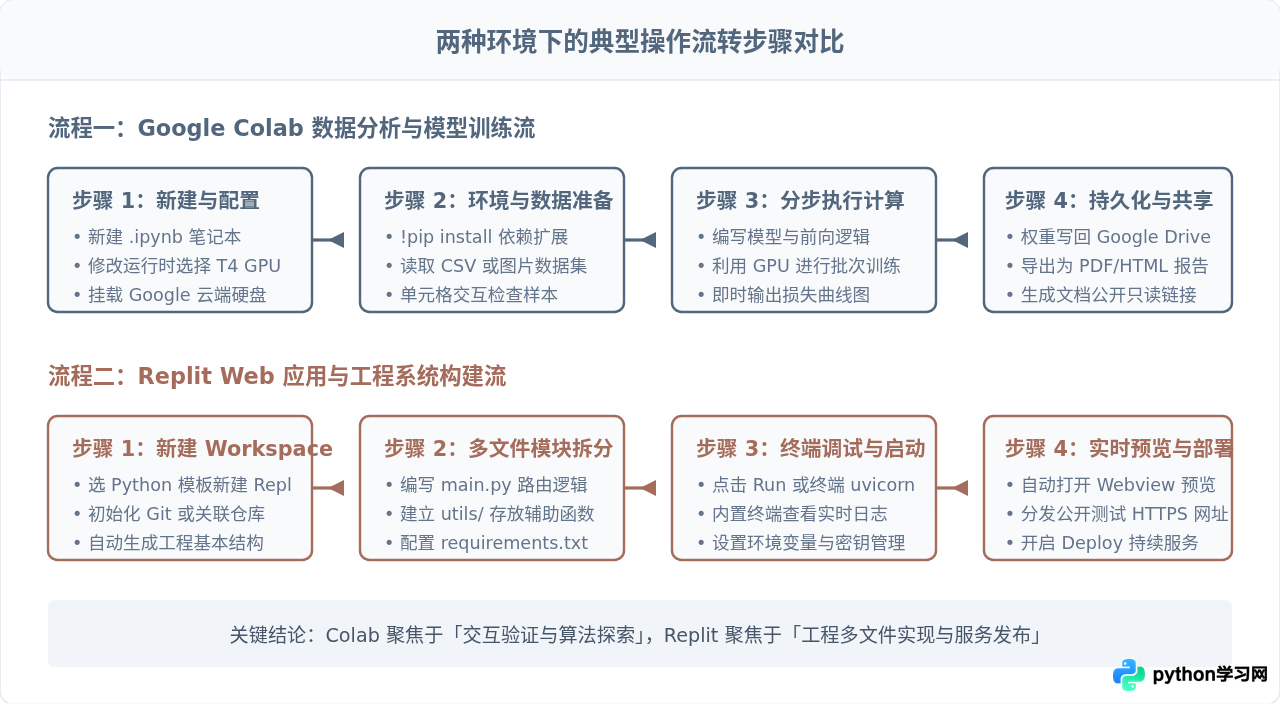
为了直观感受两个环境在具体操作上的差异,我们可以分别在 Colab 和 Replit 中执行两组典型任务。
场景 1:在 Google Colab 中加载数据并计算统计分布
在 Colab 中操作时,我们通常在头部单元格配置依赖与挂载驱动器,随后在一个或多个单元格中编写数据处理逻辑。以下代码展示了在单单元格中生成模拟传感器数据并计算分组统计量的标准做法:
Colab Code Cellimport numpy as np
import pandas as pd
# 模拟生成 1000 组时序传感器监控数据
np.random.seed(42)
records = 1000
data = {
"sensor_id": np.random.choice(["Node-A", "Node-B", "Node-C"], size=records),
"temperature": np.random.normal(loc=24.5, scale=3.2, size=records),
"pressure": np.random.normal(loc=101.3, scale=1.5, size=records)
}
df = pd.DataFrame(data)
# 按传感器节点汇总核心统计指标
summary = df.groupby("sensor_id").agg(
avg_temp=("temperature", "mean"),
max_temp=("temperature", "max"),
avg_pressure=("pressure", "mean")
).reset_index()
# 在 Notebook 中直接求值输出
summary执行完成后,数据帧以整齐的表格形式内嵌在文档下方。你可以接着在下一个单元格敲入 df['temperature'].plot(kind='hist') 立即生成直方图。这种所见即所得、变量状态即时保留的反馈回路,是 Notebook 体验的精髓所在。
场景 2:在 Replit 中构建轻量 Web API 服务
若在 Replit 中开发,我们会组织规范的项目结构。例如创建 main.py 文件编写接口,将业务逻辑抽离至模块,并通过 requirements.txt 声明依赖:
from fastapi import FastAPI
import uvicorn
from datetime import datetime

app = FastAPI(title="Sensor Monitor API")

@app.get("/")
def read_root():
    return {
        "status": "online",
        "service": "Replit Cloud Service",
        "timestamp": datetime.utcnow().isoformat()
    }

@app.get("/api/health")
def health_check():
    return {"healthy": True, "uptime_mode": "cloud-always-on"}

if __name__ == "__main__":
    # Replit 会自动识别 8080 端口并唤起 Webview
uvicorn.run(app, host="0.0.0.0", port=8080)在 Replit 中点击顶部的绿色「Run」按钮,平台会自动读取 .replit 配置文件,通过终端启动服务,并直接在右侧窗口渲染 API 页面。外部用户只需访问生成的 URL,即可调用你的接口。
四、协作方式与成本配额边界
除了功能和硬件指标,日常使用的协作模式与付费规则也是选型的重要依据:
- 协同模式:Colab 基于 Google 云端硬盘权限体系,分享链接类似于 Google Docs,对方可以留下行内批注、建议或复制副本,但无法像结对编程那样实时查看多方输入光标;Replit 提供真正的 Multiplayer 协同编辑模式,多名开发者可在同一屏幕下实时编写代码、共享终端输入并在同一个控制台中排查报错。
- 代码公开性:Colab 脚本默认保存在个人 Google Drive 中,无论免费还是付费,代码都是私密的;Replit 免费层级创建的 Repl 默认公开在社区中,任何访问者均可查看源码,如果涉及敏感项目或私有业务,必须开通 Core 套餐方可创建私有仓库。
- 资源断供机制:Colab 的免费算力采用浮动配额制(Dynamic Resource Allocation)。如果系统判定近期 GPU 使用量过大,可能会在数小时内限制获取 GPU 实例;Replit 则对免费容器的月度运行配额与带宽设有明确上限,超过后需要充值计算额度。
1. 切勿把 Colab 当做后端生产服务器:有人试图使用隧道穿透工具(如 Ngrok / Cloudflare Tunnel)将 Colab 的临时端口暴露给外界做 API 接口。由于 Colab 的闲置超时和强制断开机制不可避免,这种方式必然导致接口频繁中断丢失,切勿在正式项目中采用。
2. 切勿在 Replit 免费版中强行加载大模型:在仅有 1GB 内存的普通容器中运行 import torch 并下载几百兆的权重文件,会直接触发系统的 OOM 杀进程信号(SIGKILL),代码甚至无法进入执行循环。
五、选型决策指南:如何做出最终选择?
综合以上分析,我们可以把选型决策归纳为一条清晰的判断链路:
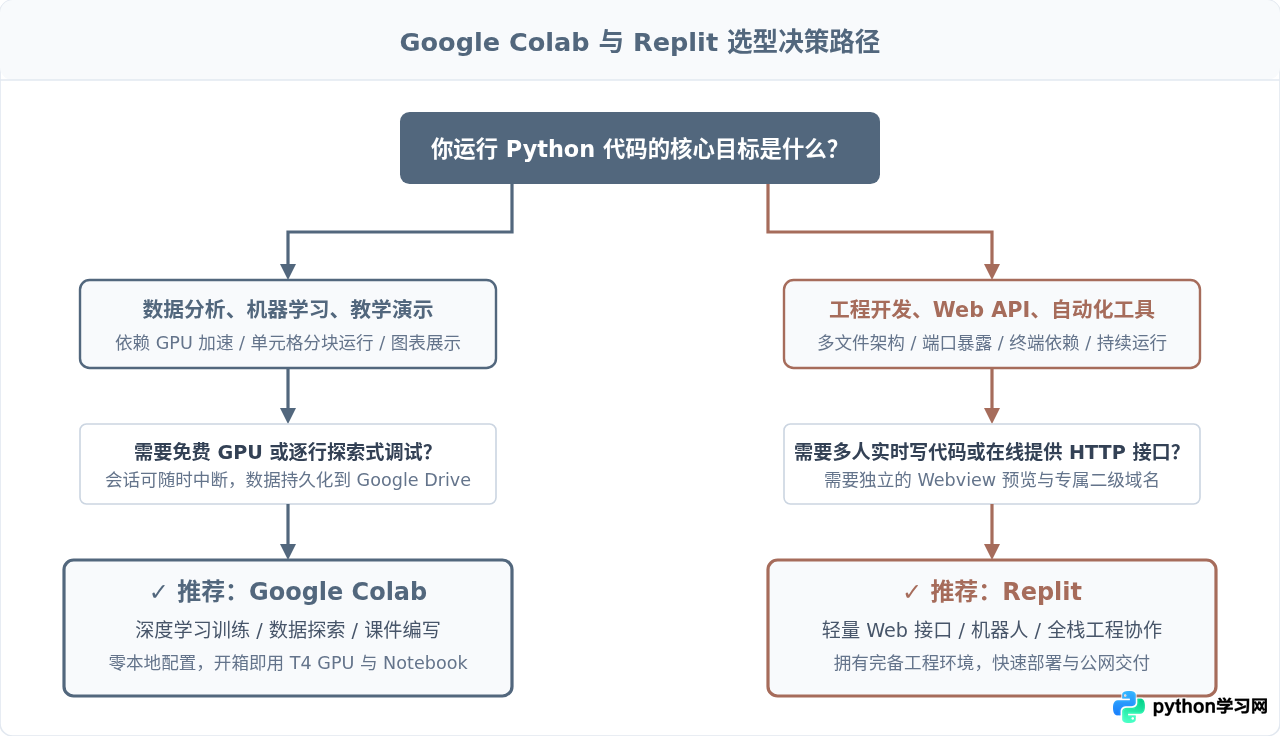
最终判定非常直接:凡是围绕「探索、验证、重型算力、图表展示」展开的任务,毫不犹豫选择 Google Colab;凡是围绕「服务、工程、终端操作、多人写代码」展开的项目,果断选择 Replit。准确对齐两者的设计初衷,才能最大程度释放云端开发环境的效率优势。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









