

Python源文件头部为什么要写# -*- coding:utf-8 -*-
深入解析在Python源文件头部声明编码的作用、PEP 263规范解析机制、Python 2与Python 3的编码差异以及现代开发中的最佳实践。
# -*- coding: utf-8 -*-,核心目的是显式告知 Python 解释器使用 UTF-8 字符集来解码和读取该脚本文件的字节流。在 Python 2 时代,解释器默认仅以 ASCII 编码解析源码,只要代码中出现中文字符串或中文注释,就会因无法解码而抛出致命的 SyntaxError 语法错误。虽然 Python 3 已经将源码默认编码升级为 UTF-8,但在保持跨版本兼容、统一团队规范以及规避跨平台环境歧义时,这一声明依然扮演着重要角色。
一、底层原理:Python 解释器如何读取并解析源码
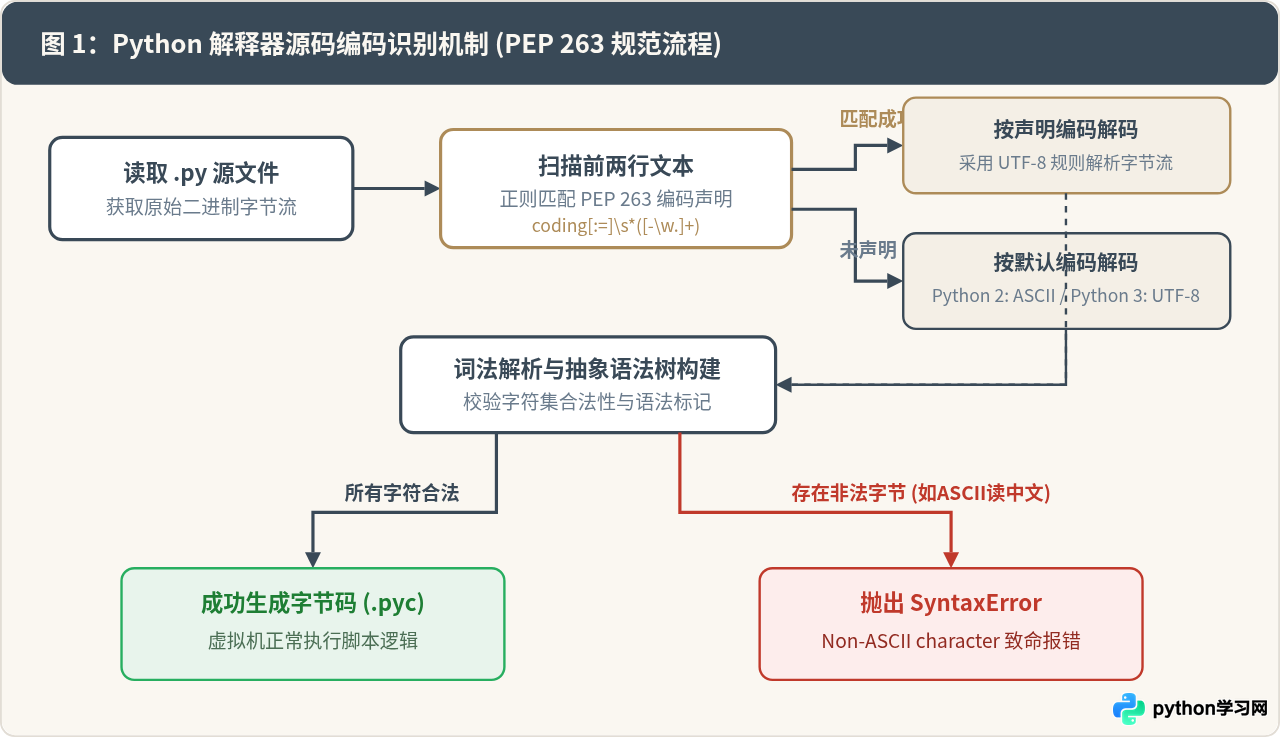
计算机磁盘上的所有文件本质上都是按特定编码格式保存的二进制字节序列。当我们在终端执行 python script.py 时,Python 解释器并不是直接“理解”汉字或英文单词,而是必须先将磁盘上的原始字节序列解码为内存中的文本字符,进而构建词法单元与抽象语法树(AST)。
为了让解释器在读取代码的第一步就知道使用何种规则进行解码,Python 官方在 PEP 263(Defining Python Source Code Encodings)中制定了明确的编码探测机制:解释器在打开文件时,会首先检查文件最开头的字节标识(如 UTF-8 BOM),若未发现 BOM,则按字节读取第一行或第二行,使用正则表达式寻找编码魔术注释。如果找到了有效的编码声明,就会使用该编码来解析整个文件的后续内容;如果未找到,则退回使用解释器版本的内置默认编码。
二、历史根源:为什么 Python 2 必须写这行声明?
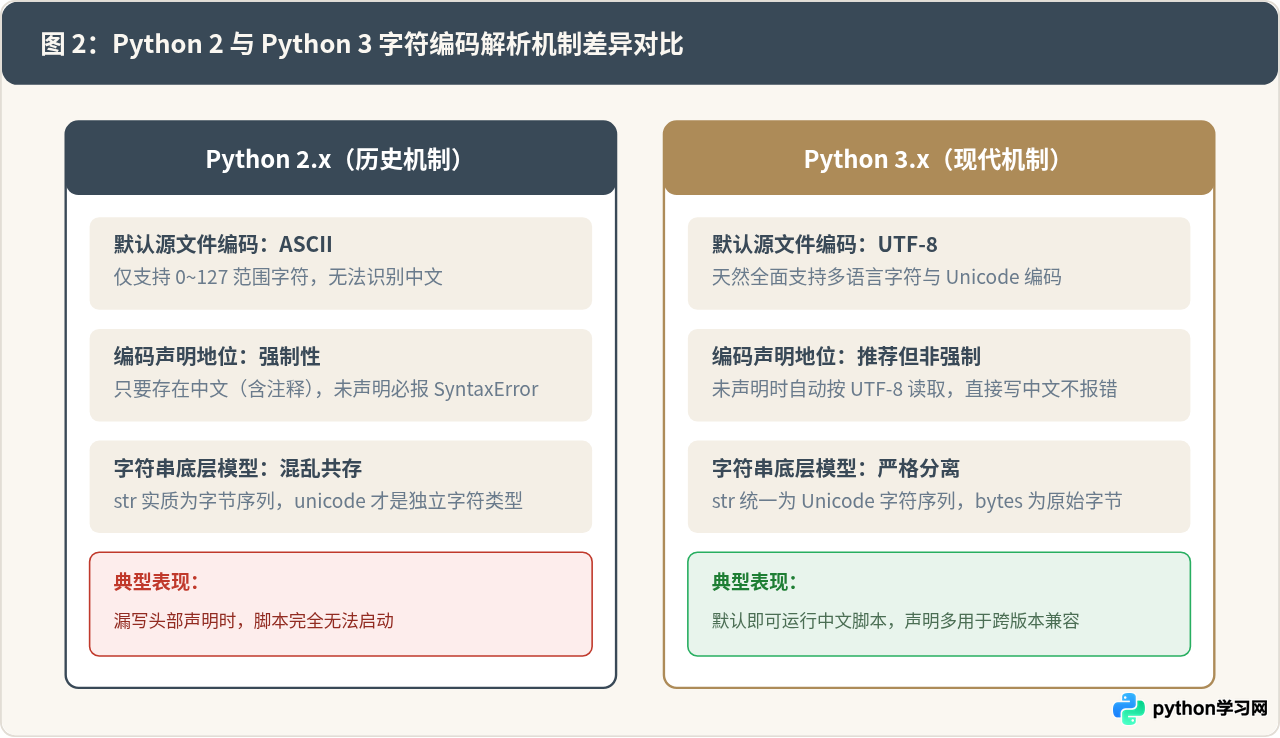
理解这行代码的关键在于回溯 Python 2 的默认行为。在早期的 Python 2 中,由于历史设计,解释器默认假定所有源代码都遵循 7 位的 ASCII 编码。ASCII 字符集的有效编码范围仅为 0 到 127,仅能表示基础英文字母、数字和常见控制字符。
当开发者在脚本中写下哪怕是一行简单的中文注释或中文字符串时,这些文字在保存为 UTF-8 编码时会生成值大于 127 的字节(例如常见汉字的 UTF-8 编码由三个字节组成,高位均为 1)。Python 2 解释器在按照 ASCII 规则逐字节读取时,一旦遇到这些高位字节,就会判定输入非法,立即中断并报错:
# 示例:一段在 Python 2 下未声明编码的脚本
print "Hello World"
# 这是中文注释,未声明编码

# 执行时抛出的典型错误:
# SyntaxError: Non-ASCII character '\xe8' in file test.py on line 2,
# but no encoding declared; see http://python.org/dev/peps/pep-0263/ for details
这个报错非常明确地指出了问题本质:文件中出现了非 ASCII 字符,但由于头部缺少编码声明,解释器拒绝猜测文件编码,从而强制报错退出。因此,在 Python 2 时代,编写 # -*- coding: utf-8 -*- 是任何包含中文字符的源文件能够正常运行的刚性前提。
三、语法规则:这行声明具体怎么写?
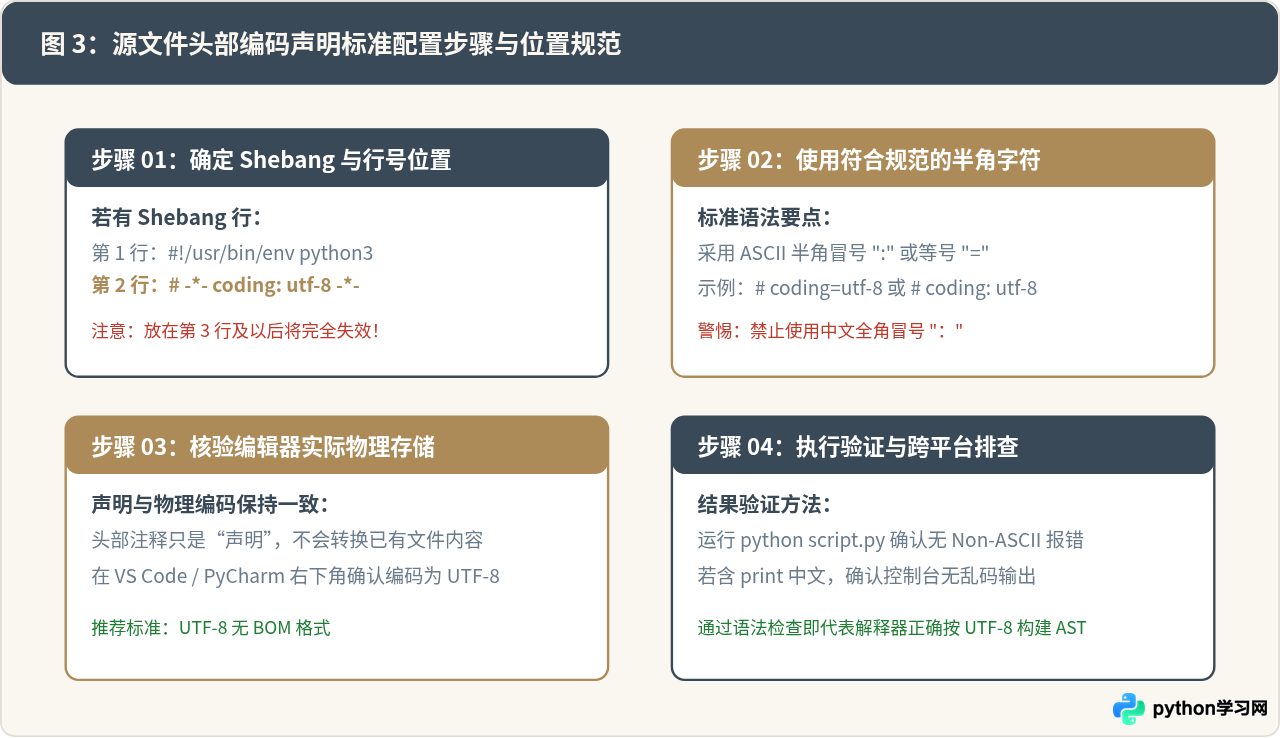
根据 PEP 263 规范,编码声明并不只有一种固定形式。解释器在扫描前两行时,使用的核心匹配规则是寻找包含 coding 关键字的注释行:
- 经典 Emacs 风格:
# -*- coding: utf-8 -*-。这是最广为人知的写法,中间的-*-是 GNU Emacs 编辑器识别文件模式的标记,Python 解释器在设计时兼容了这一传统。 - 极简写法:
# coding=utf-8或# coding: utf-8。这种写法去除了修饰字符,同样完全符合 PEP 263 正则匹配规则。 - Vim 风格:
# vim: set fileencoding=utf-8 :。这种写法也能被解释器识别。
声明的摆放位置顺序
PEP 263 对声明所在的行号有着极其严格的限制:必须放在第 1 行或第 2 行。解释器读取超过第二行后就会停止检测并直接采用默认设置:
- 如果脚本不需要 Shebang(解释器路径说明):直接放在第 1 行。
- 如果脚本需要 Shebang(如在 Linux/macOS 下直接通过
./script.py执行):第 1 行必须留给 Shebang,编码声明必须紧跟放在第 2 行。
四、现代 Python 3 还需要写吗?决策与建议
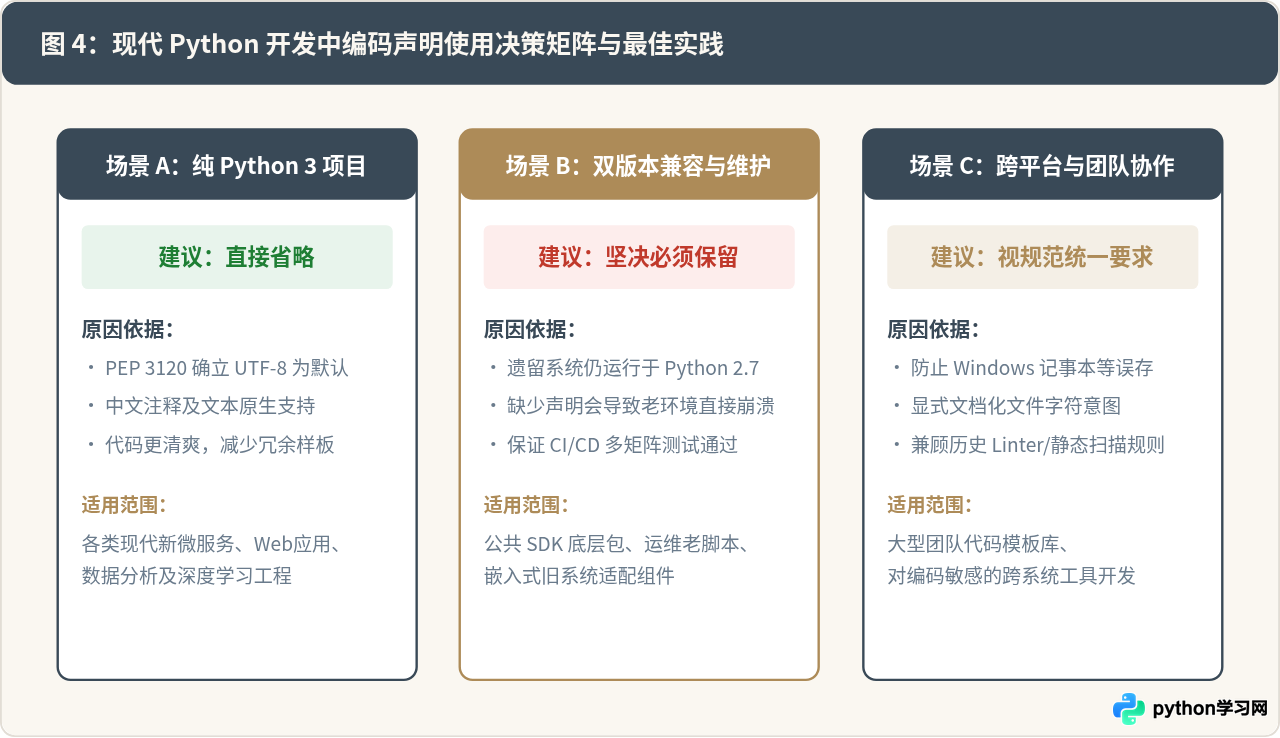
在 Python 3 成为绝对主流的今天,关于是否保留该声明,可以根据具体工程环境做出清晰选择:
对于纯 Python 3 的现代项目,PEP 3120 已经将默认源文件编码定为 UTF-8,因此完全可以省略该声明,省去多余的代码样板。但在跨版本兼容库、大型开源项目或特定企业团队规范中,保留该声明仍是提高代码自解释性与鲁棒性的稳妥做法。
五、常见误区与避坑指南
-
误区一:以为写了声明,文件就会自动变成 UTF-8。
头部声明仅是告知解释器“请按此编码读取”,它不会、也不能改变磁盘上已存在的物理二进制数据。如果文件实际上是用 GBK 保存的,头部却声明为 UTF-8,解释器在读取包含中文的字节时仍会引发解码冲突。必须确保编辑器底部的物理编码保存格式与头部声明完全一致。 -
误区二:输入法打出中文全角冒号。
在题目中出现的# -*- coding:utf-8 -*-中,冒号是中文全角符:(Unicode\uff1a)。根据 PEP 263 正则coding[:=]\s*([-\w.]+),仅匹配 ASCII 半角冒号:或等号=。一旦打错成中文全角冒号,解释器将无法匹配成功,声明失效。 -
误区三:放在了第 3 行及以后。
若在文件开头写了多行版权信息、版本说明或空行,将编码声明挤到了第 3 行之后,解释器将直接忽略该行,按默认编码处理。
总结
# -*- coding: utf-8 -*- 见证了 Python 从早期单一 ASCII 环境走向全面 Unicode 化的演变历程。虽然在现代 Python 3 项目中它已经不再是强求的必选项,但理解其背后的字符解码原理、PEP 263 规范以及版本差异,对于编写健壮、跨平台兼容的专业 Python 代码依然是一项不可或缺的基础功底。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









