

解决Python导入自定义model.py模块时的ModuleNotFoundError与循环依赖
针对Python项目中导入自定义model.py时常见的ModuleNotFoundError与循环依赖问题,深入分析sys.path检索机制与模块初始化过程,并提供规范目录结构、模块化执行、公共层下沉及延迟导入等完整解决方案。
model.py 时遇到的报错通常源于两类不同机制:一是由于执行脚本所在路径与工程根目录不一致,导致模块检索范围未覆盖目标文件而触发的 ModuleNotFoundError;二是多个模块之间存在直接或间接的双向顶层引用,导致模块在未完成属性初始化时被提前调用而触发的 ImportError: cannot import name ... from partially initialized module(即循环依赖)。解决前者的核心是规范工程目录结构并统一通过模块模式(python -m)运行;解决后者的关键在于理清依赖层级,采用基础模型下沉、局部延迟导入或类型守卫(TYPE_CHECKING)彻底打断引用闭环。
一、定位路径盲区:ModuleNotFoundError 的成因与判定
许多开发者在编写数据模型时,习惯将文件命名为 model.py 或放置在 models/ 目录下。当在其他业务脚本中书写 import model 或 from app.models import model 时,Python却抛出 ModuleNotFoundError: No module named '...'。这类报错常常让初学者感到困惑,因为在文件树中目标文件确实客观存在。
要排查该问题,必须理解Python解释器寻找模块的基准列表 sys.path。当通过命令行执行一个Python文件时(例如 python app/services/runner.py),Python解释器会自动将该脚本所在的文件目录(即 app/services/)作为检索列表的首项 sys.path[0],而并不是将终端当前所在的工作目录作为首项。如果脚本尝试以 from app.models import model 这种以工程根目录为顶点的绝对路径进行导入,解释器仅在 app/services/ 及其子目录、标准库与第三方库虚拟环境中搜索,自然无法找到顶层的 app 包。
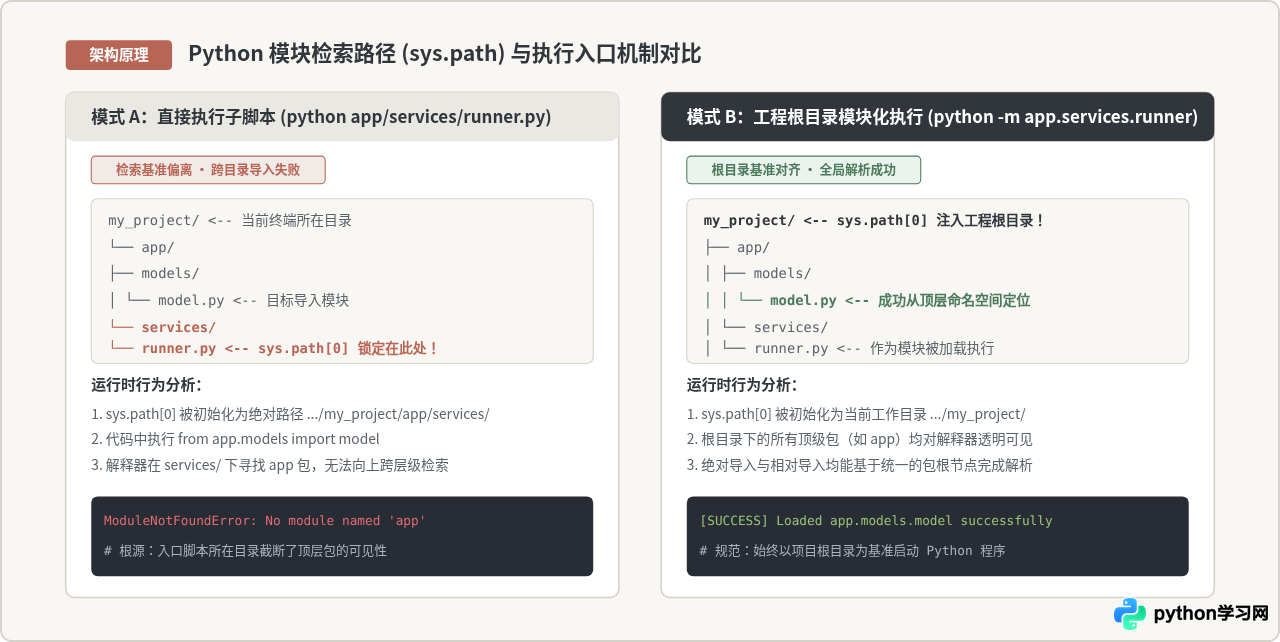
二、四步排查与修复 ModuleNotFoundError
当出现找不到 model.py 的情况时,无需盲目修改代码或随意复制文件。按照以下四个标准步骤排查,可以在数分钟内确立清晰的导入逻辑。
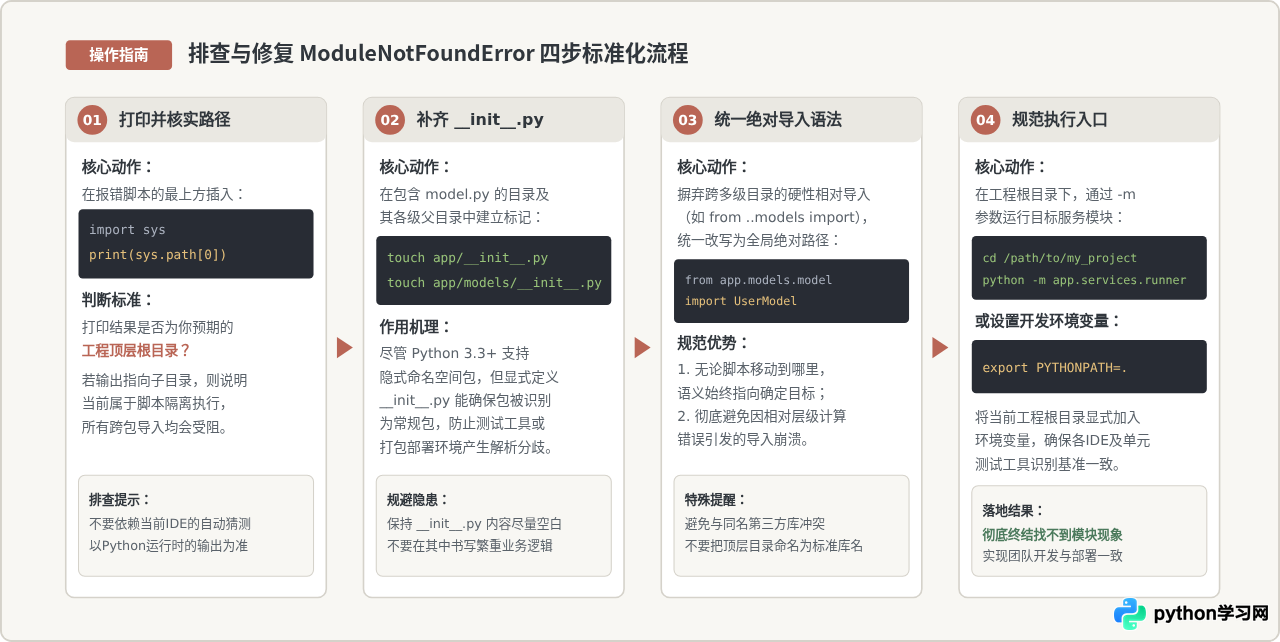
不推荐的做法:滥用 sys.path.append()
在遭遇 ModuleNotFoundError 时,部分开发者喜欢在代码开头强行注入代码:
import sys
import os
# 不推荐:污染全局路径检索逻辑
sys.path.append(os.path.abspath(os.path.join(os.path.dirname(__file__), "..")))
import model
这种做法虽然能在单机执行时暂时掩盖报错,但在实际工程中存在显著弊端:一是代码产生了对物理目录结构的强耦合,文件一旦移动就会失效;二是当不同子目录存在同名文件时,可能导致意外导入错误的模块;三是静态代码分析工具(如 Flake8、Mypy)以及自动化测试框架(如 Pytest)无法提前感知运行时的动态路径修改,导致检查报错。因此,应优先采用规范运行入口和配置 PYTHONPATH 的方式。
三、解构循环依赖:为什么 model.py 最容易发生死锁
当路径配置正确后,另一类更加隐蔽的报错往往随之浮现:
ImportError: cannot import name 'UserModel' from partially initialized module 'app.models.model' (most likely due to a circular import)
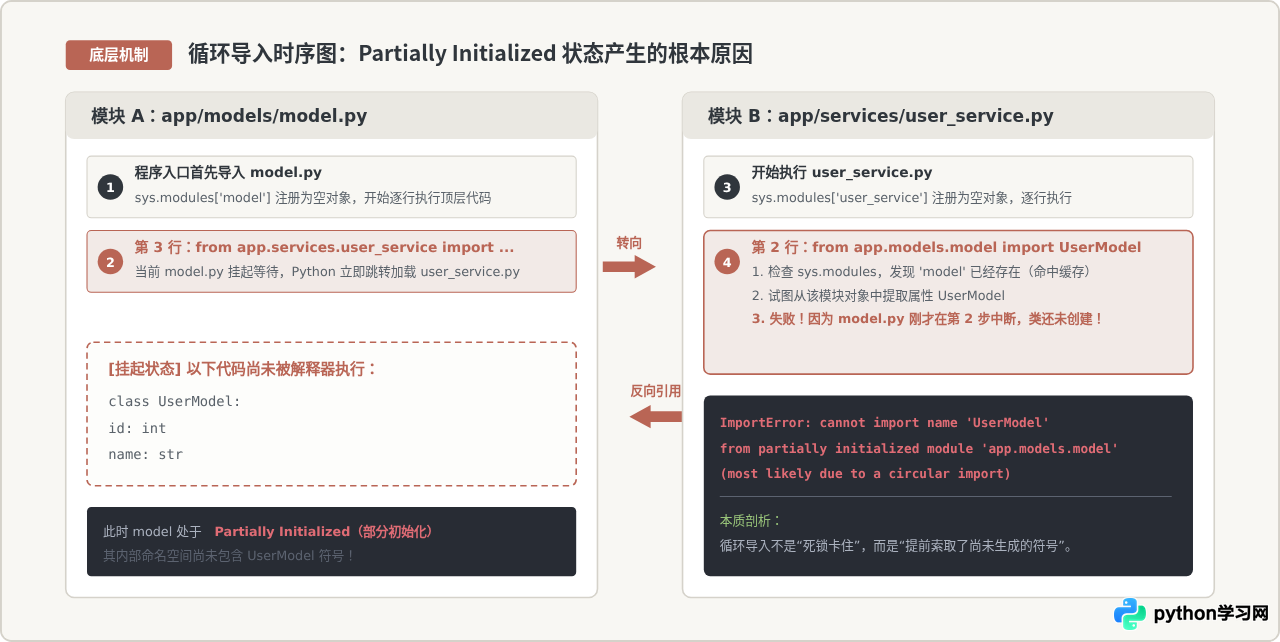
这个报错的核心提示在于 partially initialized module(部分初始化的模块)。要理解为什么会出现这种情况,需要剖析Python执行 import 时的内部步骤:
- 检查缓存:Python在
sys.modules字典中查找该模块是否已被加载。 - 创建模块对象:若未加载,Python在
sys.modules中为该模块创建一个空的模块对象(此时模块内部的代码尚未执行完)。 - 顺序执行字节码:解释器从上至下逐行执行该模块文件中的代码,并在命名空间中填充函数、类或变量定义。
- 完成初始化:所有代码执行完毕,模块正式完成初始化。
在很多业务项目中,model.py 定义了实体对象(如 UserModel),而业务逻辑通常写在 user_service.py 中。如果 model.py 在定义类时为了处理密码哈希或数据验证,在文件顶层写了 from app.services.user_service import hash_password;而 user_service.py 为了对用户进行增删改查,在文件顶层又写了 from app.models.model import UserModel,一个致命的闭环就形成了。
四、彻底消除循环依赖的四种重构方案
消除循环依赖不需要采用难以维护的黑魔法,根据实际代码场景,可以通过架构下沉、类型守卫、延迟加载或依赖传递清晰地拆解耦合。
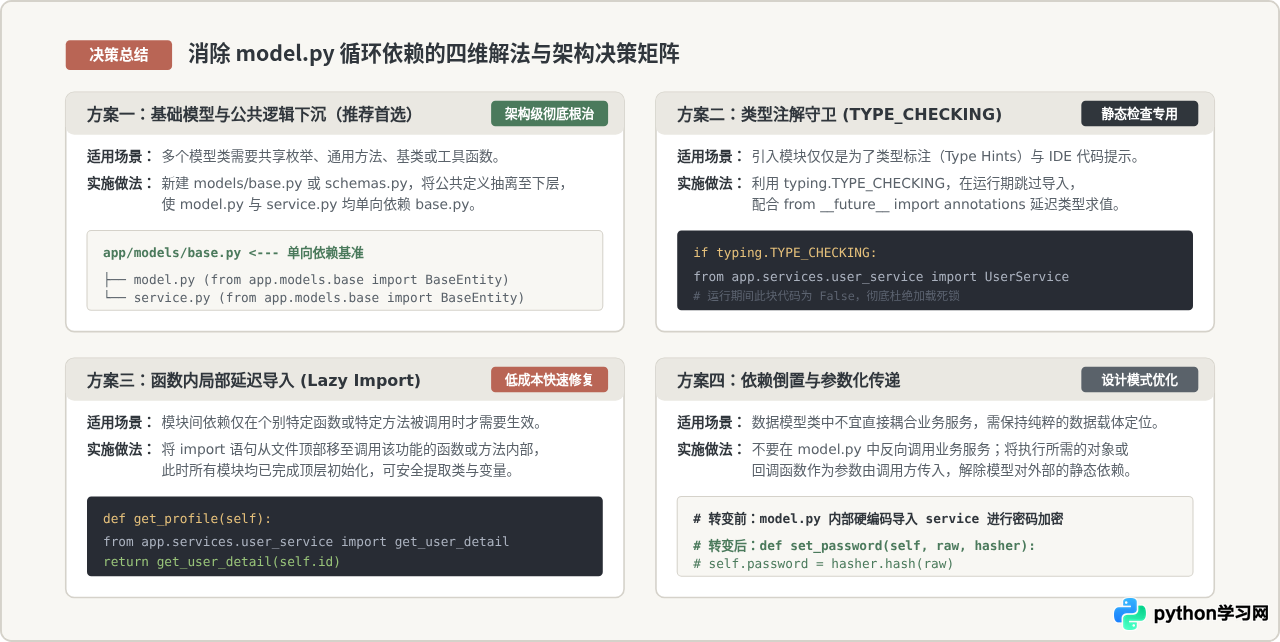
方案具体实现示例
1. 基础模型下沉(推荐的工程重构方式)
如果 model.py 与业务模块产生循环导入,通常是因为 model.py 既承担了“数据结构定义”,又耦合了“基础逻辑与工具函数”。最佳实践是将纯粹的数据实体、接口协议或基础类下沉到单独的底层文件中。
# app/models/base.py
# 基础定义层:仅包含底层基类或通用数据结构,不导入任何上层业务模块
from dataclasses import dataclass
from datetime import datetime

@dataclass
class BaseEntity:
    id: int
created_at: datetime# app/models/model.py
# 实体定义层:单向继承基础层,定义具体模型
from app.models.base import BaseEntity
class UserModel(BaseEntity):
username: str
email: str# app/services/user_service.py
# 业务逻辑层:单向依赖 model 与 base,不产生逆向引用
from app.models.model import UserModel
def create_user(username: str, email: str) -> UserModel:
# 纯净的自顶向下调用流
return UserModel(id=1, username=username, email=email)2. 类型注解守卫(TYPE_CHECKING)
在现代 Python 项目中,静态类型标注普及,很多循环导入仅仅是为了让函数的参数类型注解或返回值类型注解获得代码提示。例如 user_service.py 需要注解参数为 UserModel,而 model.py 需要注解某个字段为 UserService。
此时可以使用 Python 官方推荐的 typing.TYPE_CHECKING。在 Python 运行时,常量 TYPE_CHECKING 始终为 False,代码块中的导入语句完全不会被执行;只有当 Mypy、Pyright 或 IDE 进行静态分析时,该常量才为 True。结合 Python 3.7+ 的 from __future__ import annotations,注解将被作为字符串延迟解析,彻底杜绝运行期的循环导入崩溃。
# app/models/model.py
from __future__ import annotations
from typing import TYPE_CHECKING

if TYPE_CHECKING:
    # 仅在静态检查时被读取,运行期间解释器完全忽略此行
    from app.services.user_service import UserService

class UserModel:
    def __init__(self, username: str):
        self.username = username

    def perform_action(self, service: UserService) -> None:
        # 运行时无需导入 UserService,类型注解正常通过
service.log_action(self.username)3. 函数内局部延迟导入(Lazy Import)
如果现有项目规模庞大、时间紧迫,重构模块层级的改造成本较高,局部延迟导入是最立竿见影的应急方案。
# app/models/model.py

class UserModel:
    def __init__(self, user_id: int):
        self.user_id = user_id

    def sync_external(self):
        # 将导入延迟至方法被调用的时刻
        # 此时整个 Python 虚拟环境与全部模块的顶层代码均已初始化完毕
        from app.services.user_service import sync_user_data
        return sync_user_data(self.user_id)
虽然延迟导入简单直接,但不建议在主流程、高频执行的循环体内部滥用。虽然 Python 对已导入模块有 sys.modules 缓存机制,重复执行 import 的开销较小,但在模块顶部清晰声明依赖关系更符合 PEP 8 规范,便于代码审查与静态依赖分析。
五、工程验证与防范隐患的校验规范
在修复了 ModuleNotFoundError 和循环导入后,如何确保项目后续不会再次引入类似隐患?可以通过以下两项轻量工程实践进行保障:
1. 编写导入冒烟测试(Smoke Test)
在自动化测试套件(如 pytest)中,加入一个最基础的导入冒烟测试用例。该测试不依赖数据库和外部接口,仅以自动化方式遍历加载项目中的所有模块:
# tests/test_imports.py
import importlib
import pkgutil
import app

def test_all_modules_importable():
    """遍历 app 包下的所有子模块,确保不存在循环导入或路径缺失"""
    package = app
    for _, module_name, is_pkg in pkgutil.walk_packages(package.__path__, package.__name__ + "."):
        # 只要存在循环导入死锁或找不到模块,此处立即抛出异常
        imported = importlib.import_module(module_name)
assert imported is not None2. 建立统一的命名规避机制
自定义模块命名尽量具备明确业务属性。将文件直接命名为 model.py 虽然常见,但在大型混合架构中,容易与部分ORM框架或第三方库内置的 model 发生混淆。推荐根据业务边界命名为 user_model.py、order_model.py,或者统一收拢在 models/ 包下并以 app.models.user 方式全路径引入,从而杜绝由于命名遮蔽引起的未知解析故障。
| 问题类型 | 常见报错信息 | 根本诱因 | 推荐解决方案 |
|---|---|---|---|
| 路径未覆盖 | ModuleNotFoundError: No module named 'app' |
直接以脚本路径启动,sys.path[0] 局限在子目录 |
统一在项目根目录使用 python -m 包.模块 运行 |
| 相对导入越界 | ImportError: attempted relative import beyond top-level package |
在顶层运行脚本中混用多级 .. 相对导入 |
改写为以工程根目录为起点的绝对导入 |
| 运行期循环导入 | cannot import name 'X' from partially initialized module |
双向顶层 from A import B,提取了未初始化的属性 |
下沉公共层;或采用函数内局部延迟导入 |
| 静态类型循环 | NameError 或循环引用崩溃 |
为了 IDE 类型提示在文件顶层硬编码导入模型 | 使用 if TYPE_CHECKING: 搭配字符串或未来注解 |
总结而言,针对 model.py 的导入问题,先核对 sys.path[0] 确定检索基准,通过模块化执行(-m)确保顶层命名空间对齐;遇到循环依赖报错时,分析两端模块在顶层相互调用的先后时序,通过提取公共基础层或应用类型守卫打断闭环,即可保持工程结构清晰、稳定且易于维护。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









