

Python汉诺塔递归中怎么统计移动次数
深入讲解在Python汉诺塔递归算法中统计盘子移动次数的4种有效方法,包含纯递归返回值累加、闭包与nonlocal变量、可变参数传递以及生成器解耦,并结合递归调用树与数学公式进行全面解析。
一、汉诺塔递归的核心逻辑与计数原理
汉诺塔问题的标准定义是:有三根柱子(起始柱 A、辅助柱 B、目标柱 C)和 n 个大小各不相同的圆盘,目标是将所有圆盘从 A 移动到 C,且移动过程中大盘永远不能压在小盘上方。
递归解决该问题的思维模型分为固定的三步:
- 将上面的
n - 1个圆盘从起始柱 A 借助目标柱 C 移动到辅助柱 B; - 将最底部的第
n个圆盘从起始柱 A 直接移动到目标柱 C(计为 1 次移动); - 将辅助柱 B 上的
n - 1个圆盘借助起始柱 A 移动到目标柱 C。
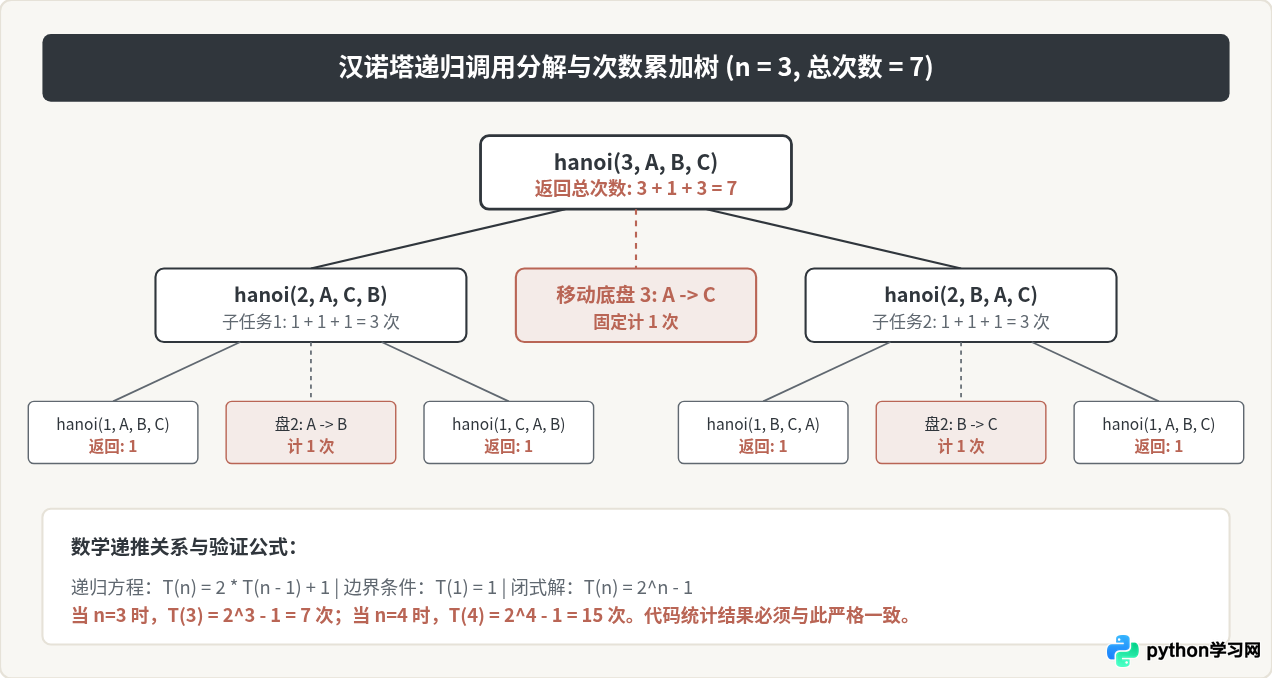
如果令 \( T(n) \) 表示移动 n 个圆盘所需的移动次数,由上述过程可直接得出递归方程:
T(n) = T(n - 1) + 1 + T(n - 1) = 2 * T(n - 1) + 1,基准条件为 T(1) = 1。
数学通项公式为 T(n) = 2^n - 1。在编写代码时,统计移动次数就是把这个递推关系转化为程序运行时的状态计数。
二、方案一:纯递归返回值累加(推荐方案)
在函数式编程思想中,函数应当尽可能保持无副作用。最自然、最优雅的统计方式是让递归函数直接返回当前步骤及子步骤的总移动次数。
具体实现非常清晰:当 n == 1 时,移动 1 次,直接返回 1;当 n > 1 时,当前层的总次数等于第一阶段子问题的移动次数、中间移动底盘的 1 次,以及第三阶段子问题的移动次数之和。
def hanoi_count(n, source, target, auxiliary):
    """
    通过返回值直接累加统计汉诺塔移动次数
    :param n: 盘子总数
    :param source: 起始柱
    :param target: 目标柱
    :param auxiliary: 辅助柱
    :return: 移动的总次数
    """
    # 基准条件:只有 1 个盘子,直接移动 1 次
    if n == 1:
        print(f"移动盘 1: {source} -> {target}")
        return 1

    # 步骤 1:将 n-1 个盘子从 source 移到 auxiliary
    count1 = hanoi_count(n - 1, source, auxiliary, target)

    # 步骤 2:将底部的第 n 个盘子从 source 移到 target
    print(f"移动盘 {n}: {source} -> {target}")
    current_move = 1

    # 步骤 3:将 n-1 个盘子从 auxiliary 移到 target
    count2 = hanoi_count(n - 1, auxiliary, target, source)

    # 汇总并返回本层及所有子递归的移动总次数
    return count1 + current_move + count2

# 执行示例
total = hanoi_count(3, 'A', 'C', 'B')
print(f"3个盘子共移动了 {total} 次")
示例输出:
移动盘 1: A -> C
移动盘 2: A -> B
移动盘 1: C -> B
移动盘 3: A -> C
移动盘 1: B -> A
移动盘 2: B -> C
移动盘 1: A -> C
3个盘子共移动了 7 次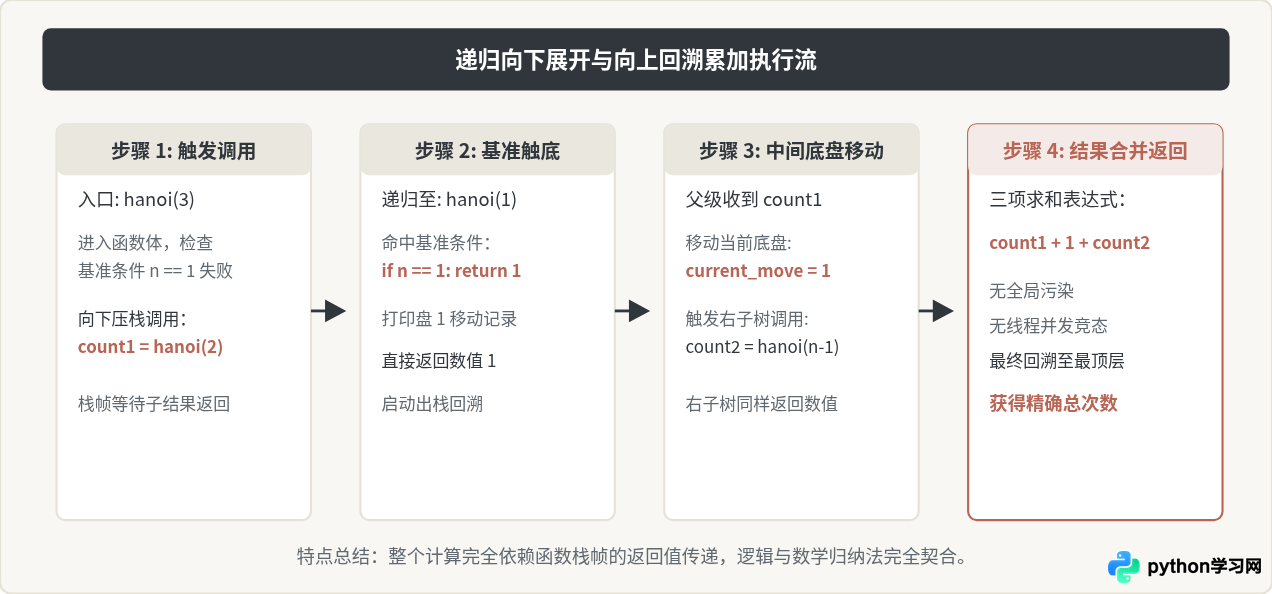
许多初学者倾向于定义一个外部全局变量 global count,并在每次移动时 count += 1。这种做法在简单演示脚本中看似可行,但在生产代码或单元测试中存在严重缺陷:全局状态在多次调用之间无法自动重置,容易受到并发执行的污染,且破坏了函数的自包含性。纯返回值累加没有任何外部副作用,天然支持测试与复用。
三、方案二:利用闭包与 nonlocal 变量统计
有些场景下,用户希望对外暴露的接口极其简单(例如只传入圆盘数量 n),函数内部负责打印移动步骤,同时执行完毕后返回总移动次数。此时,使用外层函数嵌套递归函数,并通过 nonlocal 声明修改外层作用域中的计数变量是最地道的 Pythonic 方案。
def solve_hanoi(n):
    """
    使用闭包封装汉诺塔求解过程,并通过 nonlocal 统计移动次数
    :param n: 盘子总数
    :return: 移动的总次数
    """
    count = 0  # 闭包环境下的局部计数变量

    def _hanoi(num, src, dst, aux):
        nonlocal count  # 声明使用外层函数的 count
        if num == 1:
            print(f"移动盘 1: {src} -> {dst}")
            count += 1
            return

        # 步骤 1: 将上面的 num-1 移至辅助柱
        _hanoi(num - 1, src, aux, dst)

        # 步骤 2: 移动底盘
        print(f"移动盘 {num}: {src} -> {dst}")
        count += 1

        # 步骤 3: 将辅助柱上的 num-1 移至目标柱
        _hanoi(num - 1, aux, dst, src)

    # 启动递归求解(默认柱子为 A, C, B)
    _hanoi(n, 'A', 'C', 'B')
    return count

# 执行示例
moves = solve_hanoi(3)
print(f"执行完毕,总移动次数: {moves}")
代码原理解释:
在 Python 中,如果内部函数要对包含它的外层函数(非全局)中的变量进行赋值操作,必须使用 nonlocal 关键字。如果不加 nonlocal count,执行 count += 1 时 Python 会将其视为内层函数的局部变量赋值,因未先初始化而抛出 UnboundLocalError: cannot access local variable 'count' where it is not associated with a value 异常。通过 nonlocal,每次移动底盘时计数器都会直接修改外层函数的 count。
四、方案三:传递可变对象参数与类封装
在部分架构设计中,递归函数可能需要被外部监控,或者需要在一次递归中统计多种指标(例如不仅统计总移动次数,还记录每个盘子的移动频次、柱子上的盘子状态快照等)。此时,通过参数传入可变对象(如列表、字典或自定义数据类)是极佳的选择。
1. 传入单元素列表作为计数器容器
在 Python 中,基本整数类型 int 是不可变对象,作为参数传入函数时进行的是“值传递”,在子函数中直接加一无法影响父层。但是列表(List)是可变对象,在所有递归层级中传递同一个列表的引用,修改列表元素 counter[0] += 1 会在全局生效。
def hanoi_with_list(n, src, dst, aux, counter=None):
    if counter is None:
        counter = [0]  # 避免可变默认参数陷阱,在调用时初始化

    if n == 1:
        print(f"移动盘 1: {src} -> {dst}")
        counter[0] += 1
        return counter[0]

    hanoi_with_list(n - 1, src, aux, dst, counter)
    print(f"移动盘 {n}: {src} -> {dst}")
    counter[0] += 1
    hanoi_with_list(n - 1, aux, dst, src, counter)

    return counter[0]

# 调用验证
total_moves = hanoi_with_list(3, 'A', 'C', 'B')
print(f"列表传参计数结果: {total_moves}")
2. 封装为面向对象类(Class)
如果需要更健全的状态跟踪,可以构建一个 HanoiSolver 类,将 move_count 作为实例属性:
class HanoiSolver:
    def __init__(self):
        self.move_count = 0
        self.history = []

    def solve(self, n, src='A', dst='C', aux='B'):
        self.move_count = 0
        self.history.clear()
        self._recursive_step(n, src, dst, aux)
        return self.move_count

    def _recursive_step(self, n, src, dst, aux):
        if n == 1:
            self._record_move(1, src, dst)
            return

        self._recursive_step(n - 1, src, aux, dst)
        self._record_move(n, src, dst)
        self._recursive_step(n - 1, aux, dst, src)

    def _record_move(self, disk, src, dst):
        self.move_count += 1
        self.history.append((disk, src, dst))
        print(f"第 {self.move_count:02d} 步 | 移动盘 {disk}: {src} -> {dst}")

# 使用类实例求解
solver = HanoiSolver()
count = solver.solve(3)
print(f"总计移动: {count} 次")
五、方案四:使用生成器 yield 实现移动与计数解耦
如果在实际应用中,不仅需要计算移动次数,还希望将移动步骤交给上层调用方自定义处理(例如渲染动画、写入数据库、异步发送等),此时使用 yield 生成器是最高效的做法。
递归生成器每次只产生一步具体的移动元组 (disk, src, dst)。调用方可以直接遍历每一步,也可以直接使用内置函数 sum(1 for _ in generator) 获取总次数,这实现了“求解算法”与“统计展示”的彻底解耦。
def hanoi_generator(n, src, dst, aux):
    """
    汉诺塔递归生成器:每次 yield 一个移动动作元组 (disk_id, from_rod, to_rod)
    """
    if n == 1:
        yield (1, src, dst)
        return

    # yield from 委托给子生成器
    yield from hanoi_generator(n - 1, src, aux, dst)
    yield (n, src, dst)
    yield from hanoi_generator(n - 1, aux, dst, src)

# 方式 A:实时输出每一步
print("--- 逐步消费生成器 ---")
step = 0
for disk, src, dst in hanoi_generator(3, 'A', 'C', 'B'):
    step += 1
    print(f"第 {step} 步: 盘 {disk} 从 {src} 移动到 {dst}")

# 方式 B:直接用生成器推导式统计总数(内存开销仅为 O(1))
total = sum(1 for _ in hanoi_generator(3, 'A', 'C', 'B'))
print(f"通过生成器解耦统计的总次数: {total}")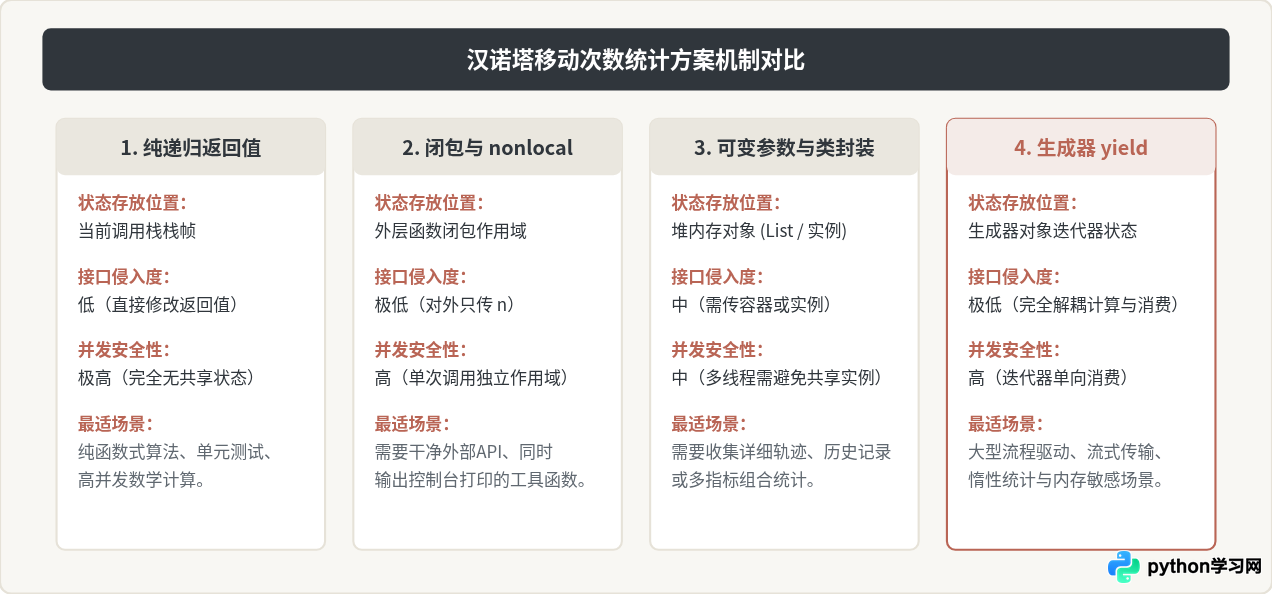
六、运行结果验证与自动化测试
在编写完统计逻辑后,应当如何验证统计结果的准确性?
数学上已证明,n 个圆盘的汉诺塔最优移动步数绝对等于 2^n - 1。因此,我们可以在 Python 中通过内置的 assert 语句或 unittest 模块,对比递归统计出的移动次数与位运算计算结果 (1 << n) - 1。
def test_hanoi_counts():
    for n in range(1, 11):  # 测试 1 到 10 个盘子
        expected = (1 << n) - 1  # 等价于 2^n - 1

        # 验证方案一:纯递归返回值
        # 为了不刷屏,临时静音打印
        count_ret = hanoi_count_silent(n, 'A', 'C', 'B')
        assert count_ret == expected, f"盘数 {n} 纯递归计算有误: 得到 {count_ret}, 期望 {expected}"

        # 验证方案四:生成器计数
        count_gen = sum(1 for _ in hanoi_generator(n, 'A', 'C', 'B'))
        assert count_gen == expected, f"盘数 {n} 生成器计算有误: 得到 {count_gen}, 期望 {expected}"

        print(f"验证通过: n = {n:2d} | 理论移动次数 = 递归统计次数 = {expected:4d}")

def hanoi_count_silent(n, src, dst, aux):
    if n == 1:
        return 1
    return hanoi_count_silent(n - 1, src, aux, dst) + 1 + hanoi_count_silent(n - 1, aux, dst, src)

test_hanoi_counts()
测试输出结果:
验证通过: n =  1 | 理论移动次数 = 递归统计次数 =    1
验证通过: n =  2 | 理论移动次数 = 递归统计次数 =    3
验证通过: n =  3 | 理论移动次数 = 递归统计次数 =    7
验证通过: n =  4 | 理论移动次数 = 递归统计次数 =   15
验证通过: n =  5 | 理论移动次数 = 递归统计次数 =   31
验证通过: n =  6 | 理论移动次数 = 递归统计次数 =   63
验证通过: n =  7 | 理论移动次数 = 递归统计次数 =  127
验证通过: n =  8 | 理论移动次数 = 递归统计次数 =  255
验证通过: n =  9 | 理论移动次数 = 递归统计次数 =  511
验证通过: n = 10 | 理论移动次数 = 递归统计次数 = 1023
七、选型总结与避坑清单
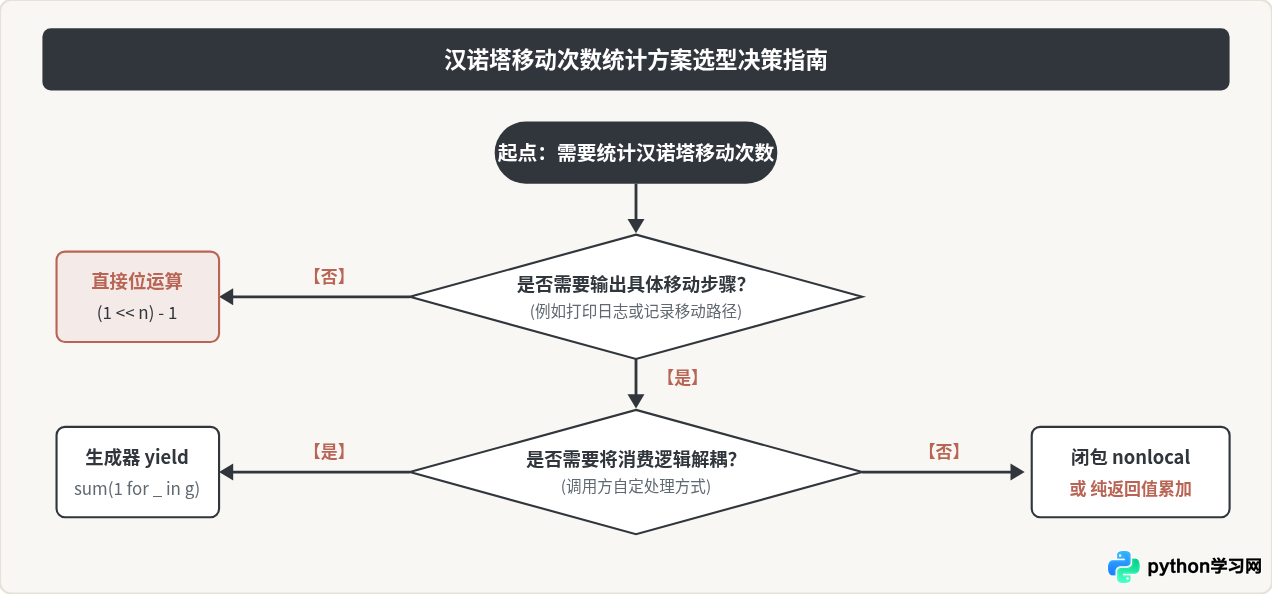
在不同场景下,应根据代码维护性和架构需求选择最合适的统计方式:
- 优先选择纯递归返回值累加:无状态依赖、可测性最好,符合函数式规范。
- 对外暴露精简 API 时选择闭包与 nonlocal:既可以保留详细打印,又不会让调用方感知到多余的计数参数。
- 解耦数据生产与消费时选择生成器:上层可以任意决定是打印步骤、存储日志还是仅仅计算次数。
- 切忌使用未初始化的 global 变量:全局变量在多次调用时无法清零,若发生并发会导致计数错误。
- 注意 Python 默认最大递归深度:Python 默认的递归调用深度为 1000。但汉诺塔算法的时间复杂度为 \( O(2^n) \),当
n > 25时运算次数已超过 3000 万次,真正的瓶颈在于指数级运行时间而非栈深度。对于超大数量盘子,不要尝试通过实际递归模拟全部步骤,应直接使用位运算(1 << n) - 1。 - 注意可变参数的默认值陷阱:定义
def hanoi(..., counter=[])会导致多次调用共用同一个列表对象。必须使用counter=None并在函数内部初始化if counter is None: counter = [0]。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









