

学Python 3常见的5个误区及避坑指南
深入解析初学Python 3最常见的5个认知误区与技术陷阱,涵盖报错排查、变量引用与默认参数、虚拟环境隔离、Pythonic惯用写法及版本混淆,提供具体可执行的避坑指南与直观图解。
误区一:只看不写与死记语法,遇到报错就恐慌放弃
不少人在学习 Python 3 时,习惯把整本教材或视频教程从头到尾看完,甚至花大量时间抄录语法笔记,却很少在本地终端主动运行代码。这种学习方式看似充实,实则脱离了编程的反馈闭环。一旦独立写程序遇到终端打印红色的 Traceback(回溯信息),便容易产生挫败感,甚至直接复制报错信息去网上碰运气,而不去阅读错误本身。
这种做法看似合理,因为初学者期望“完全准备好再写”,但在编程实践中,错误信息恰恰是最精确的即时调试导师。Python 的异常机制设计得非常清晰,回溯信息不是乱码,而是程序执行失败时按调用栈记录的现场快照。
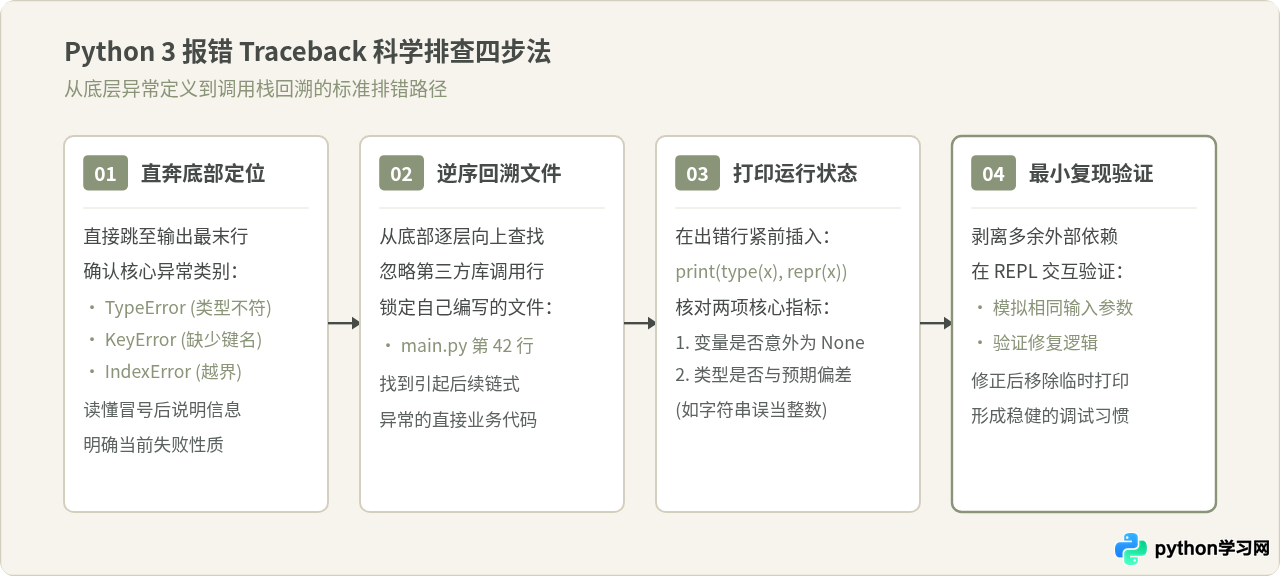
遇到报错时,按照固定顺序提取信息,不再盲目搜索:
- 先读最末行:最末行包含异常类别(如
TypeError、KeyError、IndexError)以及具体的错误描述。例如IndexError: list index out of range直接指明列表索引越界。 - 逆序定位代码行:从末行向上看调用栈,跳过标准库和第三方库的代码路径,找到第一个属于你自己编写的文件名与行号。
- 打印关键变量状态:在报错行的前一行,通过
print(type(var), repr(var))打印相关变量的真实类型和内容,确认实际值是否与预期相符。 - 构造最小复现:将报错的核心几行代码复制到 Python 交互式命令行(REPL)中,使用简单的假数据验证逻辑。
误区二:误将“变量”理解为盒子,忽视对象引用与可变性
在许多静态语言(如 C)中,变量常被直观地比喻为“装数据的盒子”:分配一块内存盒子,把数值装进去;赋值相当于开辟新盒子并把值拷贝进去。初学者带着这种模型学 Python 3,极易在处理列表、字典等可变对象时产生逻辑严重失控的代码。
在 Python 中,变量不是盒子,而是贴在对象上的“便利贴标签”。执行 a = [1, 2] 是在堆内存创建了一个列表对象,并把标签 a 贴上去;紧接着执行 b = a,并不是创建了一个新列表,而是把标签 b 也贴到了同一个列表对象上。当通过 b.append(3) 修改对象时,查看 a 会发现其内容同样变成了 [1, 2, 3]。
这个机制引申出 Python 初学者最经典的一个大坑:可变对象作为函数默认参数。
# 错误示例:默认参数在函数定义时求值且仅创建一次
def add_item(item, target_list=[]):
    target_list.append(item)
    return target_list

# 连续两次不带第二个参数调用
print(add_item("苹果"))  # 输出: ['苹果']
print(add_item("香蕉"))  # 期望: ['香蕉'],实际输出: ['苹果', '香蕉']!
为什么会这样?因为 def 语句在 Python 中是可执行代码。当模块加载并定义函数时,默认参数 target_list=[] 就已经被执行并创建了一个唯一的空列表对象。后续所有不传该参数的函数调用,都会共用该同一个列表对象。
凡是参数可能需要列表、字典等可变容器的场景,一律将默认值设为 None,并在函数体内按需初始化新对象:
def add_item(item, target_list=None):
    if target_list is None:
        target_list = []  # 每次调用时独立创建全新的局部列表
    target_list.append(item)
    return target_list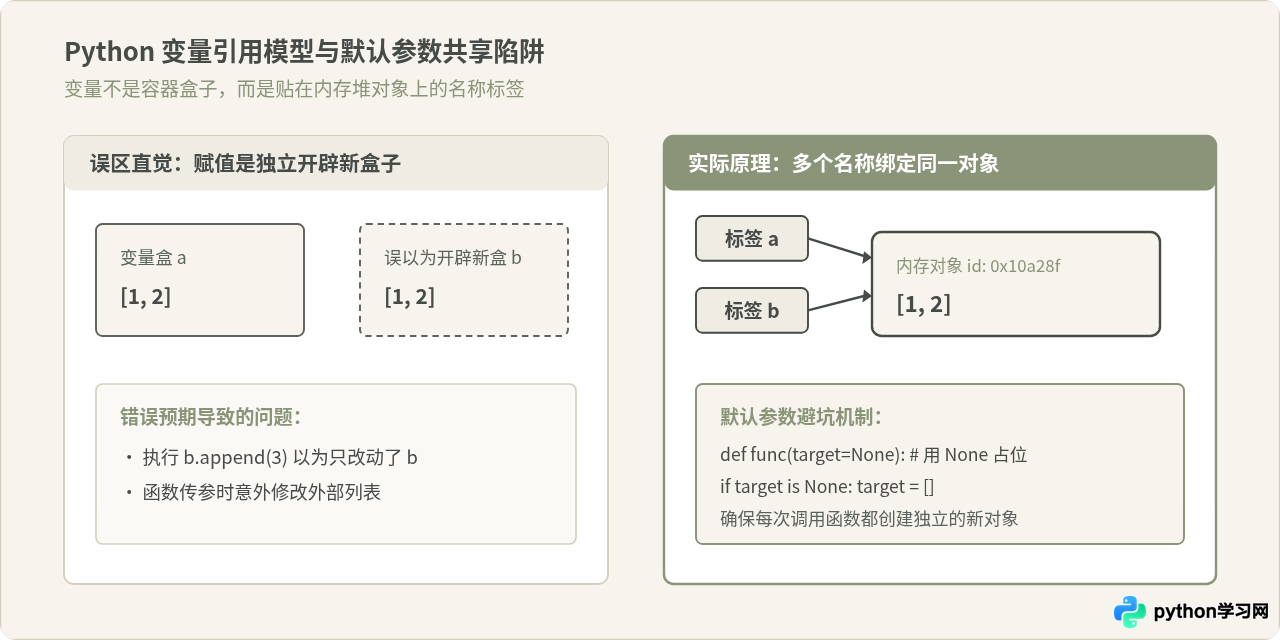
误区三:全局安装第三方库,忽视虚拟环境隔离
初学者在学会使用 pip install 后,往往喜欢直接在全局操作系统环境下安装所有需要的包。短期内,这种做法看起来很方便,不用考虑任何路径切换。然而随着项目增多,这种习惯会迅速埋下隐患。
例如,项目 A 需要使用某个 Web 框架的 2.0 版本,而两个月后接触的项目 B 依赖该框架的 3.0 版本。全局环境下同一时刻只能存在一个版本,升级项目 B 所需的包就会直接破坏项目 A 的运行环境。此外,在 macOS 或 Linux 系统上,系统本身也依赖全局 Python 环境运行各种底层工具,直接使用 sudo pip install 甚至可能破坏系统组件。
Python 3.3 之后,标准库内置了轻量级虚拟环境工具 venv。养成进入项目目录即创建并激活虚拟环境的条件反射:
# 1. 终端进入你的项目专用目录
cd my_project

# 2. 创建名为 .venv 的隔离虚拟环境
python3 -m venv .venv

# 3. 激活虚拟环境
# macOS / Linux 平台执行:
source .venv/bin/activate
# Windows PowerShell 平台执行:
.venv\Scripts\Activate.ps1

# 4. 激活后终端提示符前会出现 (.venv),此时安装包完全独立于系统
pip install requests

# 5. 固化当前项目的依赖清单
pip freeze > requirements.txt
他人或你在其他机器上获取该项目后,只需执行 pip install -r requirements.txt,即可在秒级重现完全一致的依赖环境,不再受全局包污染困扰。
误区四:用 C/Java 思维硬套 Python,写出低效繁琐的代码
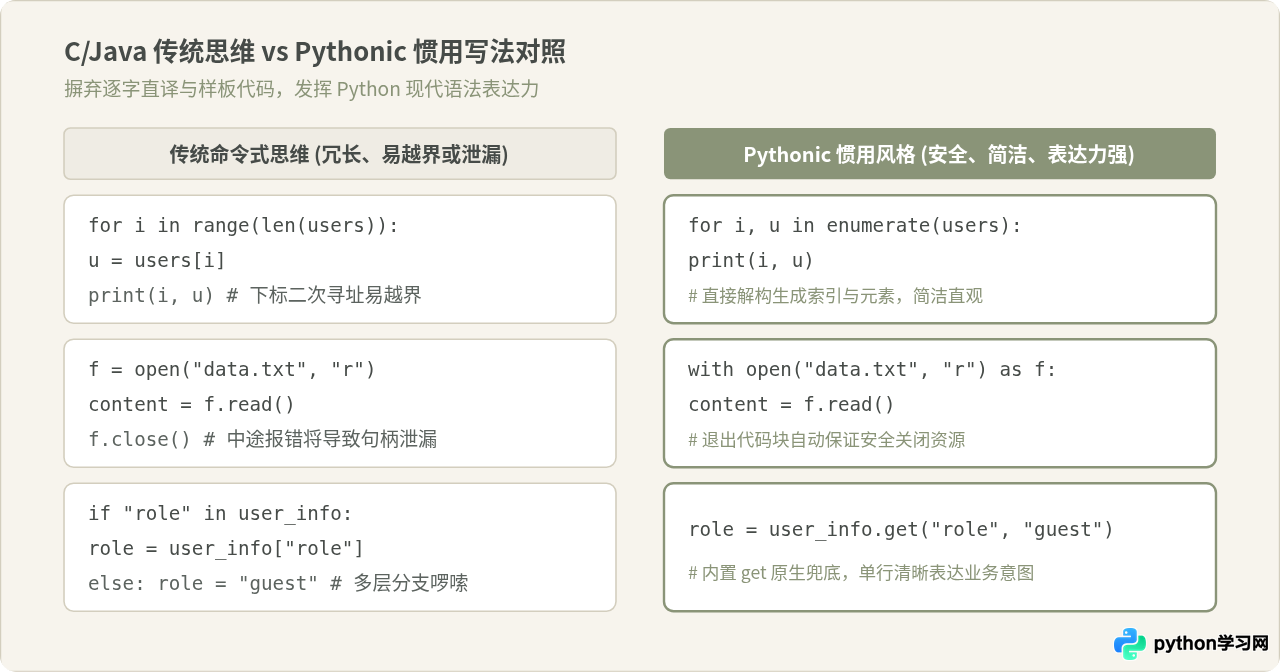
有其他语言基础的学习者在转向 Python 3 时,最常犯的毛病是“用 Python 的关键字写 C 语言”。例如,习惯通过下标索引用 range(len(lst)) 遍历元素;手动打开文件并在末尾写 f.close();或者在查询字典前总是嵌套一层显式的 if key in dict 检查。
这种写法虽然能够执行,却放弃了 Python 作为高级语言的核心优势:内置的高阶协议与优雅的抽象能力。
- 遍历元素:Python 的
for循环本质是迭代器协议,可以直接取出元素。如果需要同时获取索引和元素,标准库提供了enumerate(),无须通过下标二次寻址。 - 资源管理:如果写
f = open(...)并在末尾手动f.close(),一旦读写过程中抛出异常,close()就无法被执行,导致文件句柄泄漏。Python 提供了with上下文管理器,无论代码是否中途报错,退出作用域时都会确保资源被彻底释放。 - 字典访问:利用
dict.get(key, default),可以在单行内安全处理键不存在的情况,避免冗长脆弱的条件判断。
误区五:混淆 Python 2 与 Python 3 差异,盲目跟随过时教程
Python 官方早在 2020 年 1 月 1 日就已正式停止对 Python 2 的支持与维护,但在网络搜索引擎中,仍有大量 2015 年前编写的旧博客和搬运教程排在显著位置。初学者若缺乏版本辨识能力,很容易在根本不兼容的旧语法上浪费时间。
Python 3 不是 Python 2 的简单升级,而是在底层架构上做出了诸多重大修正:
- 字符串与字节的区别:Python 2 中的
str本质是原始字节序列,对中文字符串极易报出臭名昭著的UnicodeDecodeError。而在 Python 3 中,所有文本字符串str默认均为 Unicode,二进制数据则严格独立为bytes类型,两者不能隐式混合运算。 - 除法行为:在 Python 2 中,
5 / 2的结果是2(整数截断);而在 Python 3 中,单斜杠/统一为真除法,5 / 2得到精确浮点数2.5,如果需要整除必须显式使用双斜杠//。 - 基础语句函数化:Python 2 中的
print "text"属于关键字语句,在 Python 3 中已被彻底规范为内建函数print("text")。
- 看代码头部与 print:如果正文第一行出现
# -*- coding: utf-8 -*-,且代码中存在无括号的print "hello",直接关闭网页,这是纯粹的 Python 2 代码。 - 看输入函数与字典遍历:使用
raw_input()或dict.iteritems()的都是旧时代产物;Python 3 统一使用input()与dict.items()。 - 拥抱现代特性:推荐学习 Python 3.8+ 及以上版本的教程。优先使用 Python 3.6 引入的 f-string 格式化(例如
f"用户: {name}, 年龄: {age}"),它比早期的%占位符和str.format()更清晰、更高效。
总结:从语法记忆走向工程心智模型
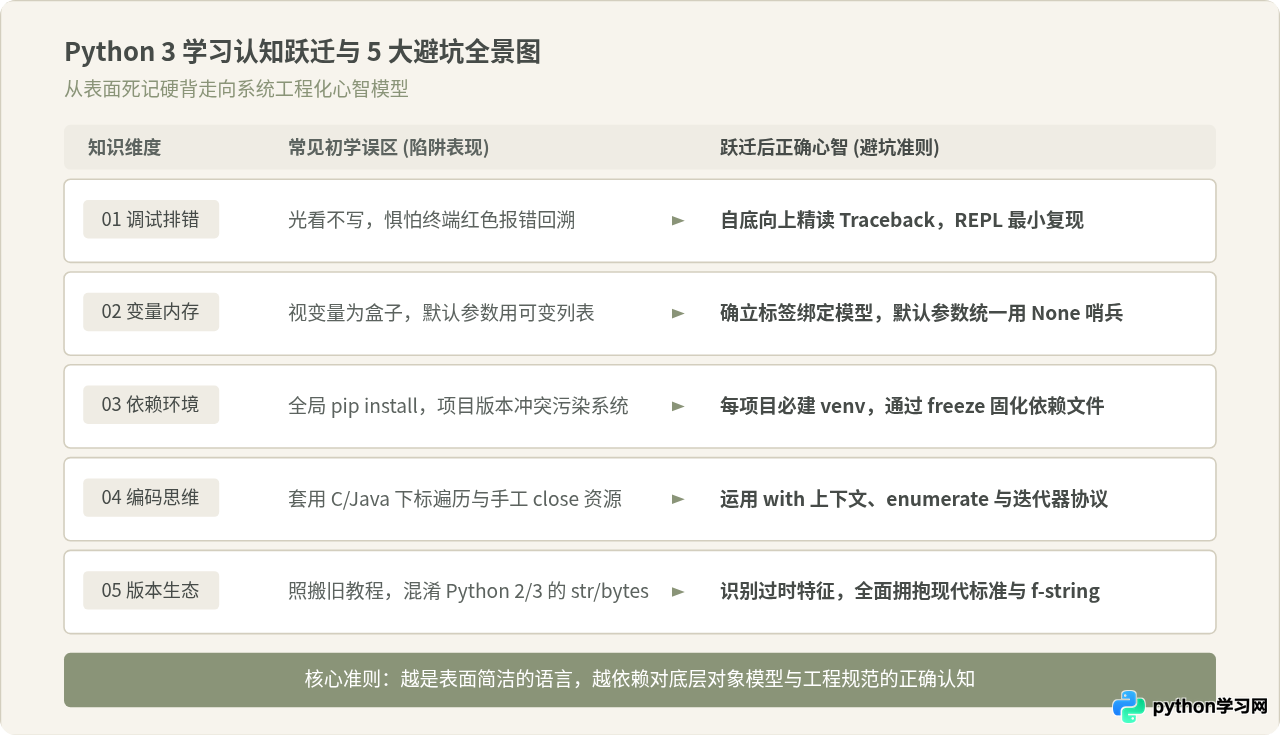
学习 Python 3 的过程,本质上是一场心智模型的跃迁。初学者容易被“语法少、好上手”的表象吸引,却容易被隐藏在语法背后的动态对象模型、包隔离体系和异常调试机制所困扰。
避免走弯路的核心在于:尽早建立“代码反馈”、“变量引用”与“工程隔离”这三根支柱。遇到报错时把 Traceback 当作导航而非阻碍,在函数设计中牢记引用与可变性,在项目启动第一天规范使用虚拟环境,并多使用标准库提供的惯用语法。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









