

初学者怎么理解Python程序设计思维:简洁语法背后的逻辑
解析Python程序设计思维的核心逻辑,从变量引用模型、声明式表达、迭代协议到四步设计推导流程,帮助初学者跨越从机械语法到地道Pythonic逻辑的认知鸿沟。
理解Python程序设计思维,核心在于完成从“如何指挥计算机执行指令步骤”到“如何直接在问题域构建数据流动与表达意图”的认知转变。Python表面上的简洁语法并不是单纯删减括号或减少击键量的排版技巧,而是语言设计者将底层内存分配、指针追踪、繁琐类型声明和状态循环等机械操作进行了高阶封装,引导开发者将注意力收敛到数据本质和逻辑契约上。
一、从指令驱动到意图表达:语法糖背后的抽象层级
在传统的低级或底层命令式语言中,开发者的思考重心往往被绑定在执行细节上。例如在数组中筛选正数并计算其平方,传统方式需要预先声明目标数组容量、初始化整数索引变量、编写边界检测逻辑,并在循环体内逐个取值、判断、计算与追加。整个过程充满了对计算机具体硬件动作的细节指挥。
# 传统命令式思维:逐步控制索引与存储状态
numbers = [-3, -1, 2, 4, -5, 6]
result = []
for i in range(len(numbers)):
    if numbers[i] > 0:
        val = numbers[i] * numbers[i]
        result.append(val)
而在Python中,相同的逻辑通常被组织为更加聚焦计算意图的推导形式:
# Pythonic思维:聚焦数据转换意图与过滤条件
numbers = [-3, -1, 2, 4, -5, 6]
result = [x * x for x in numbers if x > 0]这行简明代码的背后,包含了Python程序设计的首要法则:优先声明“计算什么”,而非流水账式地描写“计算机该怎么转动齿轮”。列表推导式并不是单纯的语法缩写,它在字节码层级针对集合构建进行了专门优化,避开了循环体内高频次的方法寻址开销,在保持表达直观的同时兼顾了确定性的执行效率。
二、核心机制解构:变量贴签与引用对象模型
许多初学者在学习Python时感到迷惑,往往是因为他们潜意识里依然沿用“变量是一个存放数据的实体盒子”这种传统观念。在这种观念中,赋值操作被理解为把数据放进盒子里,覆盖旧数据。
但在Python中,这一基础模型彻底改变了:内存中一切皆为独立存在的高阶对象,而变量只是贴在对象上的名字标签(引用)。执行 a = [1, 2, 3] 时,系统在堆内存中开辟空间创建了一个列表对象,然后将名为 a 的标签贴在该对象上;当执行 b = a 时,并没有发生数组拷贝,而是将名为 b 的标签同样贴到了同一个列表对象上。
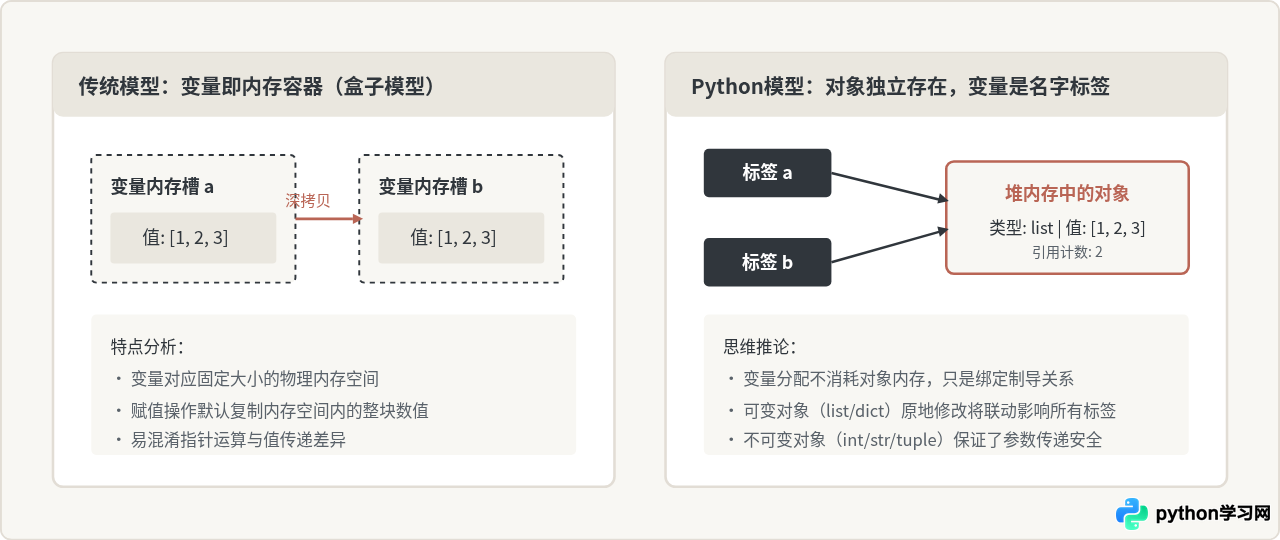
明确了“标签与对象”的物理分离,初学者就能顺理成章地理解为什么对 b.append(4) 操作会导致 a 的内容也发生变化,同时也能深刻领会函数传参时“既不是传值也不是传指针,而是传递对象引用”的设计真谛。
三、建立Python程序设计思维的四步推导路径
当面对一个实际业务需求时,成熟的Python程序员很少直接从 for、while 和临时计数器开始构思。他们通常遵循一套自顶向下的思考模型,将业务命题映射到语言特有的数据构造体系中。以下是建立该思维的四个具体步骤:
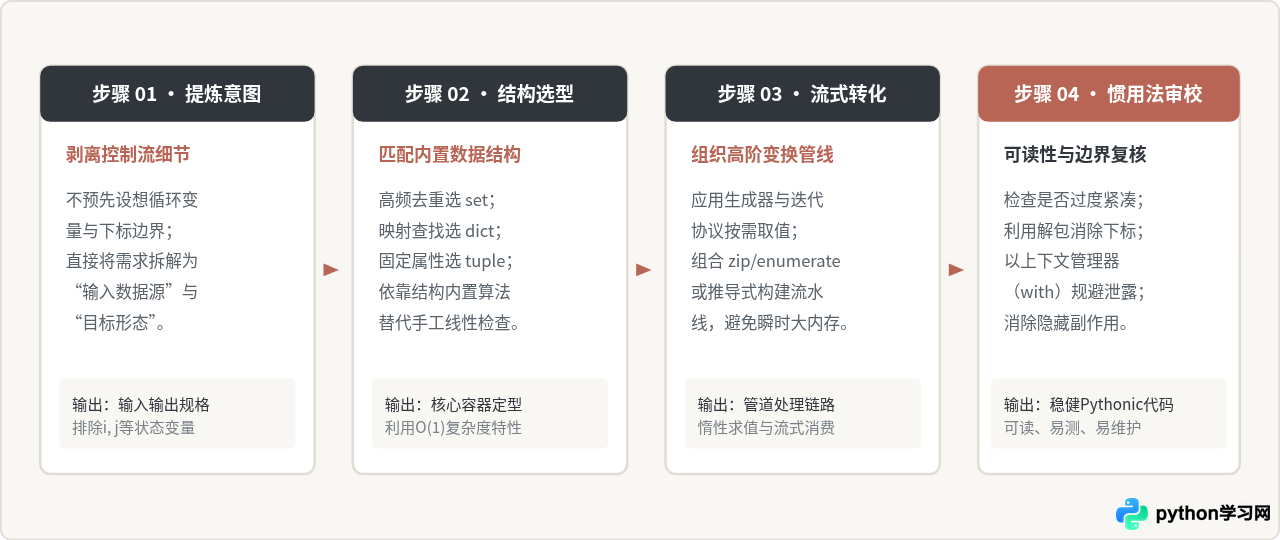
操作案例演练:统计日志中访问频率前三的错误IP
假设我们需要分析一份Web访问日志,提取所有状态码为 500 的请求来源 IP,并找出出现频率最高的前 3 个 IP 地址。
初学者若采用“C语言式”思路,容易陷入如下困境:手工创建双重列表或双数组,外层遍历匹配 IP,内层维护一个并行的计数列表,接着手工编写冒泡排序或选择排序找到最大值。这种写法代码行数动辄数十行,极易产生下标越界与维护灾难。
# 应用四步思维推导出的 Pythonic 方案:
from collections import Counter

def get_top_error_ips(log_lines):
    # 步骤1 & 步骤2: 抽取清洗,通过生成器表达式直接提取目标对象
    error_ips = (
        line.split()[0]
        for line in log_lines
        if " 500 " in line
    )
    # 步骤3 & 步骤4: 利用内置专业容器结构 Counter 自动完成哈希聚合与堆排序
    return Counter(error_ips).most_common(3)
这段代码清晰体现了思维推导的价值:通过生成器表达式 (...) 实现惰性解析,不需要一次性将数百万条日志切分存入内存;随后交由标准库中的 Counter 完成频次统计,其内部基于 C 优化的哈希表和 heapq 实现,开发效率与运行时性能都远超手写循环。
四、机制支柱:迭代器协议与控制流解耦
Python中极其优雅的 for...in 循环,其底层逻辑完全依赖于迭代器协议(Iterator Protocol)。理解这一机制是摆脱“索引依赖症”的关键一步。
在底层,任何实现了 __iter__() 方法的对象都是可迭代对象(Iterable)。当把它传入 for 循环时,解释器先调用该方法获取一个独立的迭代器对象(Iterator);接着反复调用该迭代器的 __next__() 方法取得下一个元素;直到遇到 StopIteration 异常自动退出。
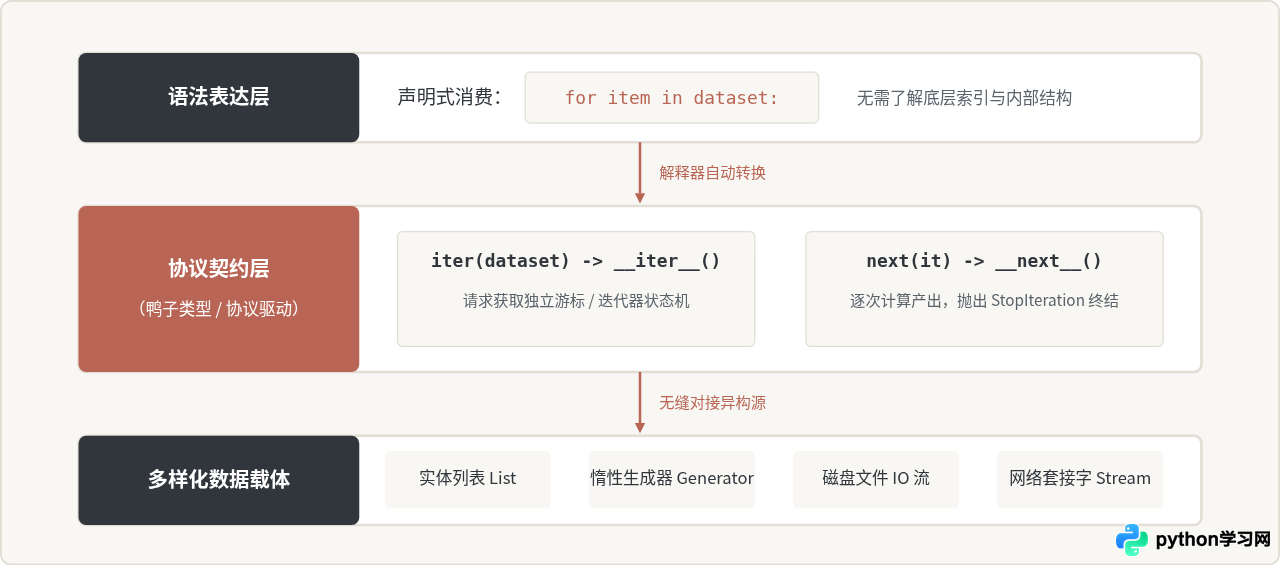
这种设计的深远意义在于:控制流逻辑与底层数据源彻底解耦。上层的 for item in source: 语句完全不在意 source 究竟是内存中已经全部就绪的十万条列表,还是每次通过网络请求一条一条实时拉取的传感器流,亦或是数吉字节容量的日志文件。这种“按契约消费数据”的模式,构成了 Python 异步流、生成器管道以及海量数据处理的基石。
五、常见认知误区与反例辨析
为了真正掌握Python设计思维,不仅要学会怎么写出优美代码,更要辨识那些看似掌握了技巧、实则违背Python哲学的典型误区:
误区一:把“简洁”当成“压缩字符数”,写出难懂的单行怪兽
许多初学者误以为越短的代码越具备“Pythonic”风格,甚至将多层条件判断、字典提取和列表嵌套强行压缩到一行内。这恰恰违背了《Python之禅》中明确指出的核心准则:“可读性计数(Readability counts)”与“明了胜于晦涩(Explicit is better than implicit)”。
# 典型反例:极度难懂的三层嵌套推导式
matrix = [[[1, 2], [3, 4]], [[5, 6], [7, 8]]]
# 读者需要反复数括号才能理解其意图
flat = [x for sub1 in matrix for sub2 in sub1 for x in sub2 if x % 2 == 0]

# 正确做法:当逻辑超过两层过滤或变换时,拆分为结构清晰的生成器或命名函数
def extract_even_numbers(nested_matrix):
    for sub_grid in nested_matrix:
        for row in sub_grid:
            for item in row:
                if item % 2 == 0:
                    yield item

flat_clean = list(extract_even_numbers(matrix))
误区二:在迭代过程中直接修改可变容器
由于初学者缺乏对容器内部引用状态的理解,常常在用 for item in list: 循环的同时执行 list.remove(item)。因为Python迭代器内部记录的是当前位置索引,删除元素后后续元素会立即向前位移,导致部分元素被跳过而不被访问。地道的做法要么是通过推导式生成全新目标列表,要么使用过滤函数过滤。
误区三:默认参数使用可变对象(Mutable Default Arguments)
定义函数时如果写出 def append_to(element, target=[]):,该默认空列表只在函数定义被解释器加载的那一刻创建一次。所有未传参数的调用将永久共享这同一个列表对象。正确的思维是利用不可变对象作为哨兵值:def append_to(element, target=None): 并在函数内部判断 if target is None: target = []。
思维校验法则:每次写完一段Python代码,问自己两个问题:
1. 如果三个月后让另一个同事阅读这段代码,他能否在10秒内明白它的业务意图,而无需纸笔推导?
2. 是否将系统内置的数据结构特性(如 set 的 O(1) 查找)发挥到了极致,而不是手动编写低阶遍历?
六、Python程序设计思维核心维度全景总结
归纳而言,初学者理解并建立成熟的Python程序设计思维,可以归纳为以下四大关键维度的协同作用:
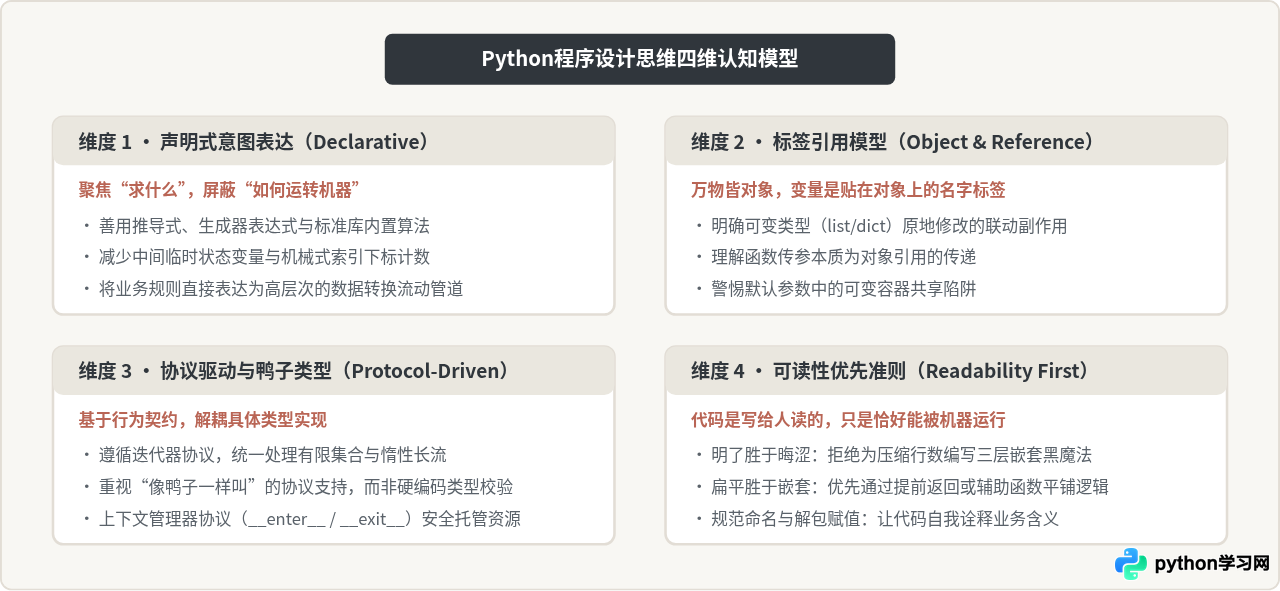
摆脱传统语法的惯性束缚,并不需要刻意死记硬背枯燥的语法细则。当你开始习惯于先思考“数据应该如何表示”,在遇到循环时自然联想到迭代协议与推导式,在处理状态时自觉警惕可变引用的副作用,并时刻把代码清晰度置于首位时,你就真正掌握了隐藏在Python简洁语法背后的程序设计思维。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









