

Python Elasticsearch 索引创建与数据写入全流程指南

发布时间:2026-10-13| 6人浏览过
本文详细介绍如何使用 Python 操作 Elasticsearch,涵盖从初始化客户端、创建带映射的索引、单条与批量数据写入(含自动生成 ID 与指定 ID),到数据的删除、单条查询、全量检索及关键词匹配查找的完整流程。文中特别指出了嵌套对象写入时的常见错误及修正方法,并提供相关代码示例供参考。
Python Elasticsearch 索引创建与数据写入全流程指南
Python Elasticsearch 从创建索引到写入数据的全过程
创建索引
创建索引
from elasticsearch import Elasticsearch
es = Elasticsearch('192.168.1.1:9200')
mappings = {
      "mappings": {
        "type_doc_test": {              #type_doc_test为doc_type
          "properties": {
            "id": {
              "type": "long",
              "index": "false"
            },
            "serial": {
              "type": "keyword", # keyword不会进行分词,text会分词
              "index": "false" # 不建索引
            },
            #tags可以存json格式,访问tags.content
            "tags": {
              "type": "object",
              "properties": {
                "content": {"type": "keyword", "index": True},
                "dominant_color_name": {"type": "keyword", "index": True},
                "skill": {"type": "keyword", "index": True},
              }
            },
            "hasTag": {
              "type": "long",
              "index": True
            },
            "status": {
              "type": "long",
              "index": True
            },
            "createTime": {
              "type": "date",
              "format": "yyyy-MM-dd HH:mm:ss||yyyy-MM-dd||epoch_millis"
            },
            "updateTime": {
              "type": "date",
              "format": "yyyy-MM-dd HH:mm:ss||yyyy-MM-dd||epoch_millis"
            }
          }
        }
      }
    }
res = es.indices.create(index = 'index_test',body =mappings)
通过上述代码即可完成 Elasticsearch 索引的创建。
单条数据写入
写入一条数据
写入数据时,必须严格遵循已创建的 Elasticsearch 索引类型所对应的数据结构规范。
from elasticsearch import Elasticsearch
es = Elasticsearch('192.168.1.1:9200')
action ={
       "id": "1111122222",
       "serial":"版本",
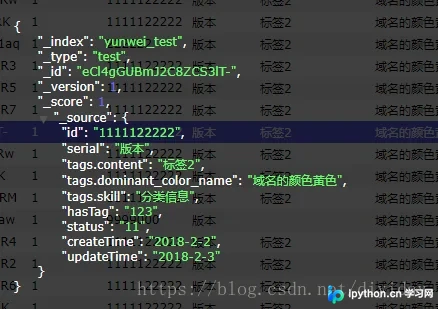
       #以下tags.content是错误的写法
       #"tags.content" :"标签2",
       #"tags.dominant_color_name": "域名的颜色黄色",
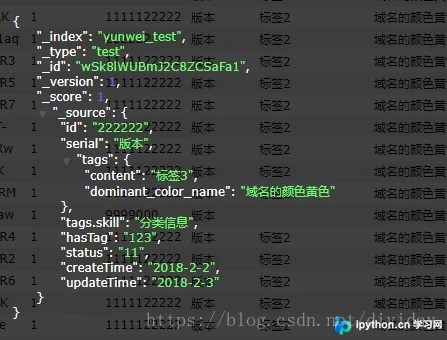
       #正确的写法如下:
       "tags":{"content":"标签3","dominant_color_name": "域名的颜色黄色"},
       #按照字典的格式写入,如果用上面的那种写法,会直接写成一个tags.content字段。
       #而不是在tags中content添加数据,这点需要注意
       "tags.skill":"分类信息",
       "hasTag":"123",
       "status":"11",
       "createTime" :"2018-2-2",
       "updateTime":"2018-2-3",
        }
es.index(index="index_test",doc_type="doc_type_test",body = action)
执行上述操作即可成功写入一条数据。
错误的写入方式示例
正确的写入方式示例
批量数据写入与 ID 管理
写入多条数据
from elasticsearch import Elasticsearch
from elasticsearch.helpers import bulk
es = Elasticsearch('192.168.1.1:9200')
ACTIONS = []
action1 ={
          "_index": "indes_test",
          "_type": "doc_type_test",
          "_id":"bSlegGUBmJ2C8ZCSC1R1",
          "_source":{
            "id": "1111122222",
            "serial":"版本",
            "tags.content" :"标签2",
            "tags.dominant_color_name": "域名的颜色黄色",
            "tags.skill":"分类信息",
            "hasTag":"123",
            "status":"11",
            "createTime" :"2018-2-2",
            "updateTime":"2018-2-3",
          }
        }
action2 ={
          "_index": "indes_test",
          "_type": "doc_type_test",
          "_id":"bSlegGUBmJ2C8ZCSC1R2",
          "_source":{
            "id": "1111122222",
            "serial":"版本",
            "tags.content" :"标签2",
            "tags.dominant_color_name": "域名的颜色黄色",
            "tags.skill":"分类信息",
            "hasTag":"123",
            "status":"11",
            "createTime" :"2018-2-2",
            "updateTime":"2018-2-3",
          }
        }
ACTIONS.append(action1)
ACTIONS.append(action2)
res,_ =bulk(es, ACTIONS, index="indes_test", raise_on_error=True)
print(res)
此方式允许手动指定文档 ID。若移除 "_id" 参数,系统将自动生成唯一 ID。具体实现如下:
action2 ={
          "_index": "indes_test",
          "_type": "doc_type_test",
          "_source":{
            "id": "1111122222",
            "serial":"版本",
            "tags.content" :"标签2",
            "tags.dominant_color_name": "域名的颜色黄色",
            "tags.skill":"分类信息",
            "hasTag":"123",
            "status":"11",
            "createTime" :"2018-2-2",
            "updateTime":"2018-2-3",
          }
        }
数据删除与查询操作
删除一条数据
from elasticsearch import Elasticsearch
es = Elasticsearch('192.168.1.1:9200')
res = es.delete(index="index_test",doc_type="doc_type_test", id ="bSlegGUBmJ2C8ZCSC1R1")
print(res)
只需替换对应的文档 ID 即可删除指定数据。
查询一条数据
from elasticsearch import Elasticsearch
es = Elasticsearch('192.168.1.1:9200')
res = es.get(index="index_test",doc_type="doc_type_test", id ="bSlegGUBmJ2C8ZCSC1R2")
print(res)
同样通过替换文档 ID 即可查询指定单条数据。
全量查询与关键词检索
查询所有数据
from elasticsearch import Elasticsearch

es = Elasticsearch('192.168.1.1:9200')

res = es.search(index="index_test",doc_type="doc_type_test")
print(res)
print(res['hits']['hits'])
通过解析响应中的 ['hits'] 参数,可以获取查询结果的详细信息。
根据关键词查找
from elasticsearch import Elasticsearch
es = Elasticsearch('192.168.1.1:9200')
doc = {
      "query": {
        "match": {
          "_id": "aSlZgGUBmJ2C8ZCSPVRO"
        }
      }
    }
res = es.search(index="index_test",doc_type="doc_type_test",body=doc)
print(res)
总结
以上即为 Python Elasticsearch 从创建索引到数据写入的完整操作流程,希望能对大家有所帮助。如有任何疑问,欢迎留言,小编会及时回复大家!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









