

Python异步写入Elasticsearch的实现方法与高并发优化

在海量数据采集、实时日志同步和高频业务指标落库等场景中,Python程序向Elasticsearch(简称ES)写入数据的速度往往成为系统的第一瓶颈。传统单条同步写入方式因为频繁的网络往返(RTT)与线程I/O阻塞,单核每秒往往仅能完成几百次操作。本文将讲解如何基于官方异步客户端AsyncElasticsearch与helpers.async_bulk构建批量写入流水线,并通过“有界队列缓冲+并发Worker池+自适应背压控制”的架构设计,解决吞吐不足、请求堆积以及ES集群触发429被拒绝写入等高并发核心问题。
一、同步写入瓶颈与异步架构优势
理解异步写入价值的前提,是看清传统同步调用在网络I/O密集型任务中的性能上限。在同步模式下,Python主线程每次调用es.index()发送文档时,都必须完整等待TCP握手、HTTP报文传输、ES服务端主分片处理、副本同步以及响应返回。在局域网内单次网络往返通常在2~10毫秒之间,这意味着即使ES服务端的写入计算只需0.5毫秒,单线程的理论吞吐上限也只能达到每秒100到500条左右。
异步写入的核心并非让ES更高效地写入磁盘,而是通过Python的asyncio事件循环实现网络I/O的多路复用:当一个批量HTTP请求被发送并等待集群响应时,当前协程主动挂起并让出CPU,事件循环继续调度下一个批次的组装与发送。结合批量操作接口_bulk,单次网络报文打包数千条文档,单条文档分摊的网络往返成本几乎降至零,从而将单机写入吞吐量提升5至20倍以上。
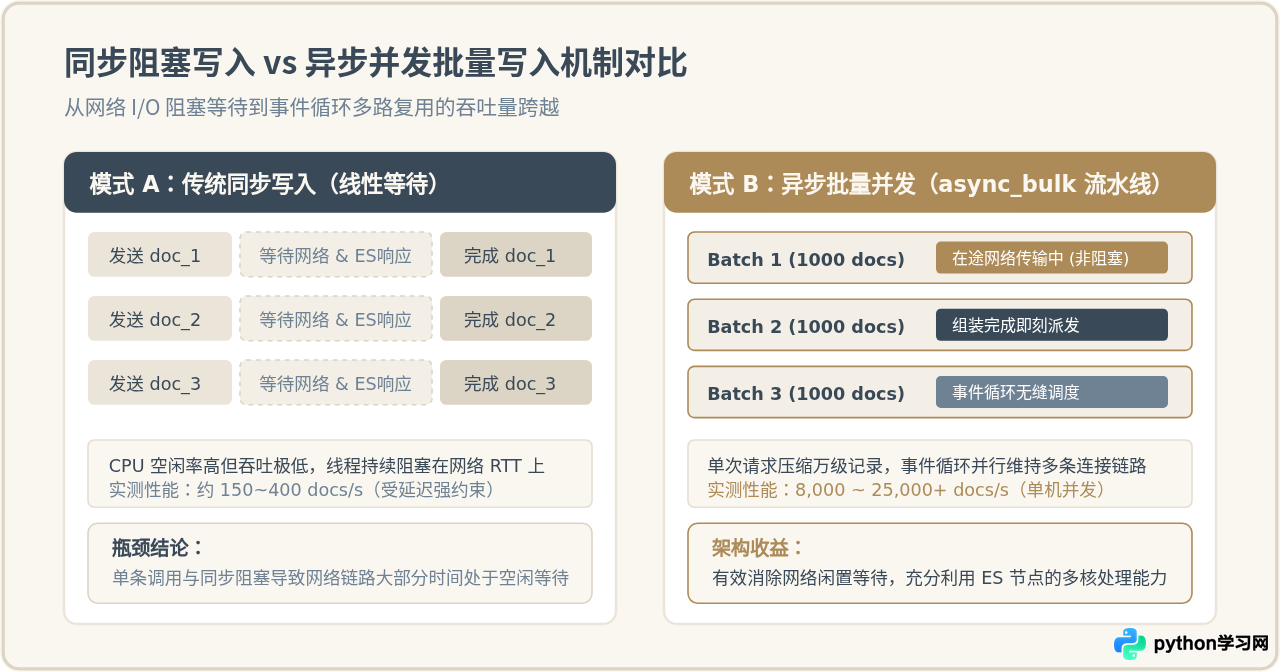
二、基础实现:使用官方异步客户端与 async_bulk
自 Elasticsearch 官方 8.x Python 客户端起,异步功能已原生集成在主包中。在安装客户端时,只需通过安装附加依赖支持异步 HTTP 引擎即可:
pip install "elasticsearch[async]>=8.10.0"在异步编程模型中,不要在循环体中执行 await es.index(...),因为这虽然是非阻塞的,但在逻辑上仍然是“发送一条、等待一条”的串行模式。官方推荐的标准做法是使用 elasticsearch.helpers.async_bulk,传入一个异步生成器(Async Generator)或包含操作动作的列表。
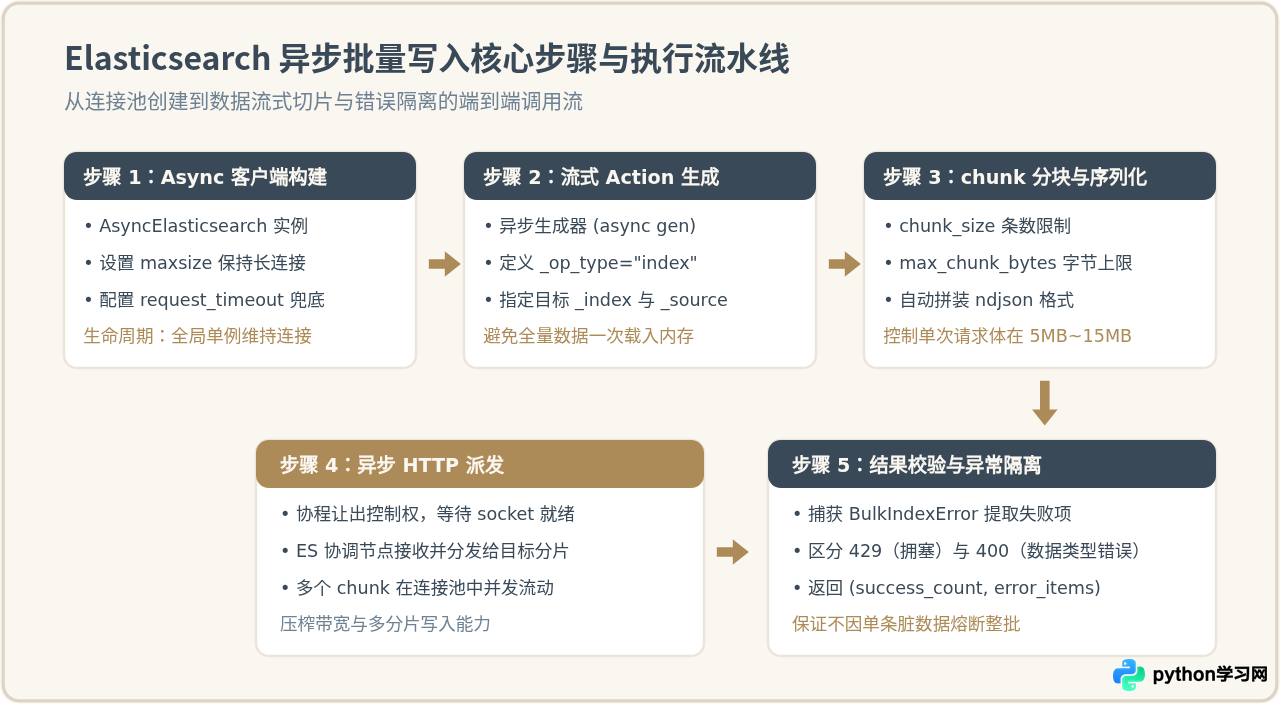
下面是一个结构完整的异步批量写入代码示例。展示了如何初始化带有合适连接池配置的异步客户端、利用异步生成器流式产出数据,并安全执行写入:
import asyncio
import time
from typing import AsyncGenerator, Dict, Any
from elasticsearch import AsyncElasticsearch
from elasticsearch.helpers import async_bulk, BulkIndexError

# 1. 初始化异步客户端,设置充足的连接池与超时时间
es_client = AsyncElasticsearch(
    hosts=["http://127.0.0.1:9200"],
    max_retries=3,
    retry_on_status=(429, 502, 503, 504),
    request_timeout=30.0,
    connections_per_node=30  # 单个节点的活跃连接数上限
)

# 2. 构造流式异步生成器,避免将数万条文档全部缓存在内存中
async def document_generator(total_count: int, index_name: str) -> AsyncGenerator[Dict[str, Any], None]:
    for i in range(total_count):
        yield {
            "_op_type": "index",
            "_index": index_name,
            "_id": f"doc_{i}",
            "_source": {
                "user_id": 1000 + (i % 50),
                "event_type": "click",
                "timestamp": int(time.time() * 1000),
                "payload": f"trace_data_{i}"
            }
        }
        # 模拟产生数据时的微小让渡(如读取网络或磁盘)
        if i % 1000 == 0:
            await asyncio.sleep(0)

# 3. 执行异步批量写入
async def run_async_bulk_ingestion():
    index_name = "user_behavior_logs"
    total_docs = 20000
    start_time = time.perf_counter()

    try:
        success_count, failed_items = await async_bulk(
            client=es_client,
            actions=document_generator(total_docs, index_name),
            chunk_size=2000,           # 每个 bulk 块的文档数
            max_chunk_bytes=10485760,  # 10MB 字节限制,超过则自动分块
            raise_on_error=False,      # 设为 False 允许提取失败的单个文档详情
            stats_only=False           # 返回具体成功数与失败列表
        )
        elapsed = time.perf_counter() - start_time
        print(f"写入完成: 成功 {success_count} 条, 失败 {len(failed_items)} 条, 耗时 {elapsed:.2f}s")
        print(f"平均吞吐量: {success_count / elapsed:.1f} docs/sec")

        if failed_items:
            print("部分文档写入失败,前3个错误原因:")
            for item in failed_items[:3]:
                print(item)

    except BulkIndexError as exc:
        print(f"发生未捕获的 Bulk 异常: 共 {len(exc.errors)} 条写入错误")
    finally:
        # 关闭客户端连接池,释放底层套接字资源
        await es_client.close()

if __name__ == "__main__":
    asyncio.run(run_async_bulk_ingestion())
三、高并发架构设计:队列缓冲与背压流控机制
在真实的业务系统中(例如 FastAPI 接收高并发数据上报或从 Kafka 高速消费),上游产生数据的速度极不稳定,可能短时间内产生数万并发。如果为每个产生的请求直接发起一个 async_bulk,会导致三个灾难性后果:
- 内存爆仓(OOM):大量协程并发启动并滞留在内存中,堆积的数据迅速消耗完主机物理内存。
- 连接池耗尽:同时并发成百上千个 HTTP 连接,超出
connections_per_node上限,引发频繁的连接等待超时错误。 - ES 拒绝服务(HTTP 429):Elasticsearch 每个节点的
write线程池队列默认长度通常仅为 10000。瞬时并发请求过猛,ES 队列排满,立即抛出es_rejected_execution_exception。
解决高并发写入的工业级方案是构建“有界队列(Bounded Queue)+ 消费 Worker 池 + 信号量并发限制”的流水线,并配合背压(Backpressure)机制。
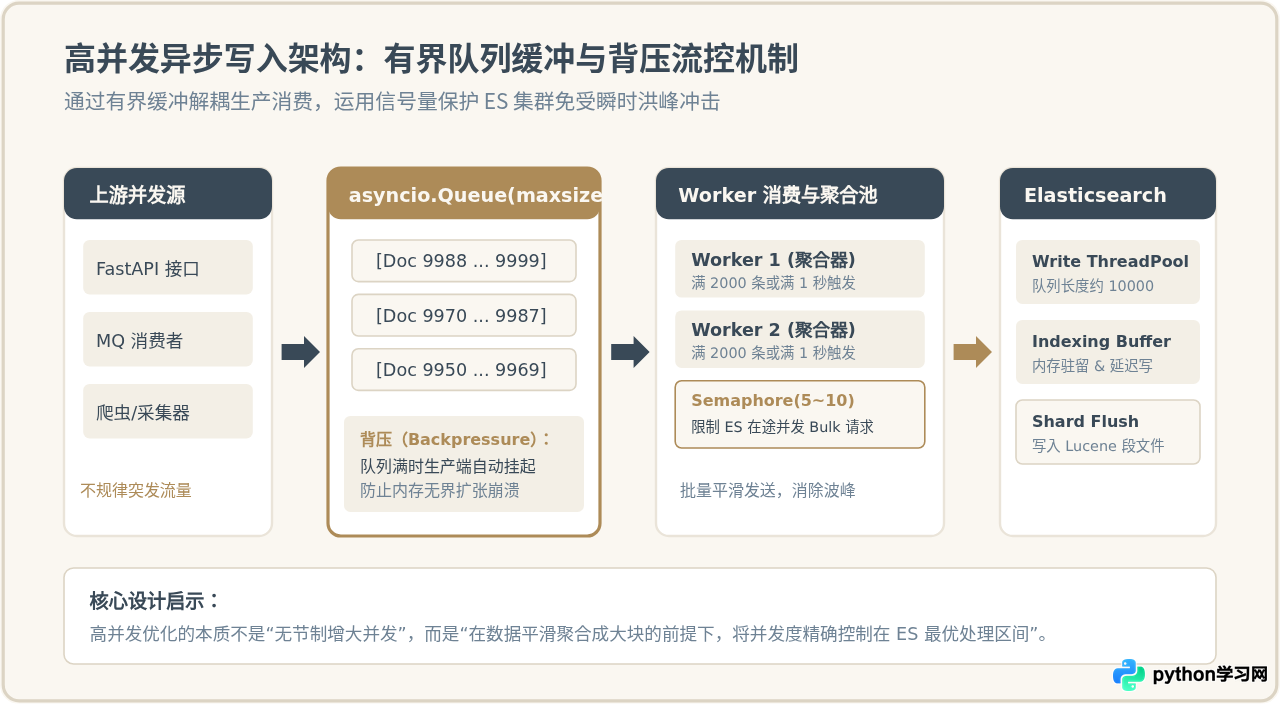
工业级实现:带超时聚合与并发限制的批处理管道
实现该架构的关键在于双重触发机制:文档累积达到批次上限(如 2000 条)立即触发写入;或者等待时间达到阈值(如 1.0 秒)即使未达到批次上限也强制刷新,保证数据的实时性与低延迟:
import asyncio
import time
from typing import List, Dict, Any
from elasticsearch import AsyncElasticsearch
from elasticsearch.helpers import async_bulk

class ElasticsearchAsyncWriter:
    def __init__(
        self,
        es_client: AsyncElasticsearch,
        index_name: str,
        queue_maxsize: int = 20000,
        batch_size: int = 2000,
        flush_interval: float = 1.0,
        max_concurrent_requests: int = 5
    ):
        self.es = es_client
        self.index_name = index_name
        self.queue: asyncio.Queue = asyncio.Queue(maxsize=queue_maxsize)
        self.batch_size = batch_size
        self.flush_interval = flush_interval
        self.semaphore = asyncio.Semaphore(max_concurrent_requests)
        self._running = False
        self._consumer_task = None

    async def start(self):
        """启动后台消费任务"""
        self._running = True
        self._consumer_task = asyncio.create_task(self._batch_dispatcher())

    async def put(self, doc: Dict[str, Any]):
        """
        生产端入口:当队列满时,await 会自动挂起上游生产者,产生背压
        """
        action = {
            "_op_type": "index",
            "_index": self.index_name,
            "_source": doc
        }
        await self.queue.put(action)

    async def _batch_dispatcher(self):
        """聚合分派器:在 batch_size 与 flush_interval 之间取得平衡"""
        current_batch: List[Dict[str, Any]] = []
        last_flush_time = time.monotonic()

        while self._running or not self.queue.empty():
            timeout = max(0.05, self.flush_interval - (time.monotonic() - last_flush_time))
            try:
                item = await asyncio.wait_for(self.queue.get(), timeout=timeout)
                current_batch.append(item)
                self.queue.task_done()
            except asyncio.TimeoutError:
                pass  # 等待超时,进入下方判断决定是否刷写

            # 触发写入条件:达到批次阈值 或 达到时间阈值
            now = time.monotonic()
            should_flush = (
                len(current_batch) >= self.batch_size or
                (len(current_batch) > 0 and (now - last_flush_time) >= self.flush_interval)
            )

            if should_flush:
                batch_to_send = current_batch
                current_batch = []
                last_flush_time = now
                # 使用信号量限制并发,异步派发写入,不阻塞主循环接收新数据
                asyncio.create_task(self._send_bulk_with_semaphore(batch_to_send))

        # 处理退出前残留的尾部数据
        if current_batch:
            await self._send_bulk_with_semaphore(current_batch)

    async def _send_bulk_with_semaphore(self, batch: List[Dict[str, Any]]):
        async with self.semaphore:
            retry_count = 0
            max_retries = 3
            current_actions = batch

            while current_actions and retry_count <= max_retries:
                try:
                    success, errors = await async_bulk(
                        client=self.es,
                        actions=current_actions,
                        raise_on_error=False,
                        stats_only=False
                    )
                    if not errors:
                        return

                    # 针对 429 拥塞错误执行指数避让并提取重试
                    retry_actions = []
                    for err in errors:
                        status = err.get("index", {}).get("status", 0)
                        if status == 429:
                            # 提取由于 ES 队列溢出而被拒绝的数据准备重试
                            failed_id = err["index"].get("_id")
                            matched = [a for a in current_actions if a.get("_id") == failed_id]
                            if matched:
                                retry_actions.append(matched[0])

                    if retry_actions and retry_count < max_retries:
                        retry_count += 1
                        backoff_time = (2 ** retry_count) * 0.5
                        await asyncio.sleep(backoff_time)
                        current_actions = retry_actions
                    else:
                        break
                except Exception as exc:
                    print(f"写入批次发生异常: {exc}")
                    break

    async def close(self):
        """平滑关闭:等待剩余队列全部落盘"""
        self._running = False
        await self.queue.join()
        if self._consumer_task:
            await self._consumer_task
四、高并发调优:连接池、网络层与ES服务端配置
仅优化 Python 端代码还不足以榨干系统性能。要达到数万到数十万每秒的稳定写入吞吐,需要完成客户端连接层与 Elasticsearch 集群服务端的全链路协同调优。
1. Python 客户端与网络层核心调优
- 连接池大小(connections_per_node / maxsize):默认的连接池容量往往只有 10。如果设置了 15 个并发 Worker,多余的协程将因等待可用 HTTP 连接而出现排队。建议将连接池大小设置为并发 Worker 数的 1.5 倍(例如设置为 30~50)。
- 批次容量折中(chunk_size 与 max_chunk_bytes):文档数量过多可能超出 HTTP 请求包限制,过少则浪费网络往返。经验推荐每个批次包含 2,000 到 5,000 个中等大小文档,总请求体维持在 5MB 到 15MB 之间。
- 429 拥塞退避算法:在 ES 节点压力过大时,直接抛弃数据或死循环重试都会导致集群雪崩。必须采用“指数退避(Exponential Backoff)+ 适度随机抖动(Jitter)”,并在重试时缩减当前批次大小。
2. Elasticsearch 索引服务端调优
对于批量数据导入或高并发日志摄取,可以通过临时调整索引元数据设置,大幅降低磁盘 I/O 开销:
| 配置项名称 | 生产默认值 | 高并发写入优化推荐值 | 优化原因与原理分析 |
|---|---|---|---|
index.refresh_interval |
1s |
30s 或 -1(批量导入期) |
每次刷新都会生成新的 Lucene 段并产生段合并开销。延长刷新时间或导入期间彻底关闭,可大幅减少 CPU 与磁盘 I/O。 |
index.number_of_replicas |
1 |
0(大批量初始导入期) |
主分片写入时会同步转发给所有副本分片。导入期间临时关闭副本,导入完成后恢复,可减少一半以上的网络与写入负荷。 |
index.translog.durability |
request |
async |
默认每次写请求都会执行 fsync 落盘事务日志。设为 async 后每 5 秒或满 512MB 异步落盘,吞吐量提升显著。 |
index.translog.sync_interval |
5s |
30s |
配合 async 使用,拉长事务日志的同步落盘间隔。 |
注意边界与数据安全性:将 translog.durability 设为 async 以及临时将 number_of_replicas 设为 0 属于“性能优先”配置。如果在导入过程中发生节点断电或宕机,最近数秒内未刷盘的数据存在丢失风险。在数据导入完成、进入日常查询阶段后,必须将副本数与刷新间隔恢复为正常值。
五、全链路调优体系与落地实践总结
构建高吞吐 Python 异步写入 Elasticsearch 方案,核心在于打通“上游背压缓冲、事件循环异步打包、集群平滑承载”三个层级。下方的调优体系图清晰归纳了各层级的核心参数与调优手段:
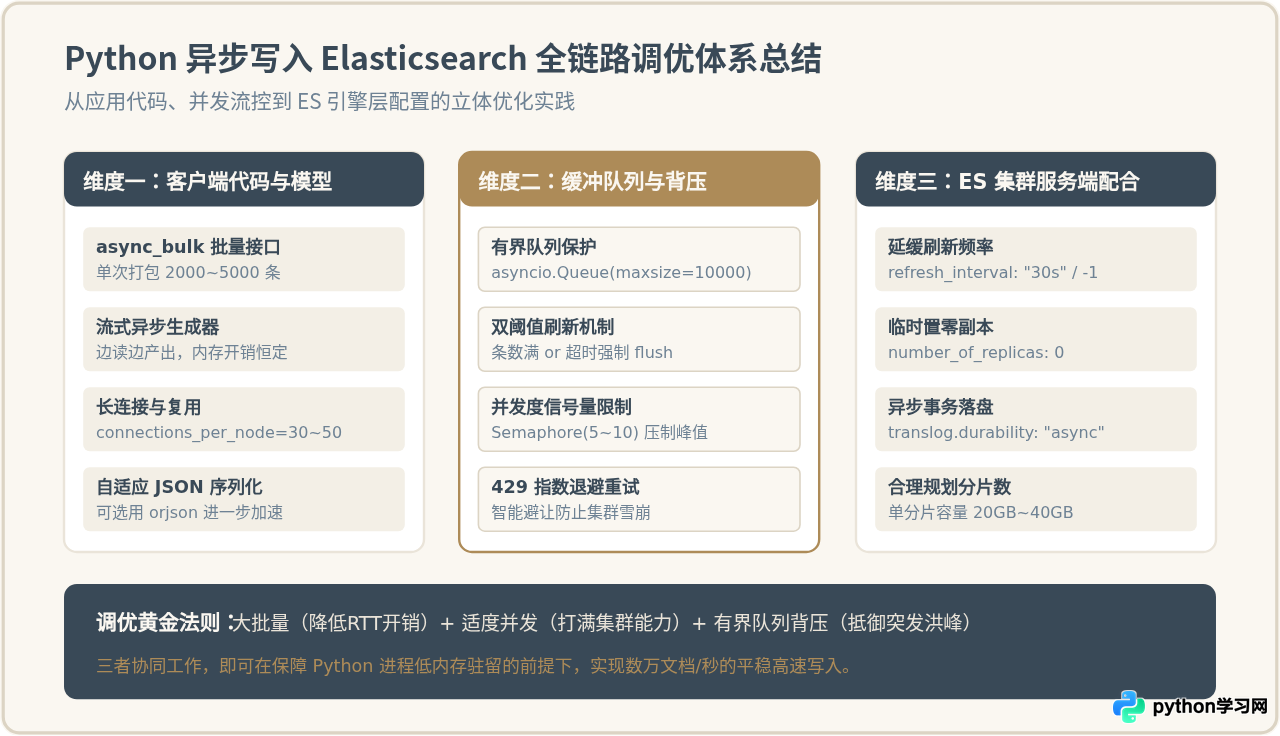
通过本文介绍的方法,从基础的 async_bulk 流式写入起步,结合生产级队列缓冲、信号量背压和 ES 服务端参数调优,读者可以在高并发、海量数据落库的场景下,构建起高稳定、高吞吐的工业级数据写入流水线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









