

Python怎么调整模糊匹配的阈值以减少误判
详细讲解在Python中如何科学调整模糊匹配阈值以降低误判率,包括测试集构建、算法选型、步进阈值扫描、双阈值策略及二次规则校验的完整实战方案。
在数据清洗、实体对齐或搜索纠错等场景中,Python模糊匹配(如使用 RapidFuzz 或 FuzzyWuzzy)常因阈值设置不当而将无关文本强行关联。要减少误判,核心解决路径不是盲目将固定阈值从 70 调到 90,而是建立“基准样本评测—匹配算法匹配—双阈值拦截—二次特征过滤”的确定性工程链条。本文将逐步讲解如何通过严谨的测试与规则组合,将模糊匹配的误判率降至最低。
一、误判产生的核心原因与阈值权衡困境
模糊匹配工具的打分逻辑大多基于编辑距离(Levenshtein Distance)或公有词重合度。很多开发者在初次接入时,习惯设定一个单一的硬编码分值(例如 threshold = 75),但随即会遇到两类严重误判:
- 短字符串虚高现象:由于字符基数小,两个完全无关的短词(如“海信”与“海澜”)可能因共享一个字而得出 50% 甚至更高的相似度。
- 包含型长短失衡:使用部分匹配(如
partial_ratio)时,“小米”与“小米生态链智能电热毯说明书”的匹配度往往接近 100 分,这在商品类目归一化时会产生大量越级误判。 - 词序颠倒与虚词干扰:未清洗的停用词或词序差异,会导致真正相关的文本分值被稀释,而无关但结构相似的文本分值居高不下。
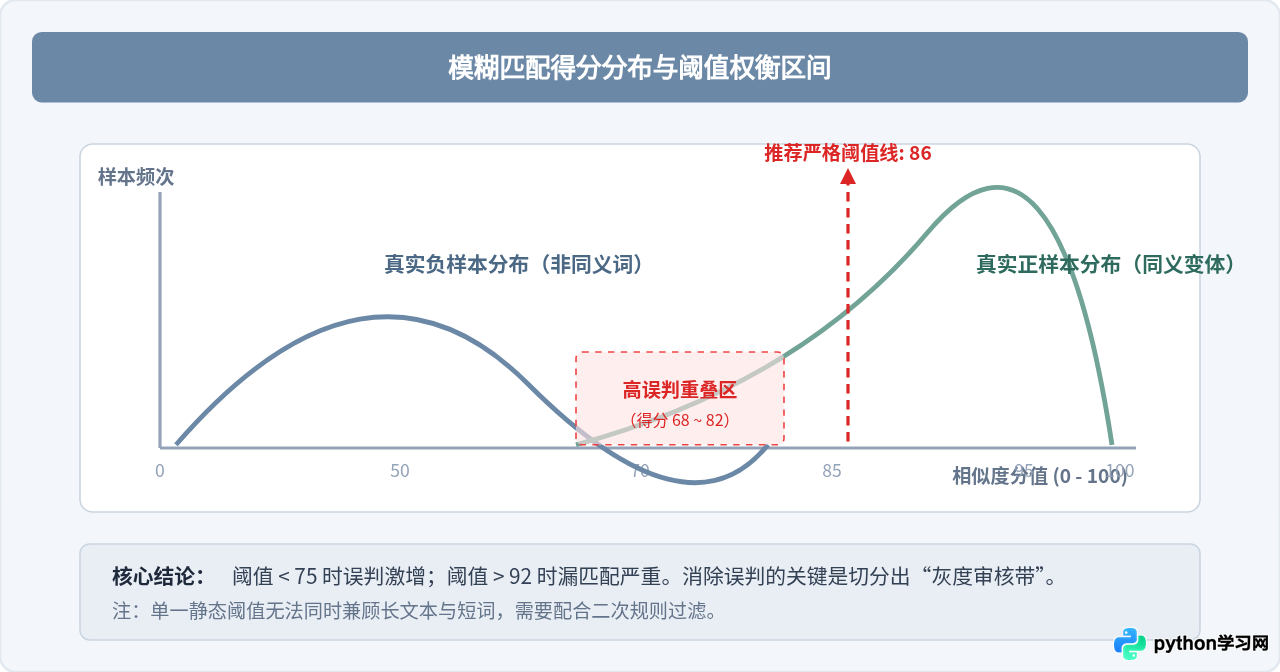
调高阈值虽然能立竿见影地抑制误判(提升精确率 Precision),但代价是漏掉大量合法变体(降低召回率 Recall)。两者的平衡分布如下图所示:
二、减少误判的标准化操作步骤
要摆脱凭感觉拍脑袋定阈值的做法,建议按照下列五个步骤系统化调优:
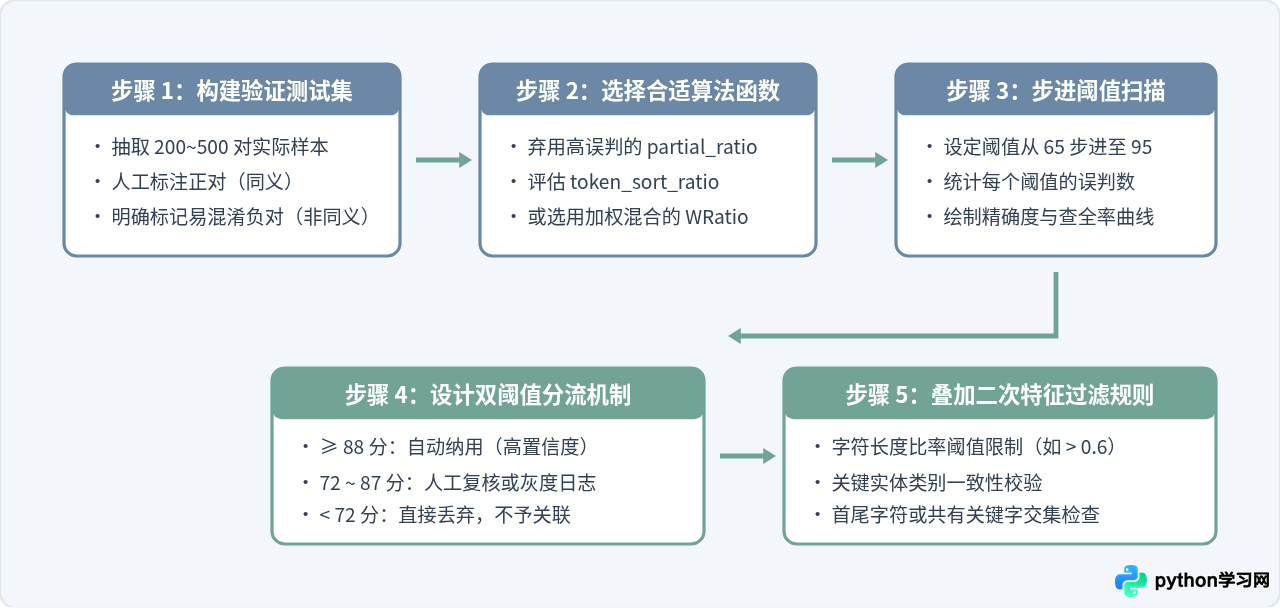
准备测试集与基准数据
不要在未量化的情况下直接修改生产环境阈值。首先从业务日志中整理一份包含正样本与负样本的对照清单,结构形如:(query, candidate, is_true_match)。负样本应特别挑选那些容易被误判但实际不相等的案例(例如“华为智慧屏”与“华为智能手环”)。
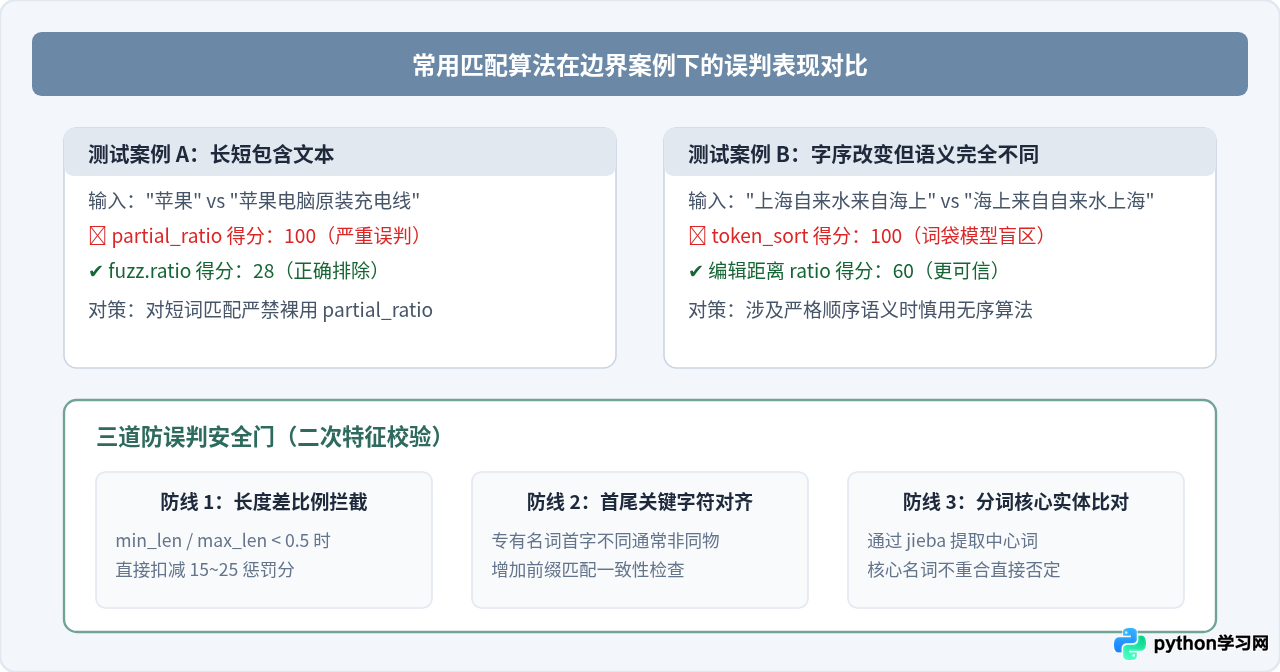
三、核心算法选型与误判对比
选用不同的匹配算法,所需要的阈值基准完全不同。以现代高性能库 rapidfuzz 为例,常见的 scorer 包括:
| 算法函数 | 底层原理 | 误判高发场景 | 推荐基础阈值 |
|---|---|---|---|
fuzz.ratio |
标准编辑距离计算 | 字数差异大时分值骤降;对字词颠倒极其敏感 | 75 ~ 82 |
fuzz.partial_ratio |
寻找短串在长串中的最佳局部匹配 | 误判率极高。短词只要被包含即得100分 | 慎用(需限制长度比) |
fuzz.token_sort_ratio |
先按空格/分词重排,再计算编辑距离 | 对调序容忍度高,但短文本中调序可能改变词义 | 82 ~ 88 |
fuzz.WRatio |
根据长度、重合度加权综合评分 | 综合表现好,但在部分边缘文本上分数虚高 | 85 ~ 90 |
四、完整的 Python 阈值调优代码实现
下面是一个完整的自动化评估与多重校验工程示例。使用现代 rapidfuzz 库执行高效匹配,并包含阈值步进评估与带守卫规则的安全匹配器。
1. 依赖安装
pip install rapidfuzz2. 编写步进阈值评估脚本
该脚本通过扫描 60 到 95 的阈值,统计每个阈值下的精确率(Precision)和误判样本数,帮助找到业务上最具性价比的临界点:
from rapidfuzz import fuzz

# 构建带真实标签的测试集 (query, target, is_match)
test_dataset = [
    ("苹果14 Pro", "iPhone 14 Pro", True),
    ("华为Mate60", "华为 Mate 60", True),
    ("腾讯视频VIP", "腾讯会议VIP", False),  # 典型易误判对
    ("海尔洗衣机", "海尔电冰箱", False),   # 共有品牌名,但品类完全不同
    ("美的空调遥控器", "美的空调", False), # 包含关系但实体不一致
    ("Python编程基础", "Python编程从入门到精通", True),
    ("小米手环8", "小米手表S3", False),
    ("联想小新Pro16", "联想小新 16", True),
]

def evaluate_thresholds(dataset, min_th=60, max_th=95, step=5):
    print(f"{'阈值':<6} | {'精确率 (Precision)':<18} | {'召回率 (Recall)':<16} | {'误判数':<8}")
    print("-" * 56)

    for th in range(min_th, max_th + 1, step):
        tp = 0  # 判定正确且实际为正
        fp = 0  # 误判:判定为正但实际为负
        fn = 0  # 漏判:判定为负但实际为正

        for q, t, ground_truth in dataset:
            # 使用 WRatio 进行相似度打分
            score = fuzz.WRatio(q, t)
            predicted_positive = score >= th

            if predicted_positive and ground_truth:
                tp += 1
            elif predicted_positive and not ground_truth:
                fp += 1
            elif not predicted_positive and ground_truth:
                fn += 1

        precision = tp / (tp + fp) if (tp + fp) > 0 else 1.0
        recall = tp / (tp + fn) if (tp + fn) > 0 else 0.0
        print(f"{th:<8} | {precision * 100:>6.2f}%{'':<11} | {recall * 100:>6.2f}%{'':<9} | {fp:<8}")

evaluate_thresholds(test_dataset)
3. 封装带二次防御的生产级匹配器
在实际生产调用中,不单单依赖纯数学相似度,而是采用“基础分 + 长度防御 + 前缀对齐 + 双阈值”的安全策略:
from rapidfuzz import fuzz

class SafeFuzzyMatcher:
    def __init__(self, high_threshold=88.0, low_threshold=72.0, min_len_ratio=0.5):
        """
        :param high_threshold: 高于此分值且通过二次规则,直接采纳
        :param low_threshold: 低于此分值直接丢弃
        :param min_len_ratio: 两字符串最小长度与最大长度的比值下限
        """
        self.high_threshold = high_threshold
        self.low_threshold = low_threshold
        self.min_len_ratio = min_len_ratio

    def match(self, s1: str, s2: str) -> dict:
        s1, s2 = s1.strip(), s2.strip()

        # 1. 基础相似度打分 (使用 WRatio 兼顾大小写与空格)
        raw_score = fuzz.WRatio(s1, s2)

        # 低于灰度门槛,立即淘汰
        if raw_score < self.low_threshold:
            return {"status": "REJECT", "score": raw_score, "reason": "Score below low threshold"}

        # 2. 二次规则检查 A:长度比异常惩罚
        len1, len2 = len(s1), len(s2)
        ratio = min(len1, len2) / max(len1, len2)
        adjusted_score = raw_score

        if ratio < self.min_len_ratio:
            # 长度悬殊(如短词包含进长句),扣减惩罚分
            adjusted_score -= 20.0

        # 3. 二次规则检查 B:首字排他性检查(针对常见专有名词)
        if len1 > 1 and len2 > 1 and s1[0] != s2[0]:
            # 首字不同在品牌/品类匹配中误判概率极高
            adjusted_score -= 10.0

        # 4. 双阈值最终裁决
        if adjusted_score >= self.high_threshold:
            decision = "ACCEPT"
        elif adjusted_score >= self.low_threshold:
            decision = "REVIEW"  # 灰度审核区间,记录日志或交由人工判断
        else:
            decision = "REJECT"

        return {
            "status": decision,
            "raw_score": raw_score,
            "adjusted_score": max(0.0, adjusted_score),
            "len_ratio": round(ratio, 2)
        }

# 使用示例
matcher = SafeFuzzyMatcher()
result_a = matcher.match("美的空调遥控器", "美的空调")
result_b = matcher.match("Python教程基础", "Python基础教程")
print("案例 A(长短词易误判):", result_a)
print("案例 B(调序同义词):", result_b)
REVIEW 状态的样本定期导出为灰度报表。如果发现大量 REVIEW 样本是正确匹配,说明高阈值设定过紧,可下调 2~3 分;若发现 ACCEPT 存在误判,应优先增加二次校验规则,而不是单纯无限拔高阈值。
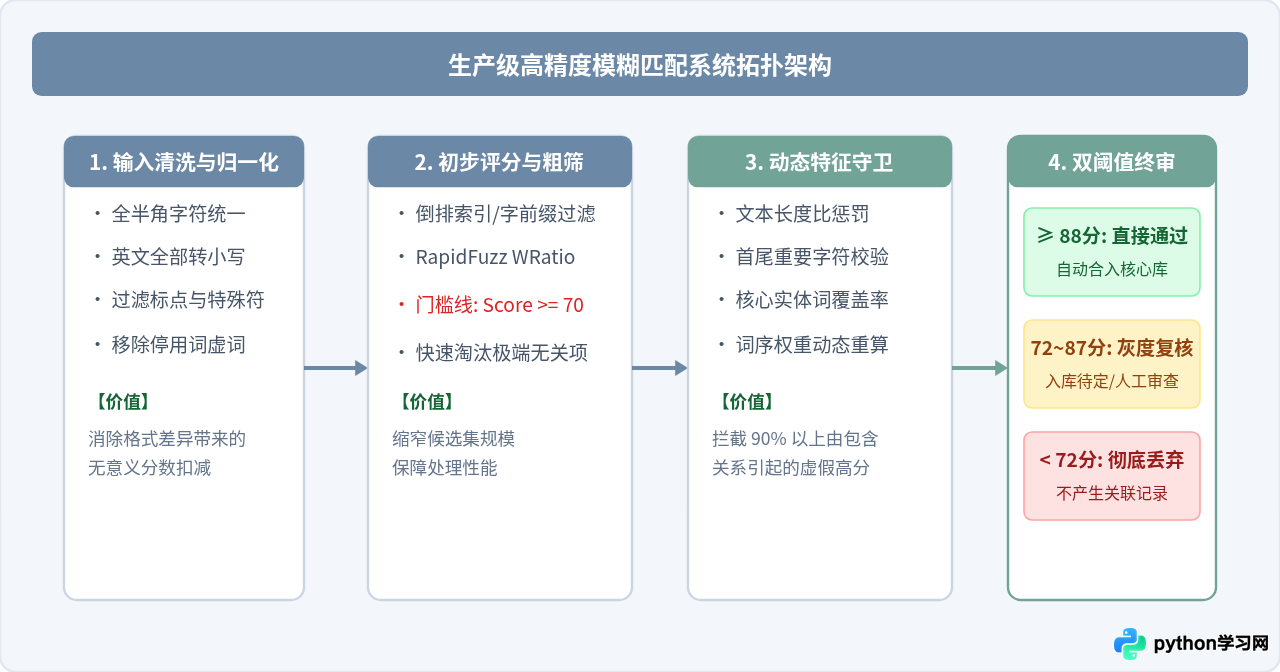
五、抗误判模糊匹配架构全景总结
要从根本上消除误判,必须将阈值调整视为一个动态、分层的系统工程,而非一个简单的常量赋值。下图展示了工业级低误判模糊匹配流水线的标准拓扑结构:
六、总结与落地建议
调整 Python 模糊匹配阈值的终极目标是在“准确度”与“覆盖率”之间找到业务可接受的最佳平衡点。在具体工程落地时,请牢记以下三项原则:
- 不要使用全局单一阈值:不同业务字段(如人名、公司名、商品标题)的字长差异极大,务必按字段类型独立配置阈值。短字符串(如人名)需强制要求 90 分以上且长度完全一致;而长文本描述可放宽至 80~85 分。
- 优先使用现代替代库:优先使用 C++ 实现的
rapidfuzz替代较早的fuzzywuzzy,不仅性能提升数倍至数十倍,还提供了更为丰富的距离算法与参数微调选项。 - 把不确定的中间层留给灰度:将单一分割线变为“高通过阈值”与“低淘汰阈值”组成的带状区间。灰度带内的数据不进行不可逆的自动处理,而是沉淀日志,利用真实样本反哺规则迭代。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









