

Python字典和列表有什么区别:何时选择哪种结构
深入对比Python列表(List)与字典(Dict)的核心机制、底层存储、查找性能及实际选型策略,通过图文并茂的分析与完整代码示例,帮助开发者精准选择合适的数据结构。
核心结论:列表(List)是有序的元素序列,通过从0开始的正整数位置索引访问,适用于保存具有先后次序、允许重复或需要切片处理的数据集合;字典(Dict)则是键值对(Key-Value)映射,通过唯一的键(Key)直接检索对应的值(Value),适用于依据名称、编号等业务标识符进行常数级快速查找的场景。
一、直观认知:内存形态与数据组织差异
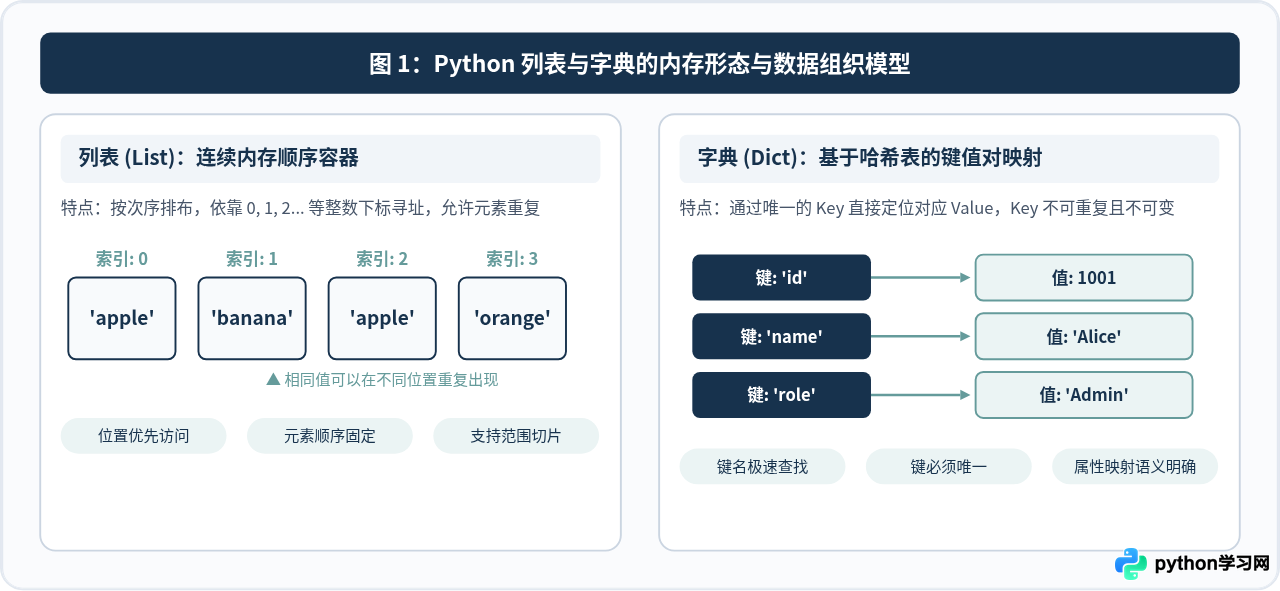
在编写Python程序时,列表与字典是使用频率最高的两种内置复合数据类型。理解两者差异的第一步,是看它们如何组织与存储数据:
- 列表(List)以“物理位置”为中心:每个元素被存储在一个连续的内存指针数组中。你不需要关心元素本身是什么,只需要知道它排在第几个(索引从
0到n-1)。列表中可以容纳任意类型的数据,也完全允许存在内容完全相同的重复元素。 - 字典(Dict)以“语义映射”为中心:数据成对出现,即每个数据项都由一个
键(Key)和一个值(Value)绑定而成。查找数据时不再靠排位,而是凭借指定的键。字典中的键必须具有唯一性且必须是不可变对象(可哈希),而对应的值可以随意修改且不限制类型。
二、底层机理与检索性能:O(n) 与 O(1) 的本质鸿沟
很多开发者在刚学Python时容易产生一个疑问:既然列表也可以存放对象,为什么还要专门设计字典?答案藏在底层实现与检索的时间复杂度中。
1. 列表的查找逻辑(线性搜索)
当执行 item in my_list 或 my_list.index(item) 时,Python 底层必须从索引 0 开始,逐个拿出元素与目标值进行 == 等值比较。如果目标位于列表末尾或根本不存在,Python 必须完整遍历包含全部 $n$ 个元素的数组。因此,列表按值查找的时间复杂度为 $O(n)$。
2. 字典的查找逻辑(哈希寻址)
当执行 key in my_dict 或 my_dict[key] 时,Python 首先对键调用内部哈希函数 hash(key),计算出一个整数哈希值。该哈希值通过掩码运算直接折算为哈希表底层的槽位(Slot)地址,瞬间命中并返回关联的值,完全不需要依次比对其他键。因此,字典查找的平均时间复杂度为 $O(1)$(常数阶)。
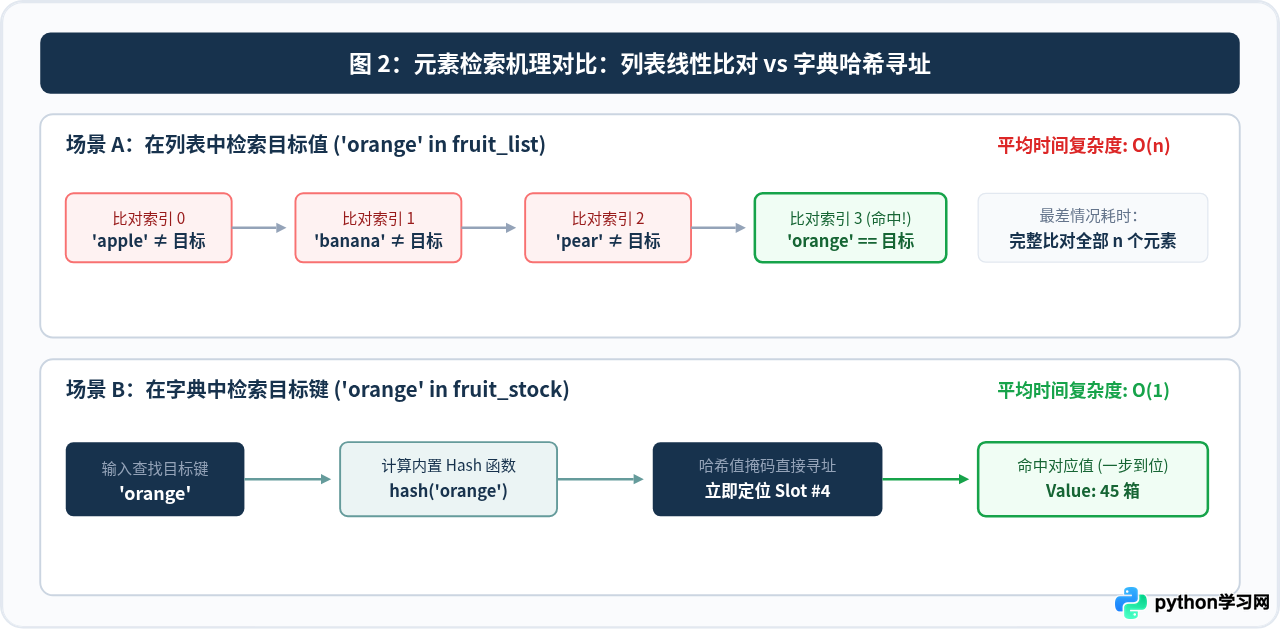
val in list 进行一次不存在值的检索,需进行 100,000 次等值比较;而使用 key in dict 仅需计算一次哈希即可得出结论。随着数据规模的膨胀,两者的耗时差距可达数百甚至数千倍。
三、核心语法与常用操作对照
为了让差异更具可操作性,我们将日常开发中最核心的数据增、删、改、查语法进行对照:
# 1. 初始化定义
user_list = ["Alice", "Bob", "Charlie"]           # 列表:方括号,单元素
user_dict = {"id": 101, "name": "Alice", "age": 28} # 字典:花括号,键值对

# 2. 访问与检索
first_user = user_list[0]         # 列表:依据整数位置访问 -> 'Alice'
user_name = user_dict["name"]     # 字典:依据键名访问 -> 'Alice'
user_city = user_dict.get("city", "未知") # 字典支持安全读取,避免 KeyError

# 3. 添加与修改
user_list.append("David")         # 列表:末尾追加元素
user_list[0] = "Alicia"           # 列表:更新指定索引处的值
user_dict["email"] = "a@test.com" # 字典:键不存在则新增键值对
user_dict["age"] = 29             # 字典:键已存在则更新对应的值

# 4. 成员存在性检查 (核心性能差异点)
if "Alice" in user_list:          # 遍历比对,数据大时耗时 O(n)
    print("列表中存在该用户")

if "name" in user_dict:           # 哈希计算,毫秒级恒定 O(1)
    print("字典中包含 name 键")

# 5. 遍历方式
for item in user_list:            # 列表直接迭代出元素
    print(item)

for k, v in user_dict.items():    # 字典通常遍历 .items() 获取键值对
    print(f"{k}: {v}")
四、选型判定流程:何时选列表?何时选字典?
在实际编码中,很多场景看似两者都能勉强解决问题,但选错了会导致代码臃肿甚至遭遇严重的性能瓶颈。你可以依照以下四个清晰的判断步骤来做出决策:
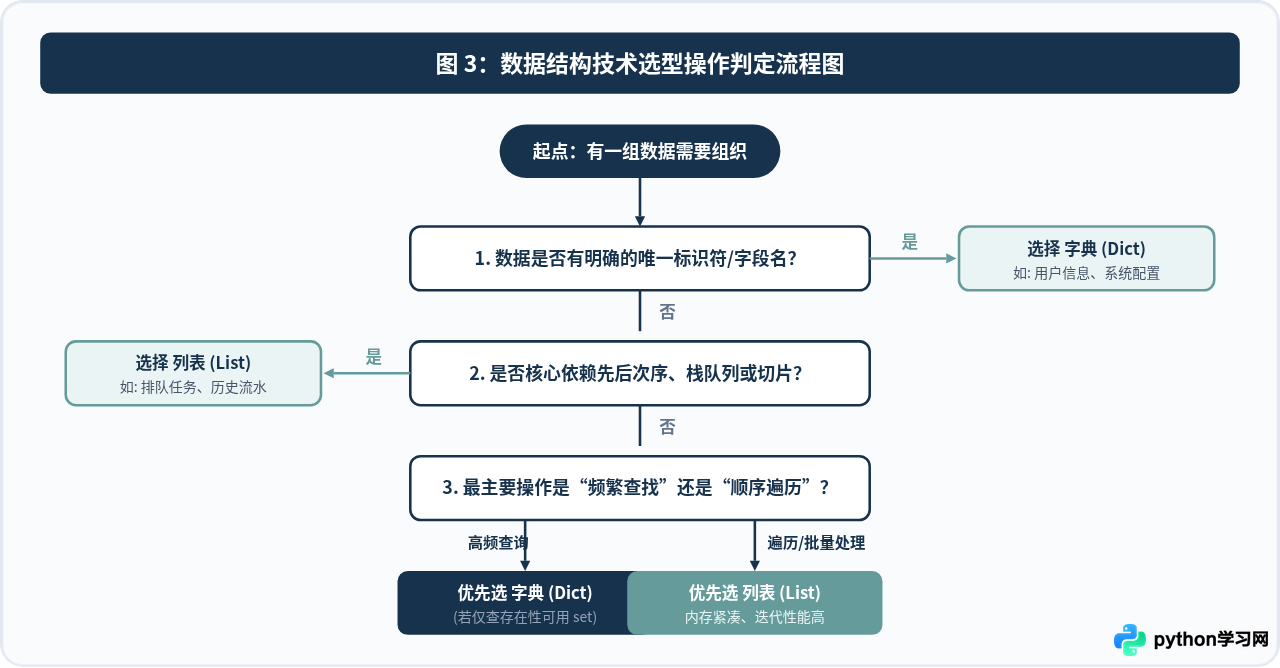
1. 毫不犹豫选择“列表(List)”的典型场景
- 时间或逻辑上有严格先后次序:例如事件流水日志、待执行的批处理任务队列、浏览器的历史后退栈。列表能完全保留你写入的顺序,并支持反转
.reverse()或重新排序.sort()。 - 需要频繁使用切片(Slicing):列表原生支持
items[0:10](取前10项)、items[-5:](取最后5项)或items[::2](步长取样),字典不具备连续切片能力。 - 数据是同构集合,且可能存在相同项:例如记录某传感器每秒采集的温度读数
[22.4, 22.5, 22.4, 22.8],数值相同完全合法,且依赖顺序区分时间点。
2. 毫不犹豫选择“字典(Dict)”的典型场景
- 数据呈现明显的“属性-内容”对应关系:例如保存一份用户的基本信息。如果用列表
["Alice", 28, "admin"],读取时必须死记user[1]代表年龄,容易写出难以维护的“硬编码索引”;而使用字典{"name": "Alice", "age": 28, "role": "admin"},代码语义一目了然。 - 需要按名称或ID极速检索:例如根据商品SKU查找价格、根据IP地址查找黑名单状态、建立本地缓存映射等。无论字典中存储了多少条记录,依据键查找都近乎瞬时完成。
- 稀疏数据的统计计数:例如统计文章中每个英文单词出现的频次。以单词为键,计数值为对应的值,能够极其便利地进行动态累加。
五、工程实践:列表与字典的复合协作
在真实的软件开发中,列表和字典并不是相互排斥的单选题,而是经常协同构建复杂的数据结构:
模式 1:列表内嵌套字典(记录集模式)
这是现代 Web API 和数据库查询结果中最标准的数据形态。外层列表保证记录的排列顺序,内层字典负责清晰刻画单条记录的每个属性:
# 示例:符合规范的用户列表(外层列表保序,内层字典提供清晰字段)
users_table = [
    {"user_id": 1001, "username": "alice", "status": "active"},
    {"user_id": 1002, "username": "bob", "status": "suspended"},
    {"user_id": 1003, "username": "charlie", "status": "active"}
]

# 业务处理:按顺序遍历并筛选
active_users = [u["username"] for u in users_table if u["status"] == "active"]
# 示例输出: ['alice', 'charlie']
模式 2:字典内嵌套列表(分类聚合模式)
当需要按照某个标签或维度对多条流水进行分类汇总时,通常使用字典作为分类索引,以列表容纳归属该类的所有元素:
# 示例:电商分类商品清单
category_catalog = {
    "electronics": ["Laptop", "Smartphone", "Headphones"],
    "books": ["Python Fluent", "Clean Code"],
    "clothing": ["T-Shirt", "Jacket"]
}

# 业务处理:向特定分类下动态追加新项
category_catalog["books"].append("Refactoring")
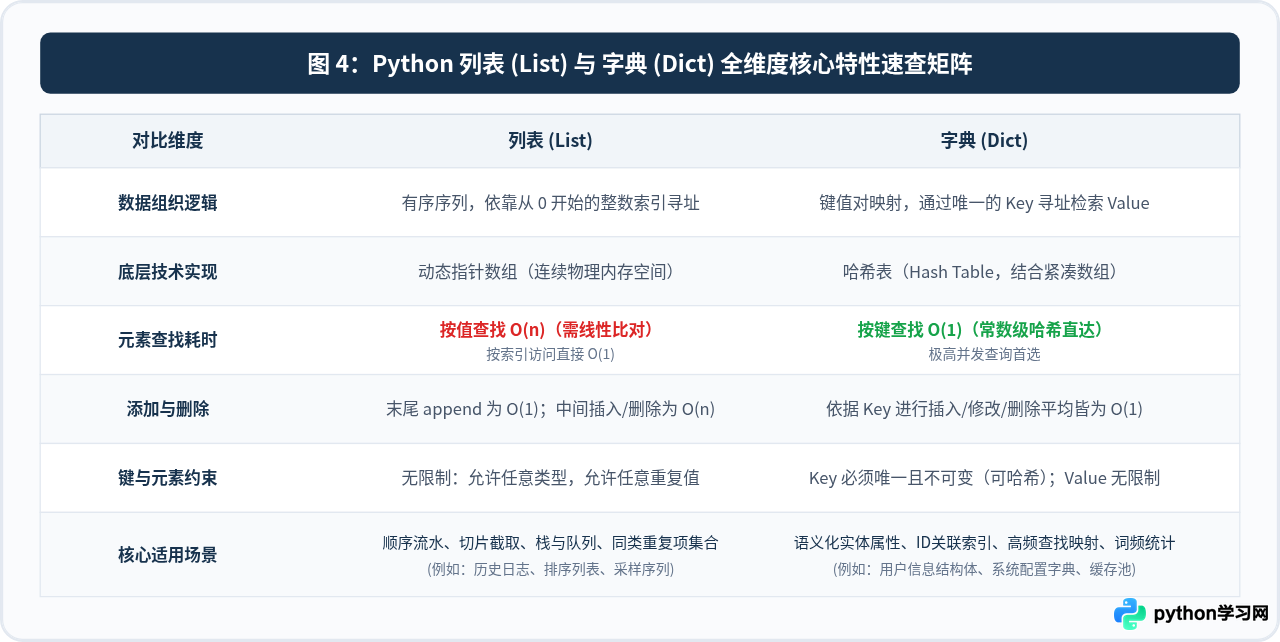
六、全维度对比总结矩阵
以下将列表与字典在底层机制、时间复杂度、约束条件及典型应用上的核心差异梳理为对照速查表:
常见误区与避坑建议
- 误区一:把大列表当成“查找表”使用。如果在几十万规模的列表中频繁执行
if target in big_list:,程序往往会变得极慢。此时应根据需求转为dict(若需绑定附加数据)或set(若仅需判断是否存在)。 - 误区二:使用可变对象充当字典的键。Python 字典的键必须可哈希,因此列表、集合或另一个字典绝不能直接作为键(会抛出
TypeError: unhashable type: 'list')。如果确实需要由多个值组合成符合键,请使用不可变的元组(Tuple)。 - 误区三:用无语义的索引代替字段名。在表达一个具有多个固定属性的实体时(例如商品名、单价、库存),不要为了省事使用
[name, price, stock]列表,这会让调用方的item[1]极难阅读;请优先使用字典{"name": name, "price": price, "stock": stock},或者更进一步使用dataclass。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









