

Python类型转换内置函数解析:int、str、list与dict的正确用法
深度解析Python核心类型转换内置函数int、str、list与dict的标准用法、底层运行机制、参数边界及避坑指南,助您构建稳健的数据类型转换方案。
在Python日常开发中,类型转换是构建数据管道与业务逻辑的基础操作。int()、str()、list() 和 dict() 四个内置函数虽然使用频率极高,但它们在参数缺省、边界条件、内存机制以及异常规避方面有着截然不同的设计准则。本文将系统拆解这四大内置函数的实现原理、标准参数配置与核心避坑要点,帮助你在工程实践中安全、高效地完成数据类型的显式转换。
一、int():数值与字符串转整数的规范与陷阱
int() 函数不仅承担着基本的数值截断任务,还内置了灵活的字符串进制解析引擎。其完整函数签名表现为 int(x=0) 与 int(x, base=10) 两种模式。在调用该函数时,必须明确区分数值转换与字符串转换的不同执行路径。
1. 浮点数向零截断的本质
当 x 为浮点数时,int(x) 采取的是“向零截断”(truncate towards zero)而非“四舍五入”。正浮点数取其整数部分,负浮点数同样向零方向舍去小数部分:
# 浮点数截断行为示例
val_pos = int(3.99)    # 结果为 3,而非 4
val_neg = int(-3.99)   # 结果为 -3,而非 -4

# 若需四舍五入,应配合 round() 函数
val_round = int(round(3.99))  # 结果为 4
2. 字符串转换中的空白字符与非法格式
当入参为字符串时,int() 会自动忽略首尾两侧的空白字符(包括空格、换行符和制表符)。然而,很多开发者容易忽略的是:十进制字符串中绝对不能包含小数点或非数字符号,否则将直接抛出 ValueError:
# 合法用法:首尾空白自动过滤
num = int("  42 \n")   # 结果为 42

# 常见错误:直接转换包含小数点的字符串将引发异常
# int("42.0")  # 抛出 ValueError: invalid literal for int() with base 10: '42.0'

# 正确处理路径:先转换为 float,再截断为 int
num_clean = int(float("42.0"))  # 结果为 42
3. base 参数的进制转换规则
base 参数允许在 2 到 36 之间指定数值基数,或者传入 0 让解释器自动推导前缀。需要特别强调:只要指定了 base 参数,第一个参数必须是字符串或字节类型,不能是数值类型:
# 正确用法:解析二进制、十六进制字符串
bin_val = int("1010", base=2)      # 结果为 10
hex_val = int("0x1F", base=16)     # 结果为 31
auto_val = int("0o77", base=0)     # base=0 自动识别八进制前缀,结果为 63

# 错误用法:数值类型传入 base 参数
# int(1010, base=2)  # 抛出 TypeError: int() can't convert non-string with explicit base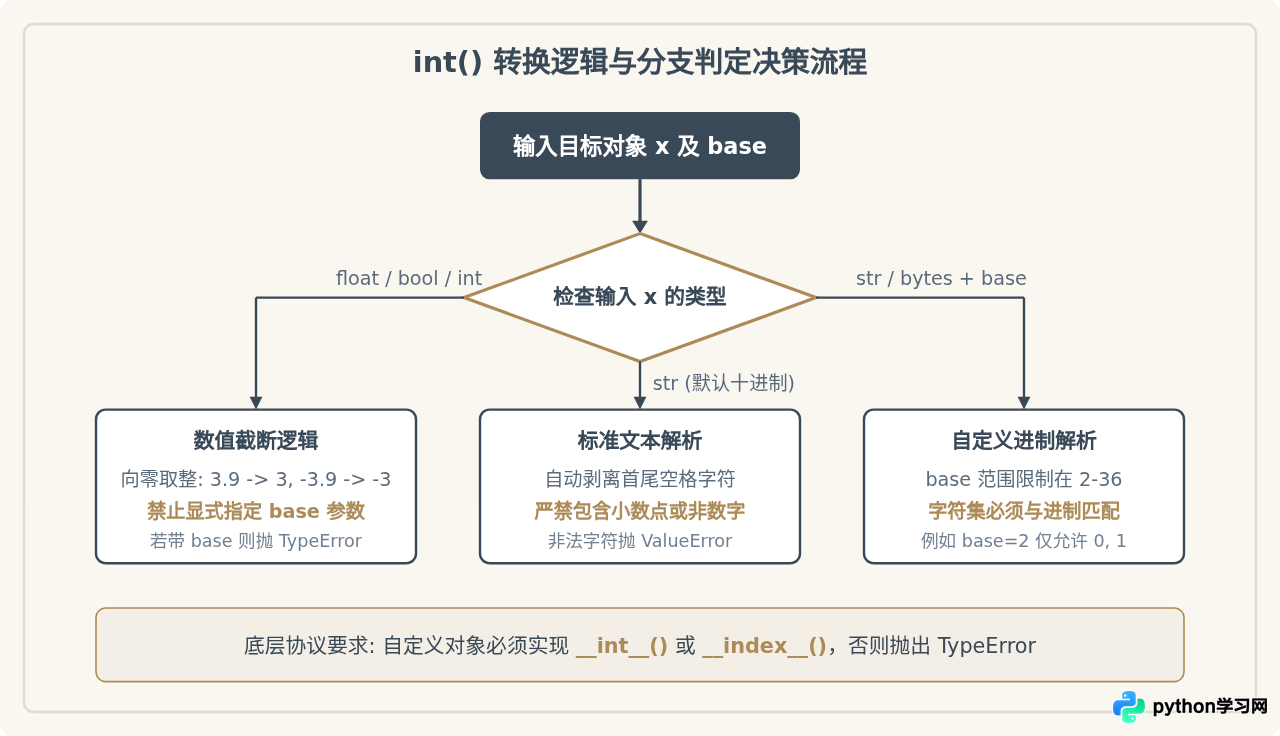
二、str():对象的字符串化与表达语义
str() 函数用于将任意 Python 对象转化为面向人类阅读的字符串表达。然而在实际工程中,str() 与 repr() 的概念混淆,以及容器序列化中的隐式转换,常常导致难以察觉的排错成本。
1. str() 与 repr() 的语义分歧与调用回退
Python 中对于字符串化设计了两套并行的底层协议:__str__() 与 __repr__()。它们的核心区别在于目标受众:
- str():面向终端用户,强调简洁直观,输出内容通常不包含数据类型的形态修饰。
- repr():面向开发者与调试工具,强调明确无歧义,理想情况下应满足
eval(repr(x)) == x。
在底层查找机制上,若类中未显式定义 __str__(),Python 会自动回退调用 __repr__();但如果未定义 __repr__(),则会继承 object 默认的内存地址格式(如 <MyClass object at 0x...>)。
import datetime

now = datetime.datetime(2026, 10, 26, 1, 30, 0)

# str() 返回清晰可读的时间文本
print(str(now))   # 输出示例: 2026-10-26 01:30:00

# repr() 返回可重构对象的代码级描述
print(repr(now))  # 输出示例: datetime.datetime(2026, 10, 26, 1, 30, 0)
2. 容器对象调用 str() 的陷阱
一个极其普遍的误区是直接对包含多个对象的列表或字典调用 str(),并期望其中的元素以 str() 形式展现。实际上,Python 容器内部元素在被字符串化时,默认调用的是元素的 repr() 而非 str():
items = ["apple", 100]

# 直接调用 str() 得到的是容器字面量表示
s = str(items)  # 结果为 "['apple', 100]"

# 注意:字符串 'apple' 依然保留了单引号,因为容器对其调用了 repr()
# 若需拼接纯文本列表,应使用 str.join() 搭配推导式
clean_s = ", ".join(str(x) for x in items)  # 结果为 "apple, 100"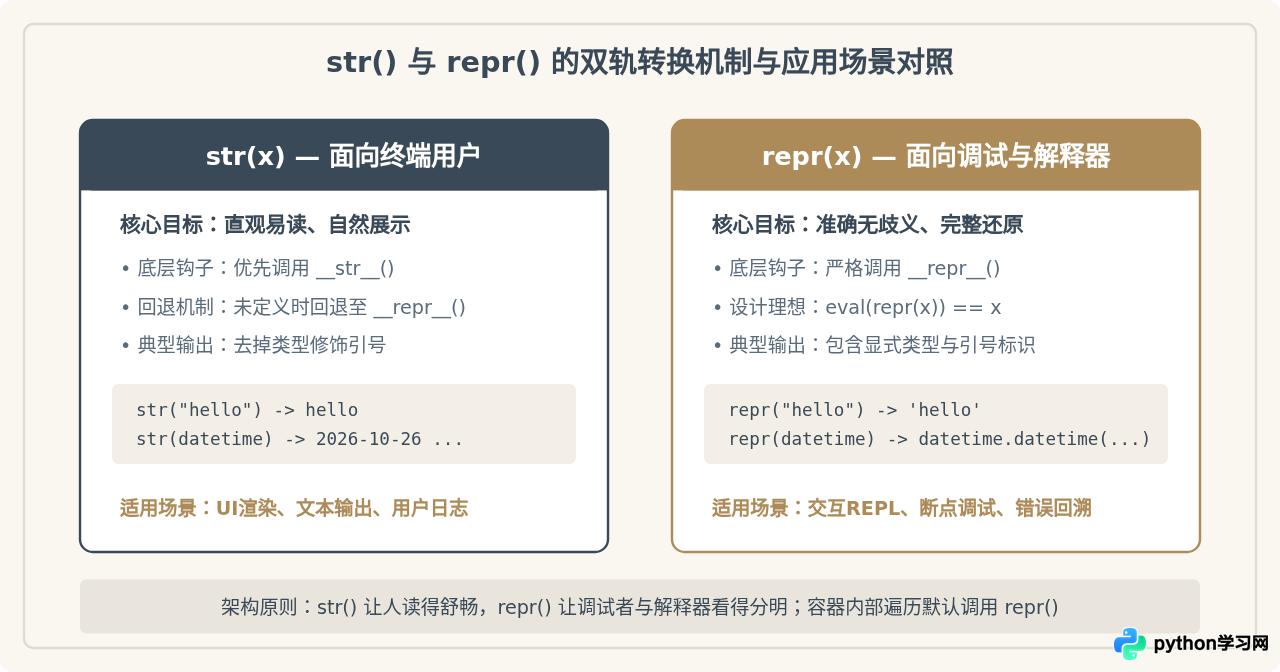
三、list():可迭代对象的列表化与切片展开
list([iterable]) 内置函数的作用是遍历传入的任意可迭代对象,并将其元素依次写入一个全新的动态数组(列表)。在实际应用中,它既是生成器固化的工具,也是很多内存隐患的高发地。
1. 常见数据源的转换特质
不同类型的输入在传递给 list() 时,其拆解逻辑各有不同:
- 字符串:按字符拆解为单字符元素列表,如
list("ABC")得到['A', 'B', 'C']。若想按特定分隔符拆词,必须使用str.split()。 - 字典:直接调用
list(dict_obj)默认仅提取其所有的键(Keys)。若需获取值需显式调用list(dict_obj.values()),若需键值对需调用list(dict_obj.items())。 - 生成器与迭代器:
list()会立即驱动迭代器执行,直到耗尽(Exhaustion)。这意味着生成器在完成转换后即处于空状态,无法二次读取。
# 字典转换的默认行为对比
user_data = {"id": 101, "role": "admin"}

keys_only = list(user_data)          # 结果: ['id', 'role']
values_only = list(user_data.values()) # 结果: [101, 'admin']
item_pairs = list(user_data.items())   # 结果: [('id', 101), ('role', 'admin')]

# 生成器耗尽现象
def count_down():
    yield 3
    yield 2
    yield 1

gen = count_down()
first_run = list(gen)   # 结果: [3, 2, 1]
second_run = list(gen)  # 结果: [] (生成器已被完全消耗)
2. 浅拷贝(Shallow Copy)陷阱
通过 list(existing_list) 可以快速复制一个现有列表。但必须清醒认识到:该转换构造仅是浅拷贝。新列表虽然是一个全新的独立外壳,但其中嵌套的子对象依然引用自原有内存空间:
original = [1, [2, 3]]
copied = list(original)

# 修改新列表的外层结构:互不影响
copied.append(4)
print(original)  # [1, [2, 3]] (原列表无变化)

# 修改新列表中的嵌套对象:原列表同样被污染!
copied[1].append(999)
print(original)  # [1, [2, 3, 999]] (原列表嵌套项同步改变)

# 解决策略:若需完全隔离,使用 copy.deepcopy()
import copy
safe_copied = copy.deepcopy(original)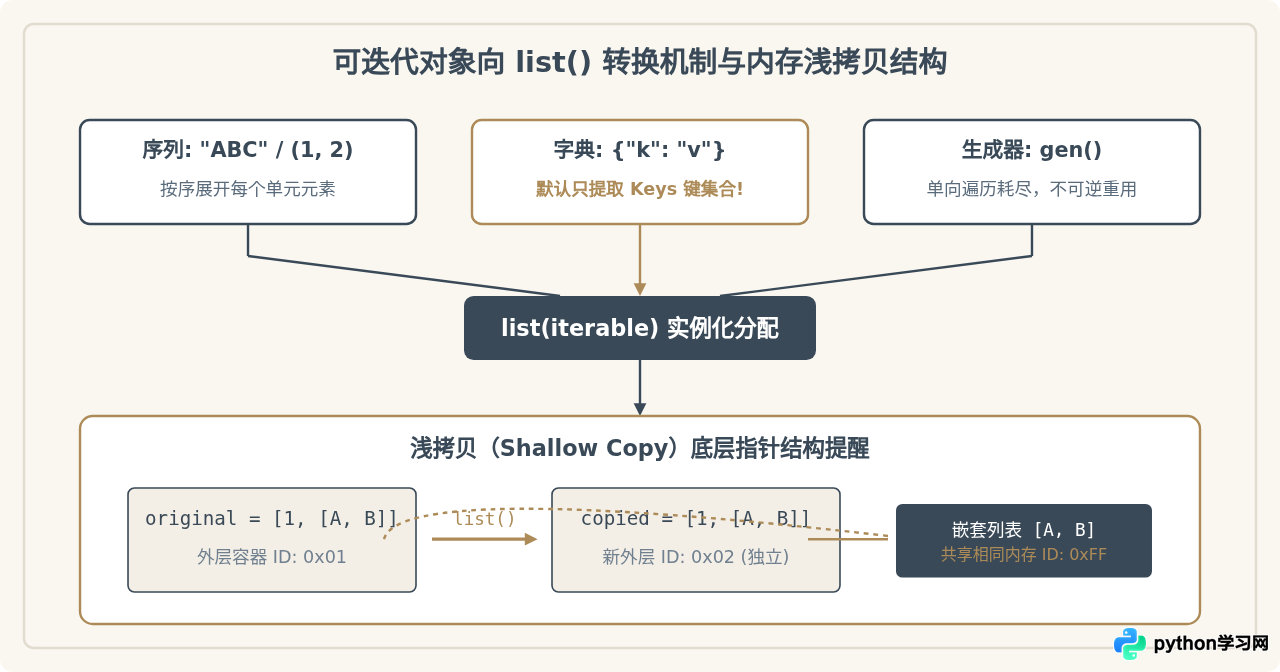
四、dict():键值映射的构建规则与合法数据源
dict() 构造器用于创建哈希表映射。相比直接使用花括号字面量 {},dict() 内置函数在动态构建与数据流水线中扮演着极其核心的角色,但其入参结构受到严格的格式约束。
1. 二元元组序列构建字典
向 dict() 传递单个参数时,该参数必须是由长度严格等于 2 的子可迭代对象构成的序列。第 1 项充当 Key,第 2 项充当 Value:
# 标准二元组列表
pairs = [("host", "127.0.0.1"), ("port", 8080)]
config = dict(pairs)  # 结果: {'host': '127.0.0.1', 'port': 8080}

# 常见错误:元素长度不符引发 ValueError
# bad_pairs = [("host", "127.0.0.1", "primary")]
# dict(bad_pairs)  # 抛出 ValueError: dictionary update sequence element #0 has length 3; 2 is required
2. zip() 搭配构建动态映射
在批量处理表头与行数据、或者映射字段与值时,dict(zip(keys, values)) 是 Python 中最高效优雅的经典范式:
headers = ["id", "username", "status"]
row_data = [1001, "alex_dev", "active"]

# 通过 zip() 动态组合成键值映射
user_record = dict(zip(headers, row_data))
# 结果: {'id': 1001, 'username': 'alex_dev', 'status': 'active'}
3. 关键字参数构建的限制
dict() 允许使用 dict(k1=v1, k2=v2) 的关键字形式。然而这种方式存在语法级限制:所有的键名必须是符合 Python 命名规范的合法标识符,无法使用数字开头、包含连字符(减号)或空格的字符串作为键:
# 合法关键字参数
d1 = dict(name="Alice", score=98)

# 语法错误:键名非合法标识符
# d2 = dict(content-type="application/json")  # SyntaxError: cannot assign to expression here
# d3 = dict(100="code")                       # SyntaxError: expression cannot contain assignment

# 规避方案:针对非法标识符键名,采用标准字典字面量或二元组序列
d_safe = {"content-type": "application/json", 100: "code"}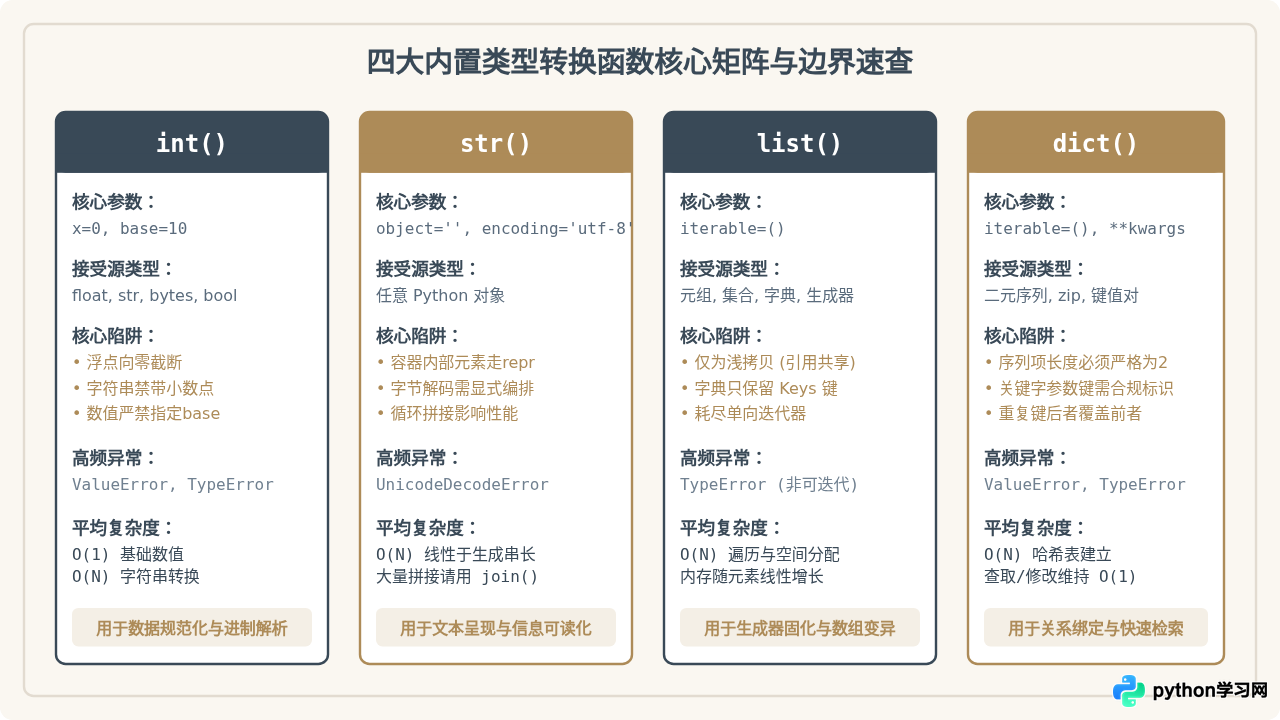
五、工程实践:防御性转换与最佳实践准则
在生产级数据清洗与业务处理中,直接暴露裸调用的内置类型转换往往是系统崩溃的导火索。为确保系统的健壮性,应遵循以下三大实战规范:
1. 封装安全的防御性类型转换器
面对来自外部接口、HTTP 查询参数或 CSV 文件的弱类型输入,应始终采用 try-except 模式捕获 (ValueError, TypeError),并支持提供默认兜底值:
def safe_to_int(val, default=0):
    """安全转换为整数,支持浮点字符串与脏数据容错"""
    if val is None:
        return default
    try:
        # 先转 float 吸收 "12.3" 这类含小数点的字符串
        return int(float(val))
    except (ValueError, TypeError):
        return default

# 测试防御性效果
print(safe_to_int("123"))      # 123
print(safe_to_int("12.8"))     # 12
print(safe_to_int("invalid"))  # 0 (优雅降级,杜绝崩溃)
print(safe_to_int(None, -1))   # -1
2. 明确区分深浅拷贝需求
当需要从原有集合或列表衍生新数据结构时,必须根据数据中是否存在嵌套可变对象(字典、列表、集合)来选择方案。对于纯标量列表,list(src) 拥有最高性能;若涉及嵌套结构且后续存在就地修改(In-place mutation),必须使用标准库的 copy.deepcopy()。
3. 合理运用类型注解与现代验证框架
在复杂的企业级项目中,手写大量的显式类型转换既冗长又容易漏判。建议将 int、str、list、dict 的内置转换与 Python 类型注解(Type Hints)结合,或在上层借助 Pydantic、dataclasses 等工具进行自动化反序列化验证,从而让数据流在进入核心业务层前便具备确定性的类型契约。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









