

Python机器学习新手实战:鸢尾花分类与房价预测项目全流程
本文通过鸢尾花分类与房价预测两个经典案例,完整梳理Python机器学习项目从数据准备、特征工程、模型训练到评估指标解读的端到端实战流程。
机器学习对于刚入门的学习者而言,最常遇到的瓶颈不是算法数学公式的推导,而是如何把零碎的代码组织成一个规范、完整的工程流程。本文通过两个最经典的新手级案例——基于鸢尾花数据集的分类任务与基于加州房价数据集的回归任务,手把手带大家跑通从环境搭建、数据探索、特征处理、模型训练到指标评估的完整闭环,掌握监督学习中最核心的两类典型应用。
一、机器学习实战的标准工作流程与环境准备
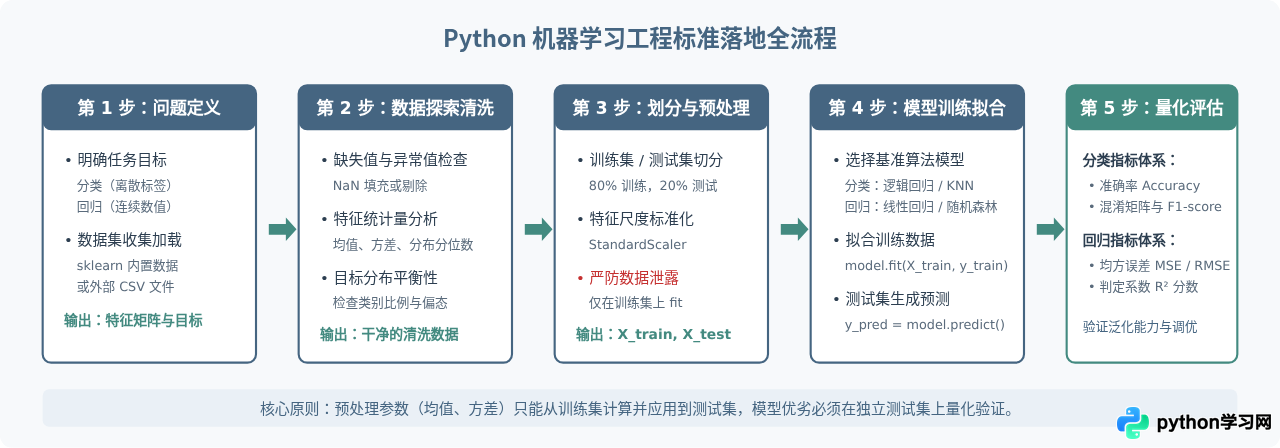
无论任务是预测离散的类别标签(分类)还是预测连续的数值结果(回归),标准的机器学习项目都遵循统一的工程流线。很多新手在起步阶段容易跳过数据清洗或特征标准化直接调用算法包,从而导致模型无法收敛或出现严重的数据泄露。
在开始写代码前,需要准备标准的 Python 数据科学环境。推荐使用 Python 3.8 及以上版本,核心依赖库包括:numpy(矩阵数值运算)、pandas(表格数据清洗)、matplotlib(数据可视化)以及 scikit-learn(机器学习算法集)。在命令行中执行以下命令即可完成安装:
pip install numpy pandas matplotlib scikit-learn安装完成后,我们可以通过下面这张端到端流程图整体把握一个规范的机器学习项目各阶段的演进次序。
二、项目实战一:鸢尾花分类项目全流程
1. 任务背景与数据特性
鸢尾花(Iris)分类是机器学习中最著名的“Hello World”式多分类任务。该数据集由统计学家 Ronald Fisher 引入,包含 150 条样本,共有 3 个鸢尾花品种类别(山鸢尾 Setosa、变色鸢尾 Versicolor、维吉尼亚鸢尾 Virginica),每个类别各有 50 个样本。每个样本记录了 4 个连续型数值测量特征:
- 花萼长度(Sepal Length,单位:cm)
- 花萼宽度(Sepal Width,单位:cm)
- 花瓣长度(Petal Length,单位:cm)
- 花瓣宽度(Petal Width,单位:cm)
2. 数据加载与探索性分析(EDA)
scikit-learn 内置了该数据集,无需外部下载。我们编写代码加载数据并将其转为 Pandas DataFrame 查看字段信息:
from sklearn.datasets import load_iris
import pandas as pd

# 加载内置鸢尾花数据集
iris = load_iris()
df = pd.DataFrame(data=iris.data, columns=iris.feature_names)
df['target'] = iris.target

# 查看前 5 行样本与目标分布
print("数据前 5 行预览:")
print(df.head())
print("\n各类别的样本计数:")
print(df['target'].value_counts())
print("\n数据集基本统计描述:")
print(df.describe())
运行结果显示数据没有任何缺失值(NaN),特征均在 0.1 到 7.9 厘米之间,且三个类别样本量完全均衡。这使得我们可以集中精力在数据预处理和建模上。
3. 数据集划分与标准化
在机器学习中,测试集用来模拟“未来未见过的数据”。我们必须先将数据切分为训练集(80%)与测试集(20%),然后再进行特征缩放(StandardScaler)。
fit_transform(),测试集的均值和方差就会提前泄露进训练过程中,造成乐观评估假象。正确做法是:仅在 X_train 上 fit(),随后对 X_train 和 X_test 执行 transform()。
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler

# 分离特征矩阵与目标向量
X = iris.data
y = iris.target

# 划分训练集和测试集(设置 stratify=y 确保各类样本比例一致)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 特征标准化
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
4. 模型训练:K近邻(KNN)与逻辑回归(Logistic Regression)
为了对比效果,我们训练两个常用的经典分类算法:
- K 近邻(KNN):根据待测样本与训练集中最近的 K 个邻居的多数表决进行类别判定。
- 逻辑回归(Logistic Regression):通过 Sigmoid/Softmax 函数计算各类别的概率分布,是线性可解释分类器。
from sklearn.neighbors import KNeighborsClassifier
from sklearn.linear_model import LogisticRegression

# 1. 训练 KNN 分类器(选择 k=5)
knn_model = KNeighborsClassifier(n_neighbors=5)
knn_model.fit(X_train_scaled, y_train)

# 2. 训练多分类逻辑回归模型
lr_model = LogisticRegression(random_state=42, max_iter=200)
lr_model.fit(X_train_scaled, y_train)
5. 分类评估指标与混淆矩阵解读
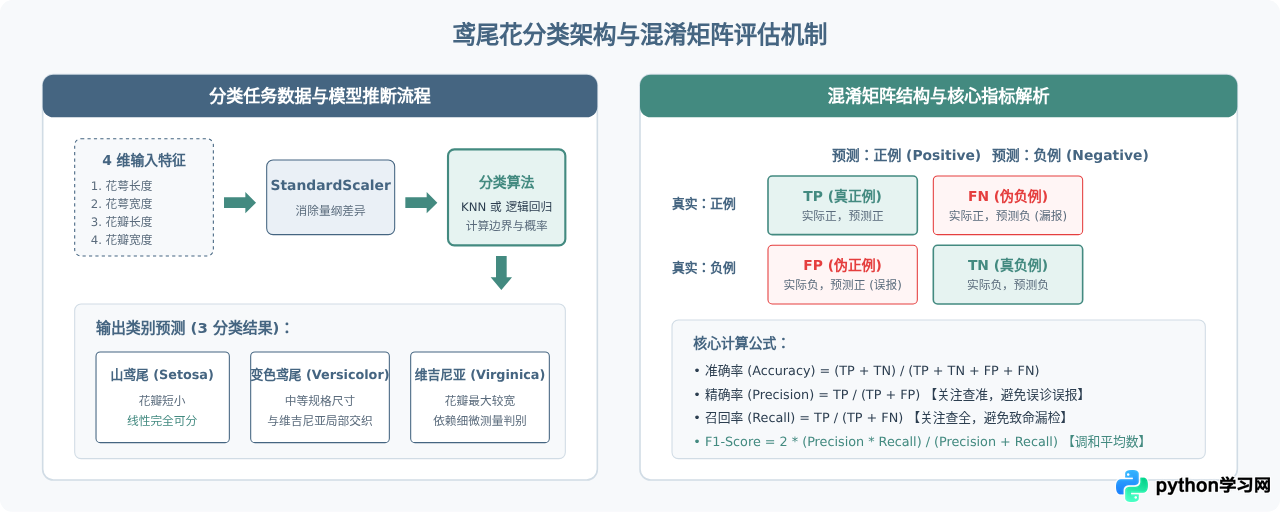
分类任务不能只看单一的总体准确率(Accuracy),当类别不均衡或错判成本不同时,必须借助混淆矩阵(Confusion Matrix)、精确率(Precision)、召回率(Recall)及综合评估指标 F1-score。
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

# 生成测试集预测
y_pred_knn = knn_model.predict(X_test_scaled)

# 计算准确率
acc = accuracy_score(y_test, y_pred_knn)
print(f"KNN 测试集分类准确率: {acc:.4f}\n")

# 输出完整分类评估报告
print("分类详细报告(精确率、召回率、F1得分):")
print(classification_report(y_test, y_pred_knn, target_names=iris.target_names))

# 打印混淆矩阵
print("混淆矩阵:")
print(confusion_matrix(y_test, y_pred_knn))
下图详细展示了鸢尾花分类的特征映射流向与混淆矩阵各指标的计算机制:
三、项目实战二:加州房价预测项目全流程
1. 任务背景与回归问题特点
与分类任务输出离散类别不同,回归任务的目标是预测一个连续的实数值。早期的教程常用波士顿房价数据集,但因其年代久远且含伦理争议字段,现代 scikit-learn 推荐使用加州房价数据集(California Housing Dataset)。
该数据集包含加州各街区的 20,640 条统计记录,目标变量为街区房屋价值中位数(单位:10万美元),特征包括:
MedInc:街区居民收入中位数HouseAge:街区房屋房龄中位数AveRooms:平均每户房间数AveBedrms:平均每户卧室数Population:街区常住人口总数AveOccup:平均每户居住人数Latitude和Longitude:地理经纬度坐标
2. 数据探索与训练集准备
from sklearn.datasets import fetch_california_housing
import pandas as pd

# 加载加州房价数据
housing = fetch_california_housing(as_frame=True)
df_house = housing.frame

print("加州房价特征信息概览:")
print(df_house.info())
print("\n目标变量(房屋中位价)统计分布:")
print(df_house['MedHouseVal'].describe())
从数据概览中可以看到,各个特征的取值范围跨度极大。例如收入中位数主要在 1 到 15 之间,而街区人口 Population 可以高达数千人。如果直接使用基于距离或梯度的算法,大尺度的特征将会主导模型训练,因此必须对特征做标准化处理。
3. 构建回归模型管道与训练
这里我们对比两种具有代表性的回归模型:
- 多元线性回归(Linear Regression):建立特征之间的线性组合公式 \( y = w_1 x_1 + w_2 x_2 + \dots + b \),计算简单,易于解释权重系数。
- 随机森林回归(Random Forest Regressor):基于集成学习中的 Bagging 机制,利用上百棵决策树进行投票回归,能够捕捉非线性复杂关系。
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor

# 特征矩阵与连续目标
X_house = housing.data
y_house = housing.target

# 划分训练集与测试集(8:2 切分)
X_train_h, X_test_h, y_train_h, y_test_h = train_test_split(
    X_house, y_house, test_size=0.2, random_state=42
)

# 仅用训练集做标准化拟合
scaler_h = StandardScaler()
X_train_h_scaled = scaler_h.fit_transform(X_train_h)
X_test_h_scaled = scaler_h.transform(X_test_h)

# 1. 拟合线性回归
lr_reg = LinearRegression()
lr_reg.fit(X_train_h_scaled, y_train_h)

# 2. 拟合随机森林回归(设置 100 棵树)
rf_reg = RandomForestRegressor(n_estimators=100, random_state=42, n_jobs=-1)
rf_reg.fit(X_train_h_scaled, y_train_h)
4. 回归模型量化评估与残差分析
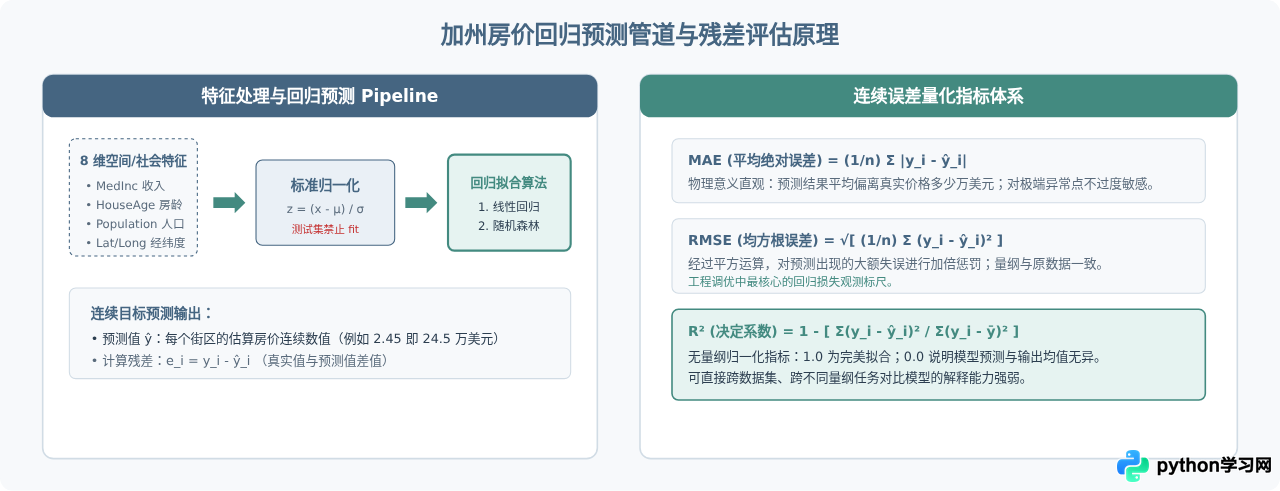
对于连续数值预测,不能计算准确率百分比。我们需要衡量“预测值与真实值之间的距离差距”,核心评价指标包括:
- MAE(平均绝对误差):真实值与预测值差值的绝对值均值,直观反映平均预测偏差。
- MSE(均方误差)与 RMSE(均方根误差):平方和均值及其平方根。由于进行了平方,RMSE 对大误差惩罚非常严厉。
- \( R^2 \) 决定系数(Score):介于 0 到 1 之间(极差时可能为负)。1 代表模型完美解释了目标变量的所有方差;0 代表模型预测能力仅相当于输出整体均值。
import numpy as np
from sklearn.metrics import mean_absolute_error, mean_squared_error, r2_score

# 在测试集上进行预测
y_pred_lr = lr_reg.predict(X_test_h_scaled)
y_pred_rf = rf_reg.predict(X_test_h_scaled)

def evaluate_regression(y_true, y_pred, name="Model"):
    mae = mean_absolute_error(y_true, y_pred)
    mse = mean_squared_error(y_true, y_pred)
    rmse = np.sqrt(mse)
    r2 = r2_score(y_true, y_pred)
    print(f"--- {name} 评估结果 ---")
    print(f"MAE  (平均绝对误差): {mae:.4f}")
    print(f"RMSE (均方根误差):   {rmse:.4f}")
    print(f"R²   (决定系数):     {r2:.4f}\n")

evaluate_regression(y_test_h, y_pred_lr, "多元线性回归")
evaluate_regression(y_test_h, y_pred_rf, "随机森林回归")
在实际运行中,线性回归的 \( R^2 \) 分数大约在 0.58 左右,而随机森林可以达到 0.80 以上,表明非线性树模型能更好地拟合地理位置和房龄等复杂交互关系。
下图展示了房价预测建模流水线以及残差分布分析的核心逻辑:
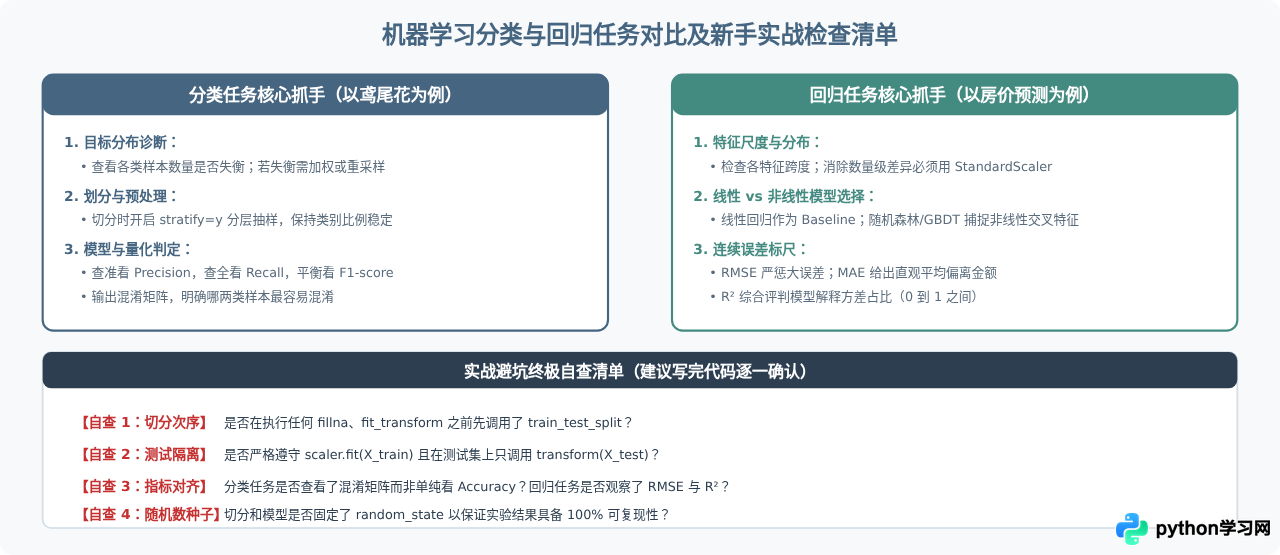
四、分类与回归项目对比及新手常见陷阱总结
在熟练完成鸢尾花分类和加州房价预测后,我们需要站在更高维度总结分类与回归在全流程中的异同,并提炼实际项目中高频踩坑的关键检查点。
| 对比维度 | 分类任务(如鸢尾花分类) | 回归任务(如加州房价预测) |
|---|---|---|
| 目标变量形态 | 离散型标签(类别编号:0, 1, 2) | 连续型实数(房价金额:2.45, 3.12) |
| 常用基准模型 | 逻辑回归、K近邻(KNN)、支持向量机(SVM)、决策树分类器 | 线性回归、岭回归(Ridge)、随机森林回归、梯度提升树(GBDT) |
| 核心评估指标 | 准确率 (Accuracy)、混淆矩阵、精确率、召回率、F1 分数 | 平均绝对误差 (MAE)、均方根误差 (RMSE)、决定系数 (R²) |
| 输出形式 | 类别预测 predict() 或类别概率 predict_proba() |
具体数值 predict() |
新手高频踩坑点与避坑指南
- 数据泄露(Data Leakage):将整个数据集一次性进行
StandardScaler或Imputer填充,这会导致测试集的信息参与了均值/方差计算。必须先切分 train_test_split,且只能在 train 集上 fit。 - 指标选择错配:在不平衡分类任务中盲目看总体 Accuracy。例如 99% 的样本是负例,模型全猜负例准确率也有 99%,但召回率为 0。必须结合混淆矩阵和 F1 分数。在回归任务中则切忌使用准确率概念。
- 过拟合与欠拟合判断:在训练集上指标极佳而在测试集上下跌严重通常是过拟合(如决策树深度过大);两个集合指标均不理想则为欠拟合(特征不足或模型表达力弱)。
- 未检查特征尺度:线性回归、逻辑回归、KNN、神经网络等基于欧氏距离或梯度下降的算法对特征尺度极其敏感,不做标准化会导致迭代缓慢甚至难以收敛。
五、总结与下一步学习进阶路径
通过鸢尾花分类与加州房价预测两个实战项目,我们完整掌握了 Python 机器学习的标准生命周期。从加载数据、切分、特征工程,到模型拟合与客观多维评估,这一套范式可以平滑迁移到工业级业务项目中。
掌握了这两个基石项目之后,建议读者在以下三个方向继续深化探索:
- 交叉验证(K-Fold Cross-Validation):用更稳健的 K 折切分替代单次 train_test_split,降低小样本评估的偶然性。
- 超参数网格搜索(GridSearchCV / RandomizedSearchCV):自动化探索最优参数组合(如随机森林的树数量、树最大深度)。
- 特征工程进阶:学习类别型变量独热编码(One-Hot Encoding)、特征相互组合交互、以及基于相关系数的特征筛选。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









