

Python机器学习中的test set是什么?sklearn训练集与测试集划分
深入解析Python机器学习中的测试集(test set)概念与核心价值,全面演示scikit-learn中train_test_split的标准化划分步骤、参数配置、分层抽样及防范数据泄露的工程实践规范。
在Python机器学习中,测试集(test set)是一组在模型训练阶段被严格隔离、完全不参与参数学习与权重更新的独立数据子集。它的唯一任务是充当“裁判”,在模型全部训练完成后客观度量模型对从未见过的全新样本的预测表现,即泛化能力(Generalization Ability)。本文将系统讲解测试集的产生原理、为什么要进行数据集拆分,并通过 scikit-learn(sklearn)库的 train_test_split 详解标准划分代码、分层抽样技巧以及避免数据泄露的规范操作。
一、情境引入:什么是测试集(Test Set)
假设你收集了一批包含面积、户型、房龄和成交价格的真实二手房挂牌数据,并构建了一个回归算法去拟合房价。如果直接将手头的全部数据喂给算法学习,随后再拿这批同样的数据去检验预测准确度,模型很可能交出几乎完美的预测答卷(比如均方误差极低、准确率高达 99%)。然而,一旦该模型上线接入真实业务系统,面对次日最新挂牌的新房源时,预测误差却常常变得大到不可思议。
这种现象在机器学习中极为常见。模型并没有真正理解特征与目标之间的本质统计规律,而仅仅是“死记硬背”了训练数据中的具体数值乃至偶然噪声。为了验证模型到底学到了真正的通用规则还是只记住了已知答案,我们必须将数据划分为职责严格分离的两个阵营:训练集(Training Set)与测试集(Test Set)。
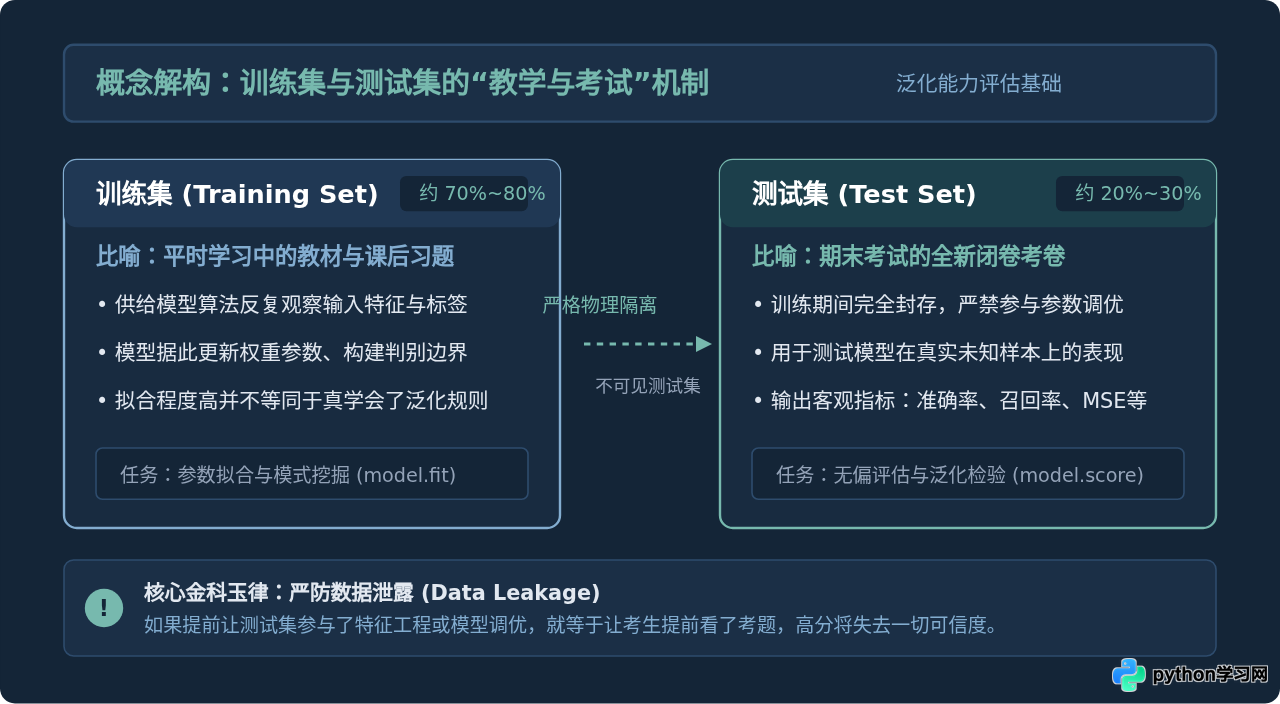
可以将这个过程类比为教学与考试:训练集就像学生平时的教材与课后习题,学生可以反复翻阅、揣摩错题、总结解题规律;而测试集则是学期末的全新闭卷考试试卷。如果考试试卷在开考前就泄露给学生背诵,即使考出满分,也完全无法证明学生真正掌握了知识。
二、为什么要划分数据集?识别过拟合与数据泄露
机器学习的核心追求不是“在已有样本上拟合得有多完美”,而是“在未来的未知样本上能否做出准确预判”。将数据集严格切分具有两大不可替代的工程目标:
- 有效检出过拟合(Overfitting):高复杂度模型(如高阶多项式回归、深层决策树或深度神经网络)具有极强的拟合能力,极易将训练数据中的偶然抖动、异常点当成普遍规律来记忆。如果只在训练集上自查,过拟合现象会被彻底掩盖;只有在独立的测试集上验证,过拟合造成的预测性能滑坡才会立刻暴露。
- 提供无偏的性能基准:只有当测试集与训练过程在信息层面彻底绝缘时,测试集给出的准确率、精确率、F1分数或均方误差(MSE)才具备统计意义上的客观性与可信度。
三、使用 scikit-learn 进行划分:train_test_split 详解
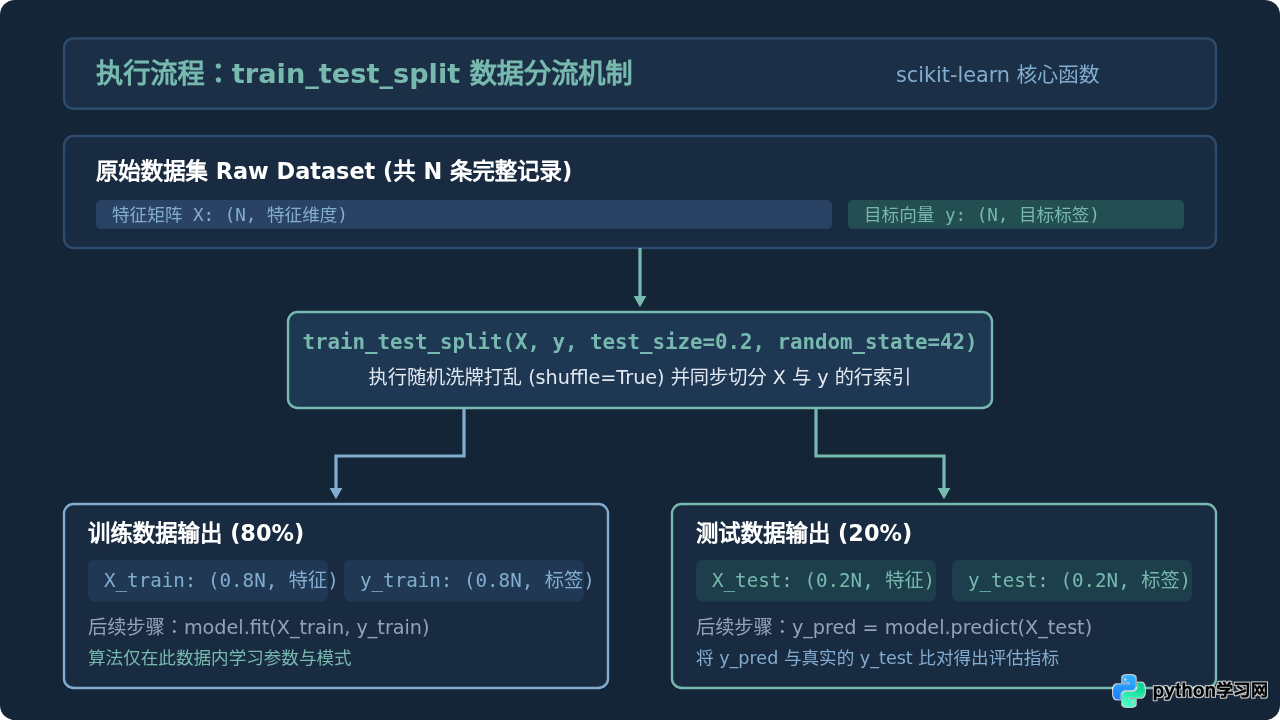
在 Python 生态中,scikit-learn(通常缩写为 sklearn)提供了最权威、最常用的划分工具 train_test_split,它位于 sklearn.model_selection 子模块下。
1. 核心参数剖析
该函数的完整签名及常见参数含义如下:
arrays:要切分的一个或多个数组/矩阵(如特征矩阵X和标签向量y),各数组第一维度长度必须相同。test_size:测试集比例。通常取 0.2 或 0.25(表示测试集占 20%~25%),若传入整数则代表具体样本数。train_size:训练集比例。一般与test_size二选一即可,系统会自动计算互补值。random_state:随机数发生器种子。指定固定整数(如 42)可以确保代码每次执行时产生完全相同的划分切片,这在科研实验与工程复现中至关重要。shuffle:布尔值,默认为True。划分前是否先对数据行进行随机洗牌。stratify:分层抽样基准,通常传入标签数组y。确保训练集和测试集保留与原数据集相同的类别比例。
2. 基础操作代码示例
下面是一个使用鸢尾花(Iris)分类数据集的完整示例,演示如何划分数据并验证子集的维度:
# 导入必要的库
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split

# 1. 加载数据集
iris = load_iris()
X = iris.data   # 特征矩阵,形状为 (150, 4)
y = iris.target # 标签向量,形状为 (150,)

# 2. 划分训练集与测试集(测试集占 20%,设置随机种子为 42)
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,
    random_state=42
)

# 3. 打印校验维度
print(f"原始样本数: {X.shape[0]}")
print(f"训练集特征维度: {X_train.shape}, 训练集标签维度: {y_train.shape}")
print(f"测试集特征维度: {X_test.shape}, 测试集标签维度: {y_test.shape}")执行输出说明:原始数据集共有 150 个样本。切分完成后,X_train 包含 120 行数据(占比 80%),X_test 包含 30 行数据(占比 20%)。注意解包变量的接收顺序严格为:X_train, X_test, y_train, y_test,切勿调换位置。
四、关键实战技巧与边界场景
1. 类别不平衡下的分层抽样(Stratified Split)
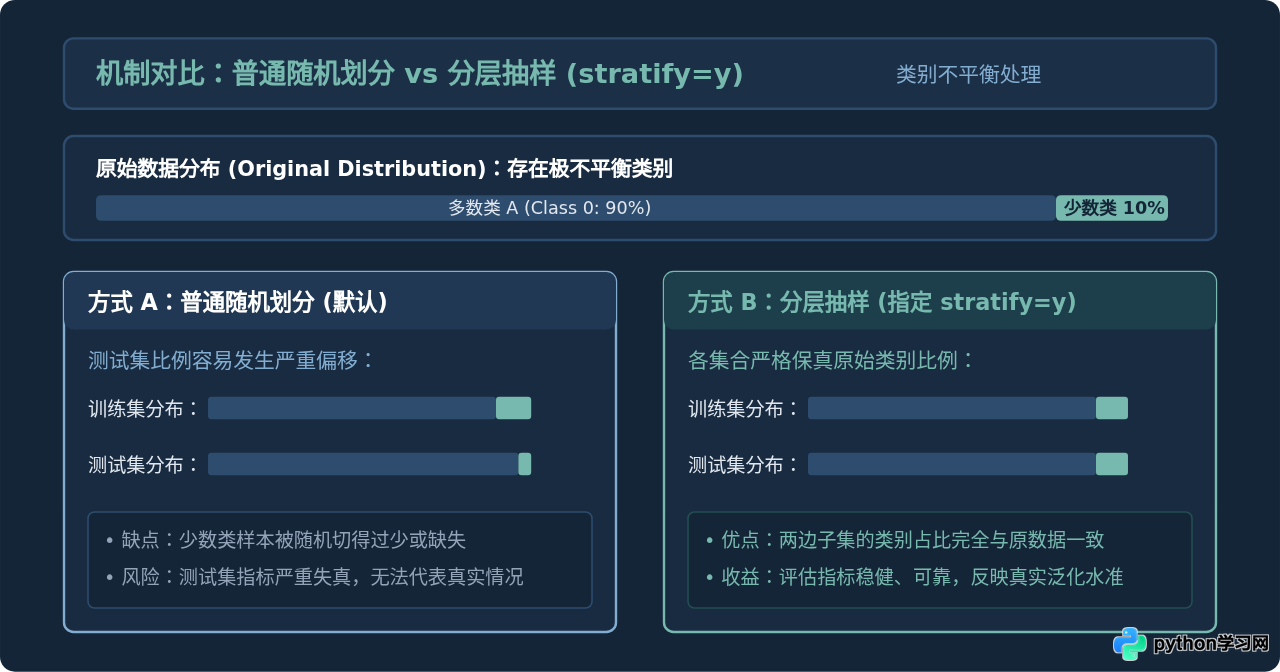
在现实的欺诈交易检测、罕见病诊断等分类任务中,正负样本比例往往极度悬殊(例如正常交易占 99%,欺诈交易仅占 1%)。如果使用默认的纯随机采样,测试集很可能完全分不到欺诈样本,导致评估指标失效;或者测试集中的欺诈比例失真,无法反映现实情况。
通过设置 stratify=y,函数会执行分层抽样,确保训练集与测试集各自的目标类别比例与原始全量数据严格一致。
分层抽样代码实现极为精炼:
# 启用分层抽样,保持正负样本分布一致
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.25,
    random_state=42,
    stratify=y  # 核心参数:根据目标标签分布分层切分
)
2. 时序数据的红线:禁止随机打乱(shuffle=False)
如果处理的是股票价格、气温预测、服务器网络流量等时间序列数据(Time Series),绝对不能使用默认的 shuffle=True。因为随机打乱会导致“用未来的数据去预测过去”,产生严重的先验未来信息穿越(Lookahead Bias)。对于时序数据,必须保持时间的严格先后顺序:
# 时序数据必须禁用打乱,按自然时间流顺序切分
X_train, X_test, y_train, y_test = train_test_split(
    X, y,
    test_size=0.2,
    shuffle=False  # 前80%时间跨度为训练集,后20%时间跨度为测试集
)
3. 特征缩放工程规范:先划分,再拟合
数据标准化(如 StandardScaler)或归一化是常见的特征工程步骤。必须牢记以下的标准顺序:
from sklearn.preprocessing import StandardScaler

# 错误做法:在全量数据上 fit_transform(导致数据泄露)
# X_scaled = scaler.fit_transform(X)
# X_train, X_test, y_train, y_test = train_test_split(X_scaled, y)

# 正确标准做法:
# 步骤 1:先切分数据集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

# 步骤 2:创建缩放器,仅在训练集上计算均值和方差(fit)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)

# 步骤 3:直接使用训练集得到的参数转换测试集(transform,禁止 fit!)
X_test_scaled = scaler.transform(X_test)
五、知识总结:训练集、验证集、测试集三者界定
在严肃的机器学习工程项目中,我们通常还会引入第三个数据集:验证集(Validation Set)。三者在职责分工上各有边界,不能混淆:
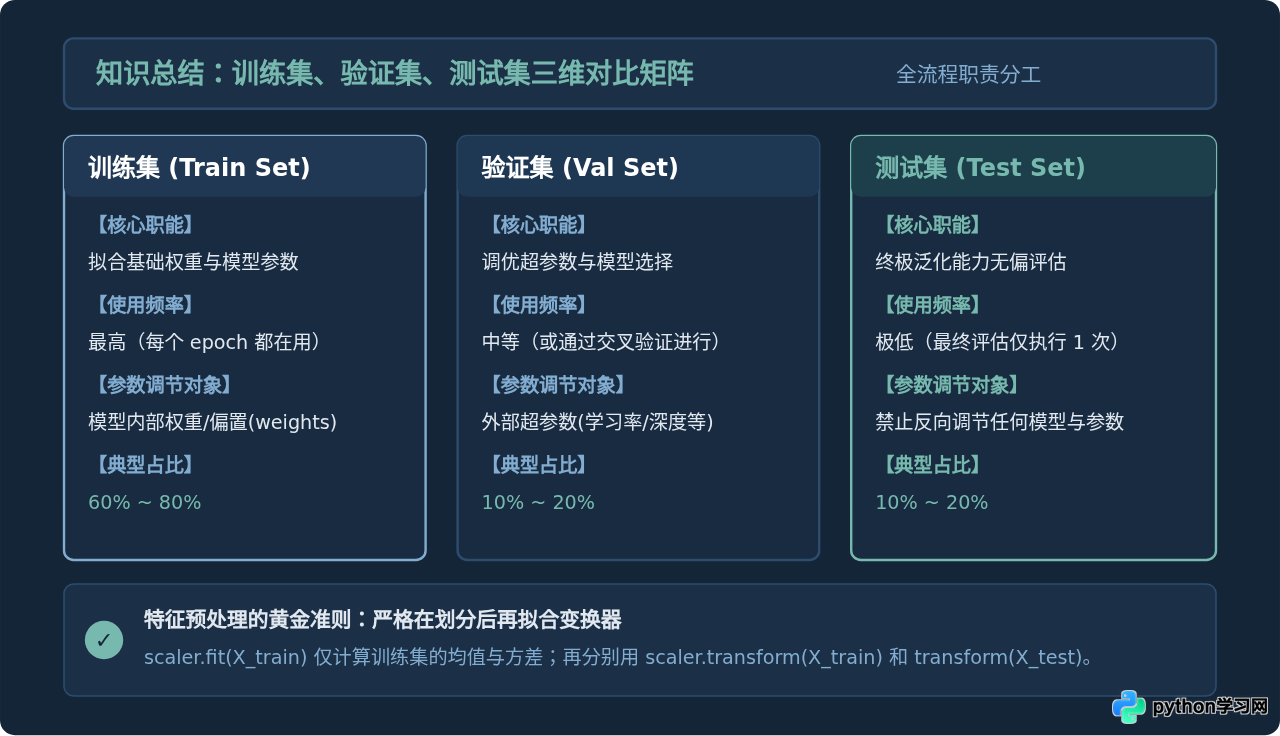
工程落地快速自查清单
| 检查维度 | 推荐做法 | 潜在风险 |
|---|---|---|
| 切分比例 | 传统机器学习选择 70:30 或 80:20;超大数据集(百万级)可切 98:2 | 测试集过小会导致评估方差过大;测试集过大会导致训练不充分 |
| 可复现性 | 显式传入 random_state=42(或其他固定整型) |
不设种子会导致每次运行得到不同划分,无法做对比试验 |
| 分类平衡 | 分类任务始终考虑设置 stratify=y |
少数类在子集中分布失衡,导致度量指标剧烈失真 |
| 时序特性 | 时间相关序列数据必须设置 shuffle=False |
产生先验未来信息穿越,实际部署时模型性能急剧恶化 |
| 特征转换 | 先执行 split,仅用训练集做 fit,再 transform 两端 |
在全量数据上 fit 导致测试集统计量提前泄露给模型 |
综上所述,测试集(test set)不仅是一个技术术语,更是保障机器学习模型具备现实泛化能力的基石制度。通过 sklearn.model_selection.train_test_split,开发者可以快速实现严谨、标准且可复现的数据隔离,为后续的模型构建与客观评估打下坚实的基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









