

Python爬虫怎么用requests下载网页图片
详细讲解如何使用Python requests库下载网页图片,涵盖二进制写入基础、stream流式分块下载、请求头与防盗链处理及文件存储规范。
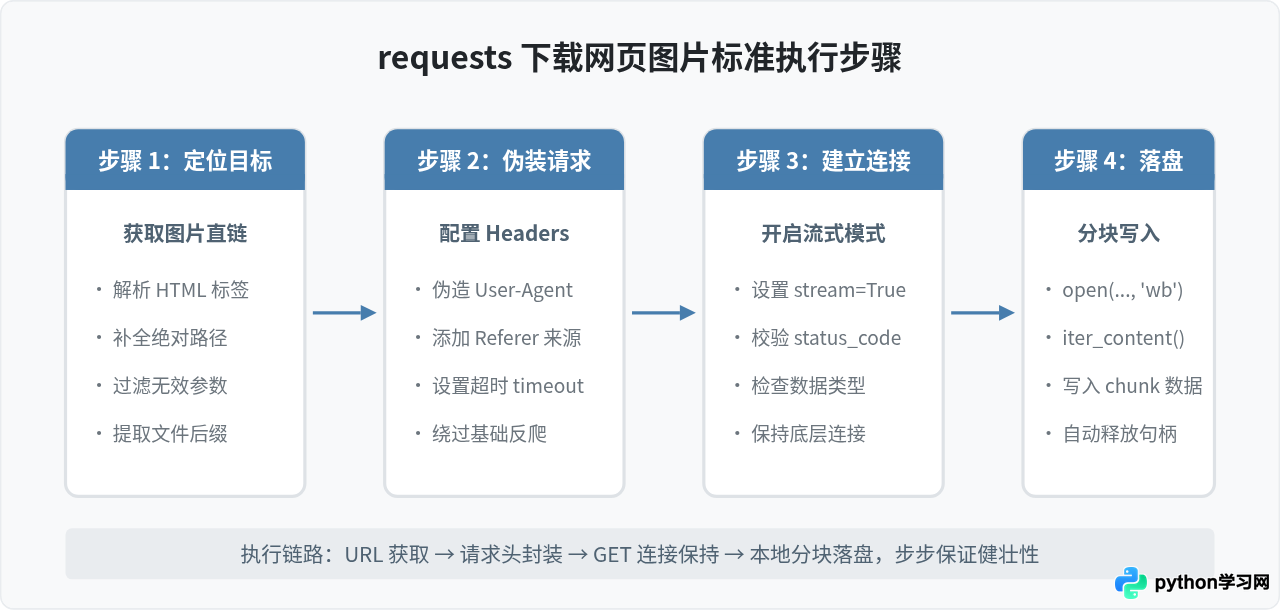
使用 Python 的 requests 库下载网页图片,核心逻辑包含三个动作:向图片直链发起 HTTP GET 请求、以二进制模式获取响应数据,最后将数据写入本地文件。整个流程并不复杂,但要做到稳定高效,还需要针对大文件使用流式传输,并配置适当的请求头以绕过防盗链限制。
基础下载:获取二进制内容并写入文件
网页上的图片、音频和视频等静态资源均属于二进制数据。在爬取普通网页文本时,通常使用 response.text,而下载图片时必须使用 response.content,它返回的是原始字节串(bytes)。将获取到的字节串写入本地时,文件打开模式必须指定为二进制写入模式 wb。
import requests

# 目标图片直链
img_url = "https://example.com/images/sample.jpg"

# 发起请求
response = requests.get(img_url)

# 确保请求成功
if response.status_code == 200:
    # 以二进制写入模式打开本地文件
    with open("sample.jpg", "wb") as f:
        f.write(response.content)
    print("图片保存完成")
else:
    print(f"请求失败,状态码: {response.status_code}")
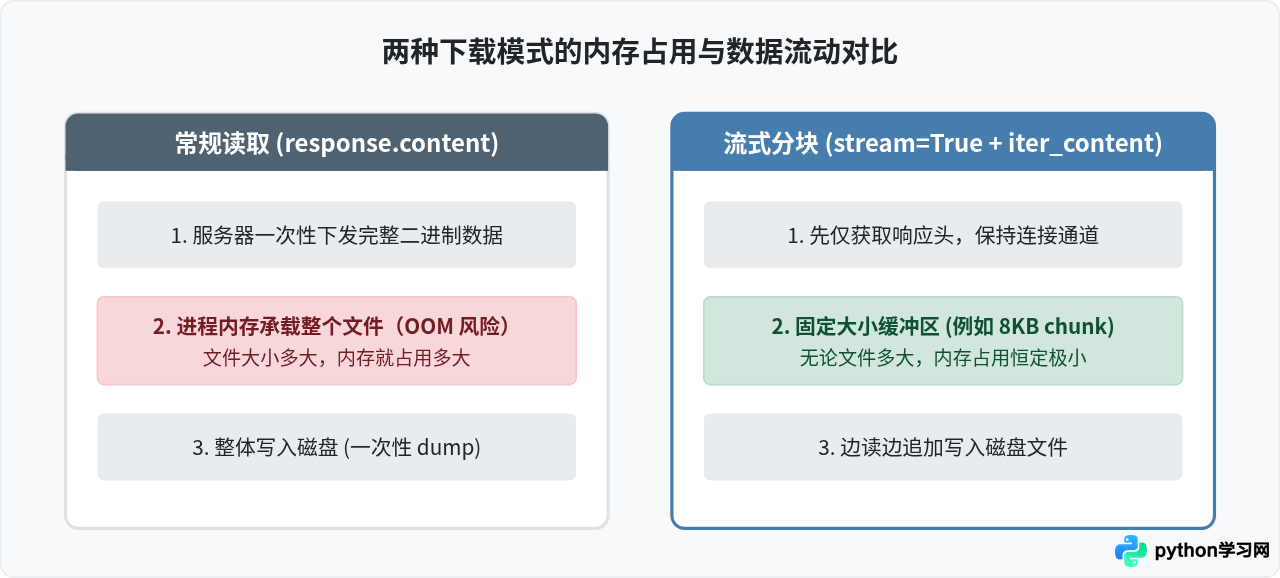
这段代码展示了图片下载的最简流程。如果图片体积较小且请求数量少,这种方式能够直接完成工作。然而,当图片分辨率较高或批量抓取时,直接使用 response.content 会将整个图片数据一次性加载到 Python 进程的内存中,容易导致内存占用急剧升高。
流式下载:应对大文件与批量下载
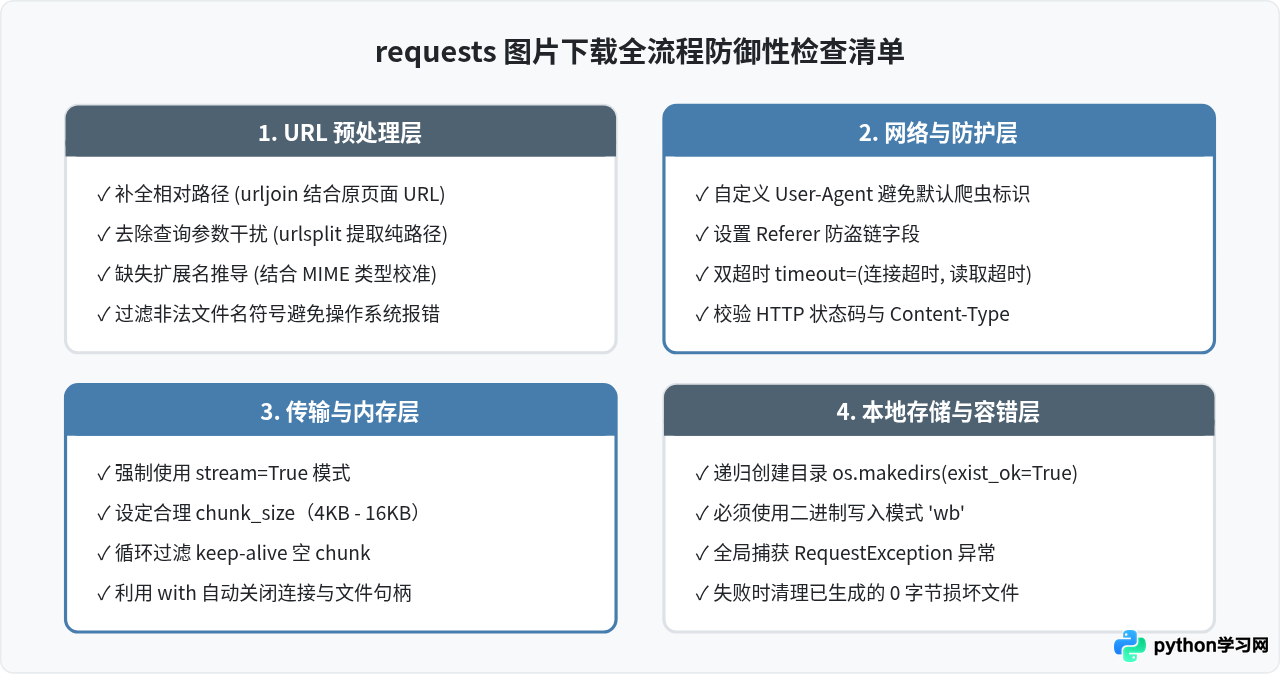
在生产环境中下载图片,推荐使用 stream=True 参数。当设置 stream=True 时,requests.get() 仅下载 HTTP 响应头,而不会立即下载响应体。随后可以通过 response.iter_content() 方法分块读取内容并写入磁盘。
这样做的好处是内存中始终只保存一个数据块(例如 8KB),无论单张图片是 500KB 还是 50MB,内存占用都可以保持稳定。
import requests

img_url = "https://example.com/large-image.png"

# 启用流式下载
response = requests.get(img_url, stream=True)

if response.status_code == 200:
    with open("large-image.png", "wb") as f:
        # 每次读取 8192 字节(8KB)
        for chunk in response.iter_content(chunk_size=8192):
            if chunk:
                f.write(chunk)
    print("流式写入完成")
在循环中加入 if chunk: 判断是为了过滤掉 Keep-Alive 保持连接时发送的空数据块。配合 Python 的 with 上下文管理器,写入完成后文件句柄与网络连接均能被正确关闭。
防盗链与反爬:配置请求头与超时
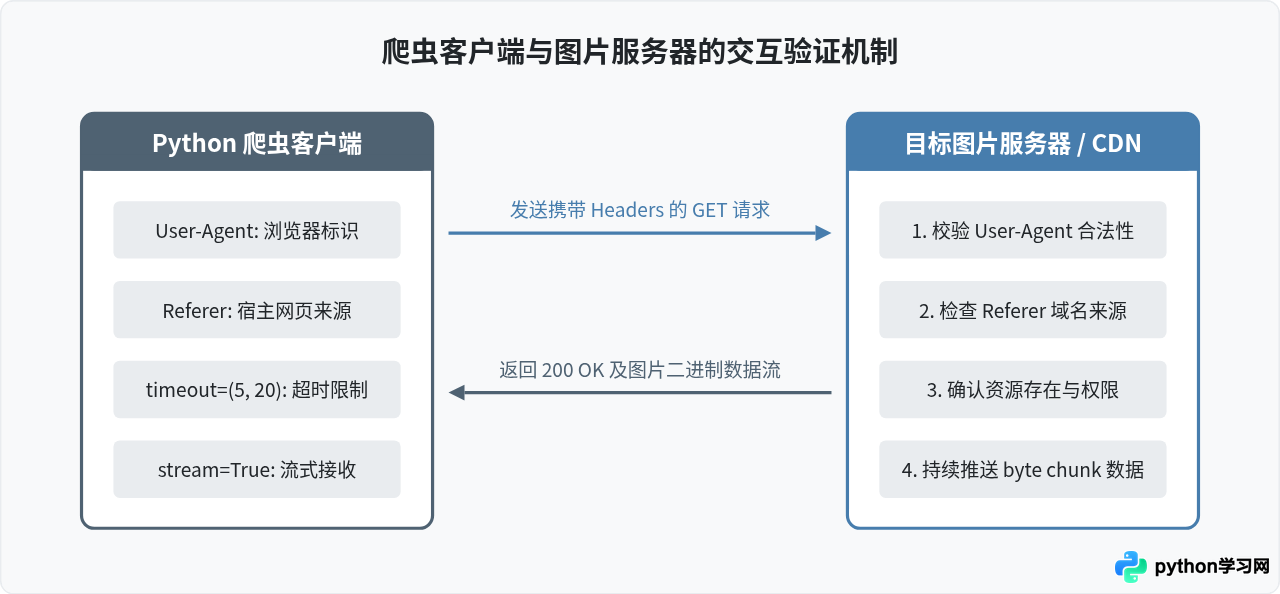
在实际抓取图片时,经常会遇到响应状态码为 403 Forbidden,或者下载下来的“图片”打开后提示文件损坏,甚至是一张印着“防盗链”字样的警告图。这通常是目标网站对图片请求进行了反爬限制:
- User-Agent 检查:requests 默认的请求头中包含
python-requests/x.x.x标识,目标服务器检测到非浏览器访问会直接拒绝。 - Referer 防盗链校验:网站服务器会检查 HTTP 请求头中的
Referer字段。如果该字段为空,或者域名不是自家网站,服务器便会判定为盗链请求而返回 403。 - 网络超时挂起:图片服务器偶尔响应迟缓,若不设置
timeout,程序可能会长时间卡在网络请求环节。
import requests

img_url = "https://static.example.com/photo/1024.jpg"
page_url = "https://example.com/gallery/article-1"

# 构造请求头,伪装浏览器身份并指定来源页
headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Referer": page_url  # 设置图片所在的文章或画廊页面地址
}

try:
    # 设置连接超时为 5 秒,读取超时为 20 秒
    response = requests.get(img_url, headers=headers, stream=True, timeout=(5, 20))
    response.raise_for_status()

    # 验证返回的内容确实为图片类型
    content_type = response.headers.get("Content-Type", "")
    if "image" not in content_type:
        print(f"警告:返回内容类型不是图片 ({content_type})")

    with open("1024.jpg", "wb") as f:
        for chunk in response.iter_content(chunk_size=8192):
            if chunk:
                f.write(chunk)
    print("下载成功")

except requests.exceptions.RequestException as e:
    print(f"网络请求出错: {e}")
工程化实战:路径补全、文件命名与异常封装
在编写完整的爬虫项目时,不能简单假定图片直链都是完整的绝对地址,也不能直接拿 URL 中的字符串当文件名。以下是下载函数中需要补充的工程化细节:
- 相对路径补全:很多网页在
img标签的src属性中写的是/static/images/logo.png这种相对路径。必须使用urllib.parse.urljoin()结合网页原 URL 转换为完整的绝对地址。 - 文件名提取与安全清理:图片 URL 中可能包含
?v=1.2.3等查询参数,或者文件名带有操作系统不允许的特殊符号。应当通过urllib.parse.urlsplit提取清晰的文件名,并在缺失扩展名时从响应头Content-Type中推导。 - 目标目录自动创建:利用
os.makedirs(..., exist_ok=True)确保保存目录存在,避免因路径不存在抛出FileNotFoundError。
import os
import requests
from urllib.parse import urlsplit, urljoin

def download_image(img_raw_url, base_page_url=None, save_dir="downloads"):
    """
    通用单张图片下载函数
    """
    # 1. 相对路径转绝对路径
    if base_page_url:
        full_url = urljoin(base_page_url, img_raw_url)
    else:
        full_url = img_raw_url

    # 2. 提取干净的文件名
    url_path = urlsplit(full_url).path
    filename = os.path.basename(url_path)
    if not filename or "." not in filename:
        filename = "downloaded_image.jpg"

    # 3. 确保目标文件夹存在
    os.makedirs(save_dir, exist_ok=True)
    save_path = os.path.join(save_dir, filename)

    # 4. 配置防盗链及身份伪装
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36",
        "Referer": base_page_url if base_page_url else full_url
    }

    # 5. 执行流式下载与落盘
    try:
        with requests.get(full_url, headers=headers, stream=True, timeout=(5, 20)) as resp:
            resp.raise_for_status()
            with open(save_path, "wb") as f:
                for chunk in resp.iter_content(chunk_size=8192):
                    if chunk:
                        f.write(chunk)
        print(f"成功保存: {save_path}")
        return True
    except Exception as e:
        print(f"下载失败 [{full_url}]: {e}")
        # 若产生不完整的空文件,及时清理
        if os.path.exists(save_path) and os.path.getsize(save_path) == 0:
            os.remove(save_path)
        return False

# 调用示例
if __name__ == "__main__":
    download_image("https://img.ipython.cn/uploads/2026/03/demo.png", "https://example.com/posts/item1")
requests.Session() 对象,这不仅能复用底层 TCP 连接提高吞吐率,还能自动维持 Cookie 与通用 Headers。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









