

Python中怎么判断一个对象是否属于序列类型
全面讲解在Python中判断对象是否属于序列类型的标准方法、底层原理与业务避坑指南。对比抽象基类Sequence、具象类型元组与协议检查的使用边界。
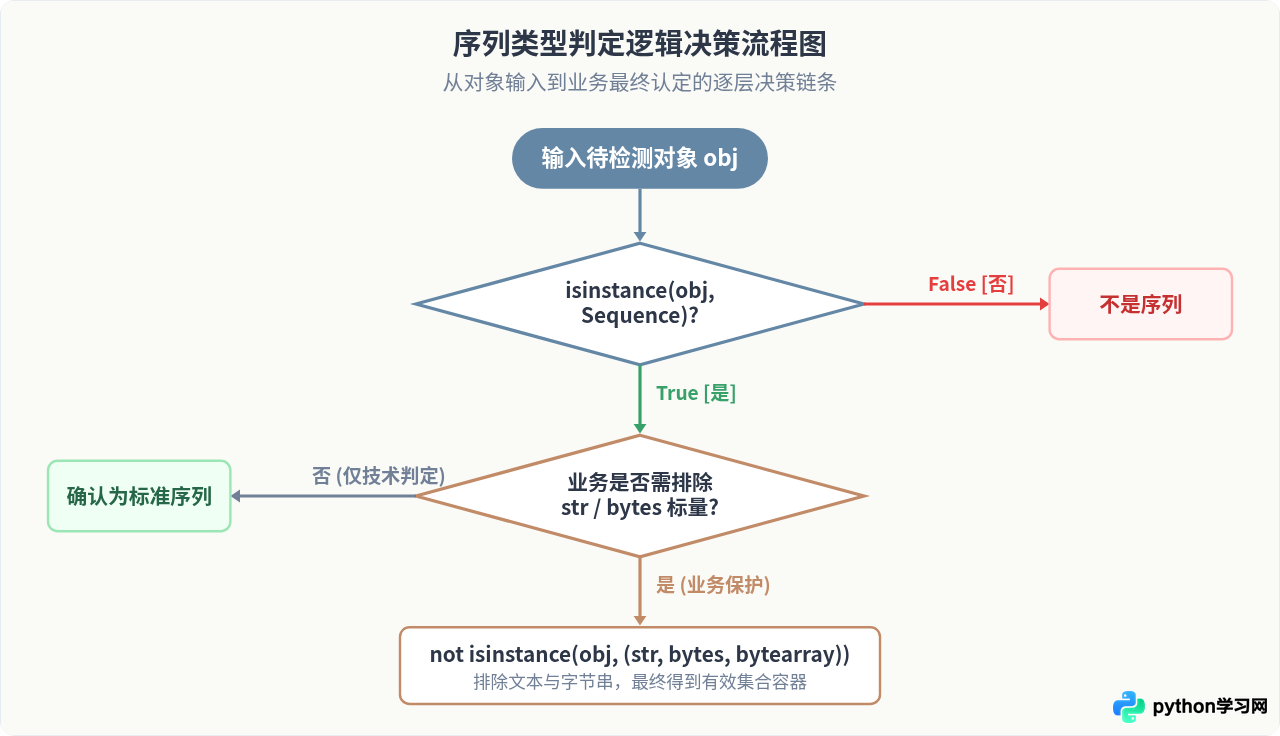
collections.abc.Sequence 配合 isinstance(obj, Sequence)。如果业务场景需要将字符串与字节串等文本序列当作单一值排除,只需追加 and not isinstance(obj, (str, bytes, bytearray)) 即可。
一、什么是Python中的序列类型
在Python中,“序列(Sequence)”并不是某一个具体的类,而是一类满足特定协议的数据结构的统称。一个对象要成为合法的序列类型,必须具备两个核心物理属性:
- 元素具有确定的线性顺序:支持通过从0开始的非负整数以及从-1开始的负整数下标访问元素,即实现了
__getitem__(index)。 - 具有明确的有限长度:可以通过内置函数
len()准确获取其所含元素的总数,即实现了__len__()。
除此以外,合法的序列类型还默认派生出切片操作(obj[start:stop:step])、成员包含检查(in)、反向遍历(reversed())以及查找与统计方法(index()、count())。
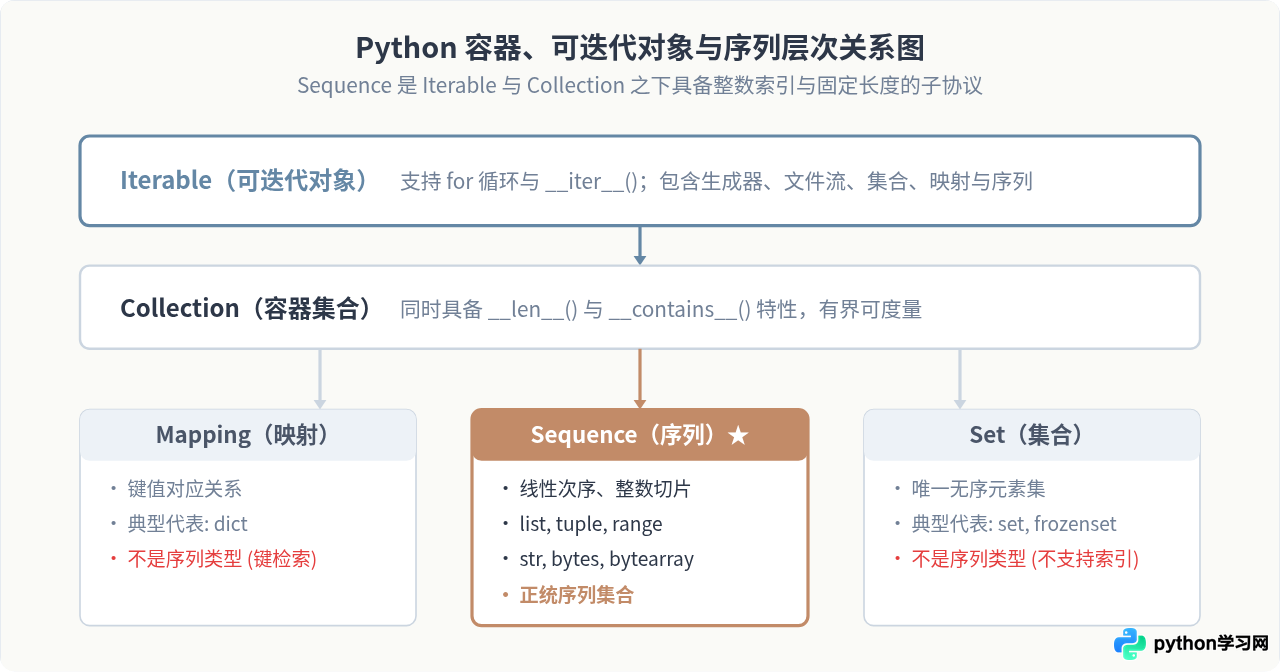
Python中常见的内置序列包括 list(列表)、tuple(元组)、range(区间)、str(字符串)、bytes(字节序列)以及 bytearray(字节数组)。与之相对,字典(dict)属于映射类型(Mapping),集合(set)属于集合类型(Set),而生成器(Generator)与迭代器只支持单向迭代、没有随机索引和长度,因此它们都不是序列。
二、标准解法:使用 collections.abc.Sequence
Python 官方在标准库 collections.abc 模块中提供了一套完善的抽象基类(Abstract Base Classes)。其中 collections.abc.Sequence 专门用于定义只读序列协议,collections.abc.MutableSequence 则代表可变序列(如 list)。
无论是内置类型还是遵循协议注册的自定义类,都可以通过 isinstance() 进行精确的序列身份判定:
from collections.abc import Sequence

# 测试各类常见对象
items_to_test = [
    [1, 2, 3],               # list
    (10, 20),                # tuple
    range(5),                # range
    "hello world",           # str
    b"raw bytes",            # bytes
    {"a": 1, "b": 2},         # dict (映射)
    {1, 2, 3},               # set (集合)
    (x * 2 for x in range(3)) # generator (生成器)
]

for item in items_to_test:
    is_seq = isinstance(item, Sequence)
    print(f"{str(type(item)):<35} -> {is_seq}")
运行输出结果示例:
<class 'list'>                      -> True
<class 'tuple'>                     -> True
<class 'range'>                     -> True
<class 'str'>                       -> True
<class 'bytes'>                     -> True
<class 'dict'>                      -> False
<class 'set'>                       -> False
<class 'generator'>                 -> False
关键避坑点:字符串也是序列类型
在技术定义上,str 和 bytes 确实是序列——它们有序、支持整数索引与切片。但在日常业务编程(如批量处理数据、API参数解析)中,开发者往往希望输入是一个由元素组成的“容器序列”(比如列表或元组),而把单一的字符串视为一个不可拆分的标量。
如果不做特殊处理,直接使用 isinstance(data, Sequence) 会让字符串通过检查,随后执行 for elem in data: 时,程序就会意外地按单个字符进行逐字拆分循环,从而引发难以排查的逻辑错误。
isinstance(obj, Sequence) and not isinstance(obj, (str, bytes, bytearray))
三、具象类型元组判断(轻量级替代方案)
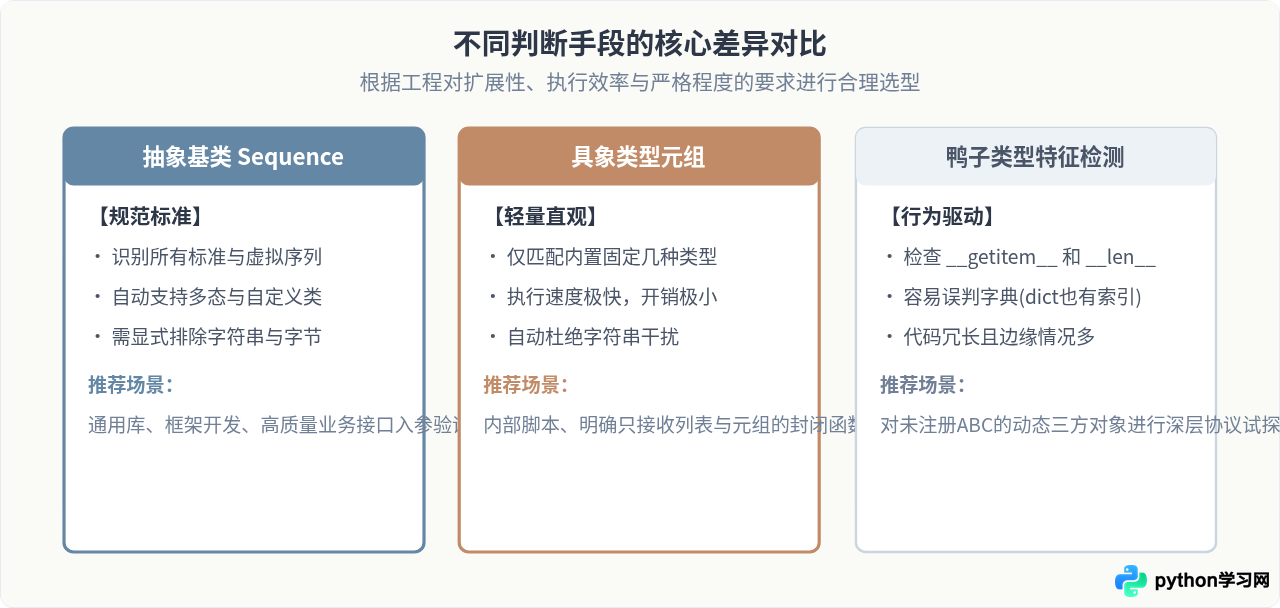
如果当前工程代码逻辑简单,或者你可以明确断定调用方只会传入Python内置的几种固定数据结构,可以直接使用具象类型元组传递给 isinstance():
# 仅检查最常见的列表与元组
def is_simple_sequence(obj):
    return isinstance(obj, (list, tuple))

# 或者涵盖 range
def is_builtin_sequence(obj):
    return isinstance(obj, (list, tuple, range))
该方案的优缺点非常鲜明:
- 优点:无需从模块中导入
collections.abc,CPU 指令级执行速度极快;天然自动排除了str和bytes,无需书写二次排除逻辑。 - 局限性:不具备可扩展性。如果第三方库传入了遵循序列协议的结构(如 NumPy 的
ndarray,Pandas 的Series,或自定义的链表、数据流包装器),具象类型检查将直接判定为False,导致代码的多态兼容性丧失。
四、深入鸭子类型:能否仅通过 hasattr 判断?
Python 崇尚“鸭子类型(Duck Typing)”哲学:“如果它走起来像鸭子,叫起来像鸭子,那它就是鸭子”。很多初学者会尝试直接检查对象是否具备某些魔术方法:
# 错误示范:仅检查是否包含 __getitem__
def bad_check(obj):
    return hasattr(obj, "__getitem__") and hasattr(obj, "__len__")

# 测试字典
user_dict = {"id": 101, "name": "Alice"}
print(bad_check(user_dict))  # 输出: True!但字典绝不是序列!
为什么单纯检测魔术方法会失败?
因为在 Python 协议中,dict 同样实现了 __getitem__(用于键检索)和 __len__(获取键值对数)。两者的根本差异在于参数语义:序列的 __getitem__ 只接收非负或负整数(以及 slice 切片对象);而映射(Mapping)的 __getitem__ 接收任意可哈希的键。
因此,如果要通过属性检查来做纯粹的鸭子类型判定,必须同时引入否定排除逻辑:
from collections.abc import Mapping

def is_duck_sequence(obj):
    return (
        hasattr(obj, "__getitem__")
        and hasattr(obj, "__len__")
        and not isinstance(obj, Mapping)
    )
由于手写鸭子检测规则容易遗漏细节(比如切片支持与负数索引行为),在绝大多数情况下,直接依赖经过社区充分验证的 collections.abc.Sequence 都是更优的选择。
五、让自定义类被正确识别为序列
当开发者自行编写数据容器(例如自定义分页器、时间序列数组或链表)时,有两种标准方式让自己的类被 isinstance(obj, Sequence) 正确识别:
方法 1:显式继承 collections.abc.Sequence(推荐)
继承基类后,只需要实现 __len__ 和 __getitem__ 这两个抽象方法,基类会自动通过混入(Mix-in)免费提供 __contains__、__iter__、__reversed__、index 和 count 的完整实现:
from collections.abc import Sequence

class NumberedRoster(Sequence):
    def __init__(self, members):
        self._members = list(members)

    def __len__(self):
        return len(self._members)

    def __getitem__(self, index):
        return self._members[index]

roster = NumberedRoster(["Alice", "Bob", "Charlie"])
print(isinstance(roster, Sequence))  # 输出: True
print("Bob" in roster)               # 输出: True (自动获得支持)
方法 2:注册为虚拟子类(Virtual Subclass)
如果不希望显式继承,可以使用 Sequence.register(MyClass) 将自定义类注册为虚拟子类。只要它在行为上实现了对应接口,isinstance() 就会返回 True。
六、常见误区与避坑全景总结
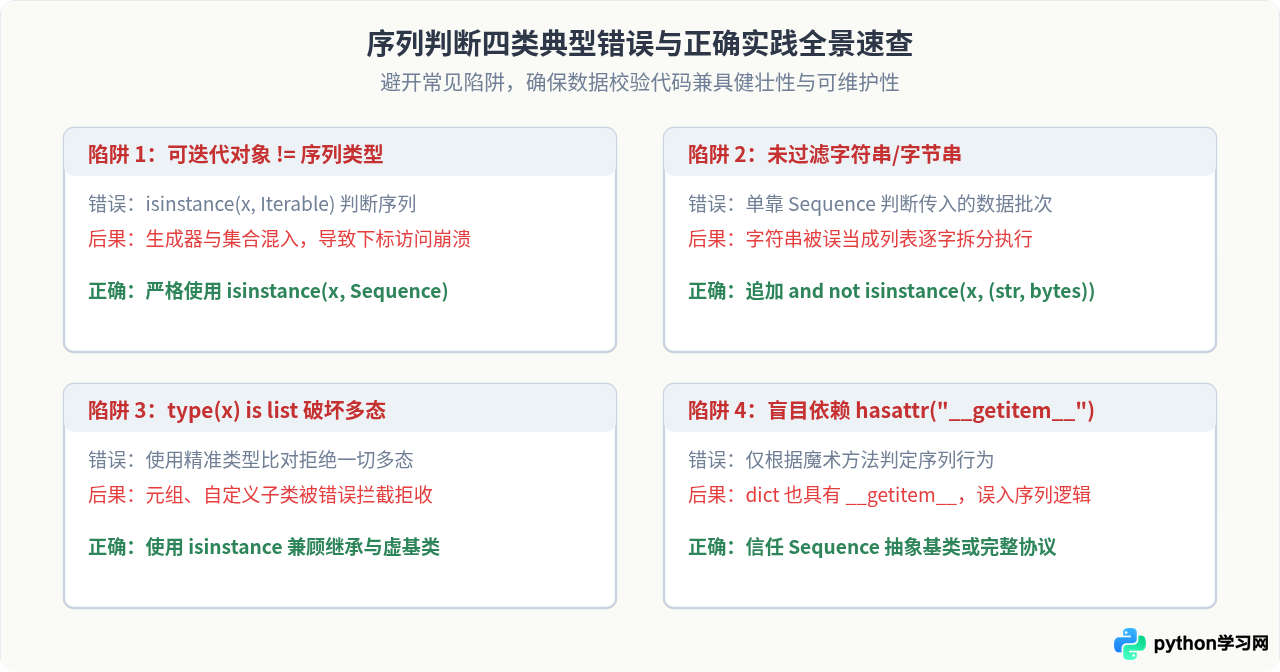
在编写判断逻辑时,开发者最常踩入四个误区:
- 混淆 Iterable(可迭代)与 Sequence(序列):认为只要能用
for遍历就是序列。生成器、文件句柄和集合都是可迭代对象,但它们不具备整数索引与随机读取能力,不能当作序列处理。 - 忽略字符串拆分风险:直接将
isinstance(x, Sequence)用于批处理,导致传入单个字符串时被拆解为单字符序列。 - 使用
type(obj) is list进行严格等值判断:这会彻底破坏面向对象的多态性,导致继承自列表的子类或第三方兼容类全部失效。 - 误判映射类型:仅凭
hasattr(obj, '__getitem__')误把字典当成序列传递。
常见对象类型检测速查表
| 测试对象类型 | isinstance(x, Iterable) | isinstance(x, Sequence) | isinstance(x, (list, tuple)) | 性质归属 |
|---|---|---|---|---|
list / tuple |
True | True | True | 正规容器序列 |
range |
True | True | False | 不可变惰性数值序列 |
str / bytes |
True | True | False | 文本/字节序列(常需业务排除) |
dict |
True | False | False | 键值映射类型(Mapping) |
set |
True | False | False | 无序集合类型(Set) |
generator |
True | False | False | 单向迭代器(无长度、无下标) |
七、总结
判断一个对象是否属于序列类型的最终决策规则如下:
- 标准工程与通用代码:始终优先使用
from collections.abc import Sequence与isinstance(obj, Sequence)。 - 业务数据批量处理:若需要确保元素是集合而非文本字串,请使用
isinstance(obj, Sequence) and not isinstance(obj, (str, bytes, bytearray))。 - 微型脚本与极速性能:如果只想允许常见集合,使用
isinstance(obj, (list, tuple, range))最为轻快省心。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









