

怎么在Python中将通配符模式转换为正则表达式
fnmatch.translate() 函数。该函数能够自动解析诸如 *、? 与字符集 [...] 等通配语法,并将其中涉及的正则特殊字符全部进行安全转义,输出可以直接交由 re.compile() 处理的标准正则表达式字符串。
1. 核心方法:使用 fnmatch.translate
通配符(Wildcard)常见于文件系统筛选和命令行交互中,例如 *.py 或 data_??.csv。而正则表达式(Regular Expression)则具备细粒度的字符控制与子模式捕获能力。当业务场景中既需要给普通用户提供直观的通配符输入界面,又需要在后端执行强大的正则匹配时,就必须将通配符转换为正则表达式。
Python 在标准库的 fnmatch 模块中直接内置了转换方法。我们不需要额外安装任何第三方依赖,直接引入 fnmatch 与 re 即可完成转换与匹配验证。
import fnmatch
import re

# 1. 定义用户通配符模式
wildcard_pattern = "*.txt"

# 2. 将通配符转换为正则表达式字符串
regex_pattern_str = fnmatch.translate(wildcard_pattern)
print("生成的正则表达式:", regex_pattern_str)
# 示例输出: (?s:.*\.txt)\Z

# 3. 编译生成的正则对象
regex = re.compile(regex_pattern_str)

# 4. 执行匹配判断
print(bool(regex.match("notes.txt")))      # 示例输出: True
print(bool(regex.match("notes.txt.bak")))  # 示例输出: False
print(bool(regex.match("readme.md")))      # 示例输出: False
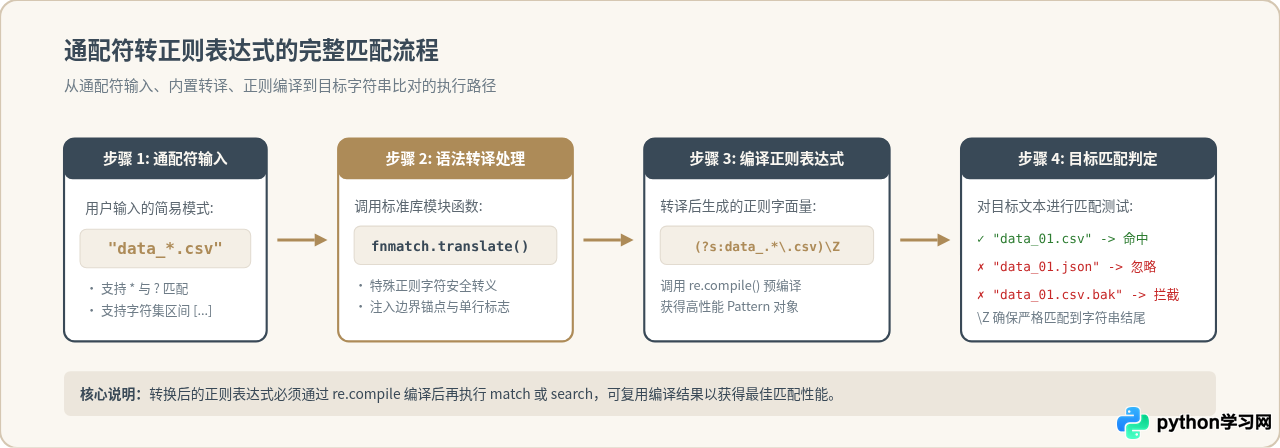
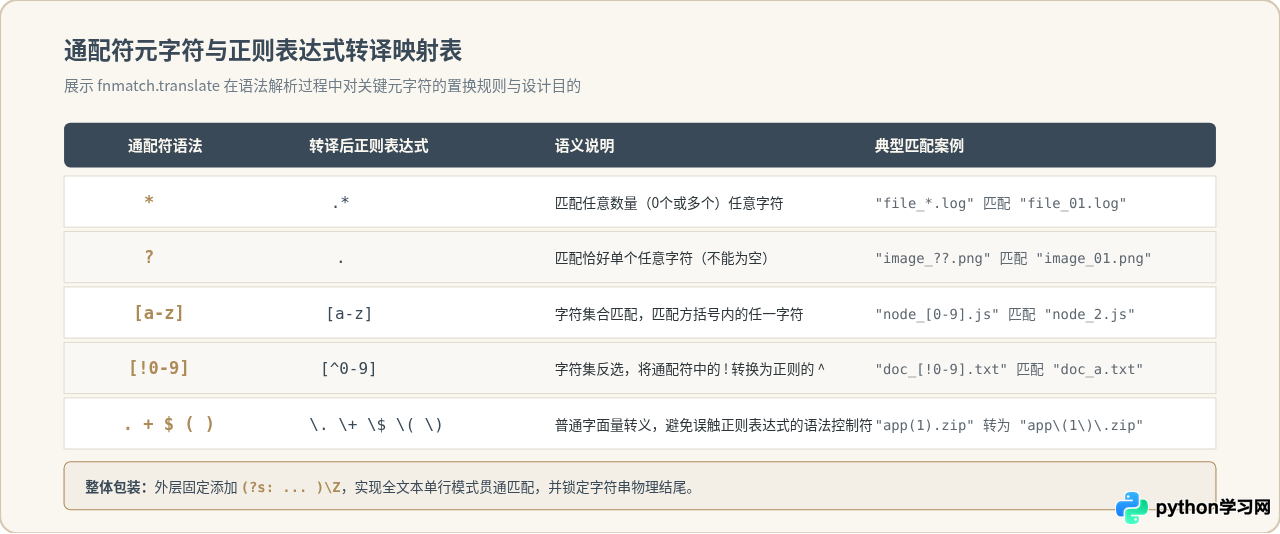
在这段代码中,fnmatch.translate("*.txt") 输出的表达式为 (?s:.*\.txt)\Z。可以看到,通配符中的点号 . 被自动加上了反斜杠转义成 \.,星号 * 转换成了任意字符匹配 .*,且整个表达式被严谨地包裹在单行模式组与字符串终止锚点中。
2. 理解转换生成的正则表达式结构
很多开发者在打印 fnmatch.translate() 的结果时,会发现生成的正则表达式看起来比预想的要复杂一些。例如在 Python 3.6 及更新版本中,*.py 转换后的结果并不是单纯的 .*\.py,而是 (?s:.*\.py)\Z。
这种设计背后有三个关键原因:
-
单行模式标志组
(?s:...):通配符中的*在语义上代表“任意数量的字符”。但在标准正则表达式中,默认的点号.是不会匹配换行符\n的。通过在外层包裹(?s:...),局部启用了re.DOTALL(即s标志位),使得.*能够真正跨越多行匹配任何字符。 -
严格结尾锚点
\Z:通配符匹配是“全量字符串匹配”,而不是“子串搜索”。如果没有结尾锚点,*.py就会错误地匹配script.py.bak。与常见的$相比,\Z更加严格——在启用多行模式时,$会在每行末尾换行处匹配,而\Z无论如何都只匹配整个字符串真正的终点。 -
特殊符号安全逃逸:像
+、$、^、(、)、{、}这些在正则表达式中具有特殊控制功能的元字符,如果在通配符中只是作为普通文件名出现,translate()会自动为其补充反斜杠转义。
3. 关键差异与注意事项:路径分隔符与大小写
在使用 fnmatch.translate() 时,有两个极易产生预期偏差的技术细节必须引起重视:
1. 路径分隔符跨目录问题
在 Unix Shell 或常见的 Glob 文件查找逻辑中,单星号 * 通常不会跨越目录路径分隔符(即不匹配 / 或 Windows 下的 \)。例如在文件系统 Glob 中,*.py 只能匹配当前目录下的脚本,不能匹配 sub/dir/test.py。
然而,fnmatch 最初的设计是基于纯字符串模式匹配的,其转换出的正则 .* 会直接把路径分隔符当作普通字符匹配。这意味着使用 fnmatch.translate("*.py") 编译出的正则去测试 "src/core/main.py" 时,结果依然是 True。
import fnmatch
import re

pattern = re.compile(fnmatch.translate("*.py"))
# 注意:在 fnmatch 规则下,以下判断均为 True
print(pattern.match("main.py"))               # True
print(pattern.match("src/module/worker.py"))  # 同样是 True
2. 大小写敏感控制
在 Windows 系统上,默认的文件系统是不区分大小写的;而在 Linux 系统上是严格区分大小写的。fnmatch.translate() 仅仅负责生成正则表达式文本,并不默认附加 re.IGNORECASE 标志。
如果你需要跨平台实现与操作系统行为一致的大小写匹配,应该在调用 re.compile() 时显式传入参数:
# 显式忽略大小写
case_insensitive_regex = re.compile(
    fnmatch.translate("*.PNG"),
    re.IGNORECASE
)
print(bool(case_insensitive_regex.match("photo.png")))  # True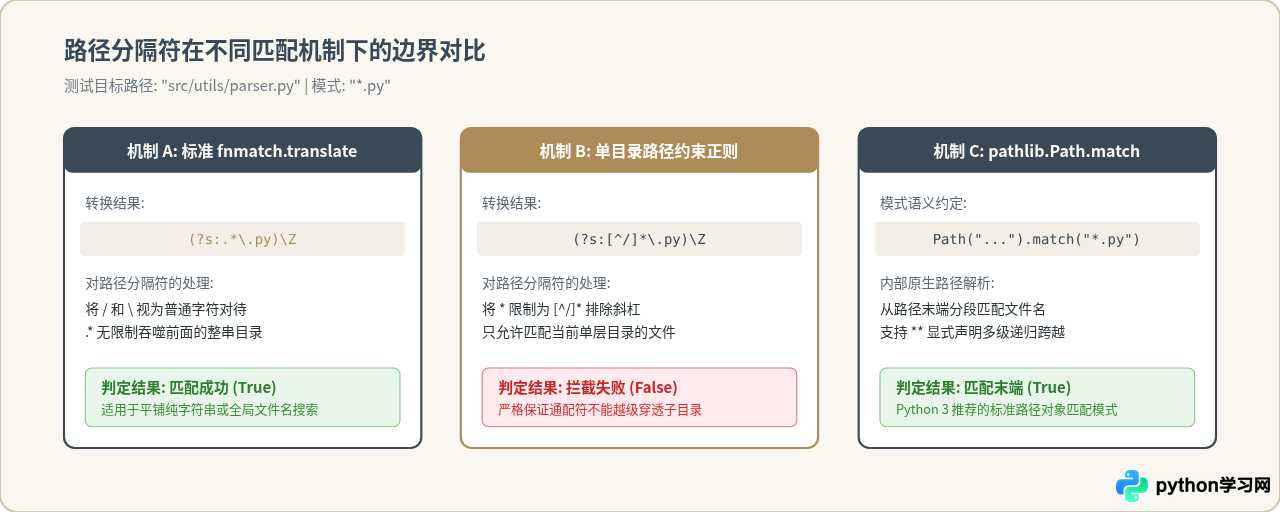
4. 定制化需求:编写自己的通配符转正则函数
在部分定制化业务中,标准库的 fnmatch.translate() 可能并不完全贴合需求。例如:
- 我们希望匹配单层目录,要求
*不能跨越/; - 我们希望支持 Glob 风格的双星号
**递归跨目录匹配; - 我们不希望自动加上
\Z终点锚点,以便在长文本中做局部模糊搜索。
遇到这类场景时,我们可以自行编写一个轻量级的纯 Python 转译函数。实现核心在于利用 re.escape 处理普通文本,逐字解析语法标记:
import re

def custom_wildcard_to_regex(pattern: str, path_mode: bool = False, full_match: bool = True) -> str:
    """
    自定义通配符转正则表达式
    :param pattern: 原始通配符字符串
    :param path_mode: 是否为路径模式(True 时单星号不跨越目录 /)
    :param full_match: 是否要求全量匹配(注入首尾锚点)
    :return: 对应的正则表达式字符串
    """
    i, n = 0, len(pattern)
    res = []

    while i < n:
        c = pattern[i]
        i += 1

        if c == '*':
            # 检查是否为 ** 递归跨目录匹配
            if path_mode and i < n and pattern[i] == '*':
                i += 1
                # 跳过后续可能连带的分隔符
                if i < n and pattern[i] == '/':
                    i += 1
                    res.append('(?:.*/)?')
                else:
                    res.append('.*')
            elif path_mode:
                # 路径模式下单星号仅匹配非斜杠字符
                res.append('[^/]*')
            else:
                res.append('.*')
        elif c == '?':
            if path_mode:
                res.append('[^/]')
            else:
                res.append('.')
        elif c == '[':
            # 查找字符集闭合方括号
            j = i
            if j < n and pattern[j] == '!':
                j += 1
            if j < n and pattern[j] == ']':
                j += 1
            while j < n and pattern[j] != ']':
                j += 1
            if j >= n:
                res.append(r'\[')
            else:
                stuff = pattern[i:j].replace('\\', '\\\\')
                i = j + 1
                if stuff.startswith('!'):
                    stuff = '^' + stuff[1:]
                elif stuff.startswith('^'):
                    stuff = r'\^' + stuff[1:]
                res.append(f'[{stuff}]')
        else:
            # 普通字符使用 re.escape 安全逃逸
            res.append(re.escape(c))

    regex_body = "".join(res)
    if full_match:
        return f"^{regex_body}$"
    return regex_body

# 示例验证:
print(custom_wildcard_to_regex("*.py", path_mode=True))
# 输出: ^[^/]*\.py$

print(custom_wildcard_to_regex("src/**/*.py", path_mode=True))
# 输出: ^src/(?:.*/)?.*\.py$ (支持多层目录跨越)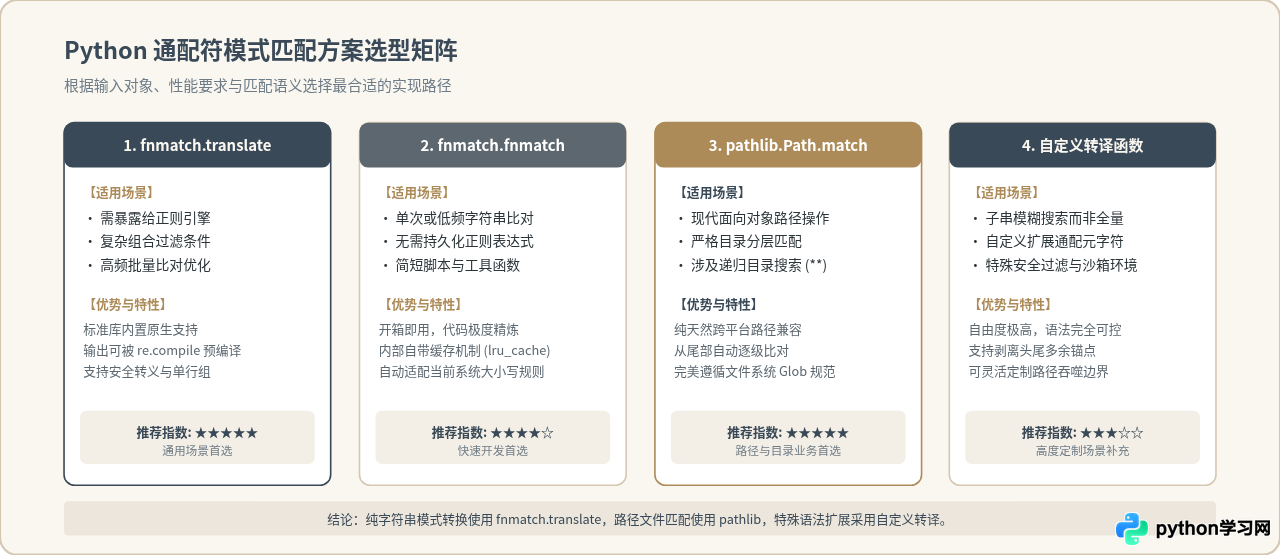
5. 性能优化与生产实践建议
在处理大批量文件过滤或日志分析任务时,模式转换的执行开销同样需要被纳入考量:
-
避免在循环内部重复调用
translate()和compile(): 虽然fnmatch.fnmatch()内部维护了一个小型的模式缓存表(通常大小为 256 或 512),但在处理数万个甚至百万个数据项时,提前在循环外通过re.compile(fnmatch.translate(pat))编译好正则对象,在循环内直接调用pattern.match(),吞吐量通常会有数倍至数十倍的明显提升。 -
多模式组合匹配优化:
如果用户提供了多个通配符(例如同时允许
*.jpg、*.png、*.webp),不要针对每个模式分别进行正则匹配。更好的做法是将转换后的各子模式使用管道符|组合为一个联合正则:
import fnmatch
import re

wildcards = ["*.jpg", "*.png", "*.gif", "*.webp"]

# 提取核心部分并组合成单个联合正则表达式
# 每个模式去掉外部的 (?s: 和 )\Z,合并后再重新锚定
sub_patterns = [fnmatch.translate(w)[4:-3] for w in wildcards]
combined_regex_str = rf"(?s:(?:{'|'.join(sub_patterns)}))\Z"

combined_pattern = re.compile(combined_regex_str, re.IGNORECASE)

# 仅需单次匹配即可判断所有图片后缀
print(bool(combined_pattern.match("avatar.PNG")))   # True
print(bool(combined_pattern.match("banner.webp")))  # True
print(bool(combined_pattern.match("archive.zip"))) # Falsefnmatch.translate()。理解其生成的 (?s:...) 与 \Z 结构,注意路径分隔符与操作系统大小写的匹配边界,并在批量比对场景中保持预编译习惯,即可兼顾通配符的易用性与正则表达式的高性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









