

Python subprocess模块原理与实战:子进程与管道通信详解

发布时间:2026-10-13| 6人浏览过
本文深入解析Python中subprocess模块的工作原理,对比sys.system的局限性,阐述子进程创建与管道通信机制。通过Popen类实例演示如何调用系统命令、处理标准输出与错误流,并解析字节编码转换,帮助开发者高效掌握进程管理与结果获取技巧。
subprocess模块原理与实战:子进程执行与管道通信机制
前言
sys.system与subprocess的执行差异
在Python中,除了subprocess模块外,sys模块也提供了执行系统命令的能力。然而,sys.system的执行方式存在明显缺陷:它直接通过主进程同步执行命令。如果该命令耗时较长(例如需要运行一小时),主进程将被阻塞,无法执行其他任务,从而导致整体程序运行效率低下。
子进程创建与管道通信机制
相比之下,subprocess模块采用异步执行策略。当调用subprocess执行系统命令时,主进程会创建一个独立的子进程来负责命令的执行,主进程则继续执行后续逻辑,互不干扰。由于不同进程的内存空间相互独立,无法直接访问对方数据,subprocess引入了“管道”机制来解决数据交互问题。管道本质上是一块共享内存区域,子进程将命令执行结果写入管道,主进程即可从该共享空间中读取数据,从而实现进程间的有效通信。
subprocess基本工作原理
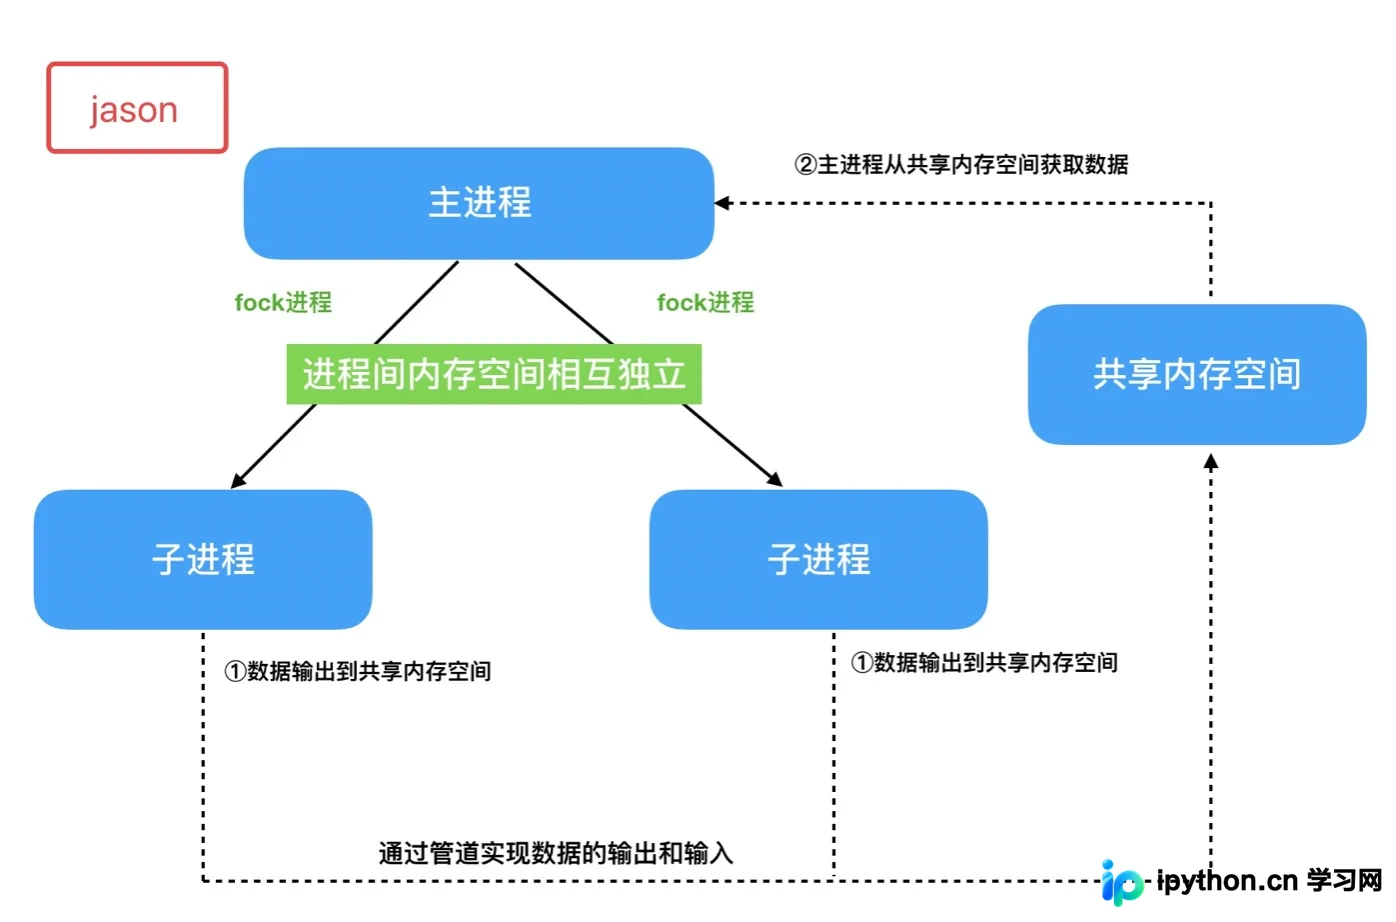
subprocess简单案例
Popen类调用系统命令实例
import subprocess
# 创建一个子进程去执行系统命令
obj=subprocess.Popen(
  'ps -ef',    # 执行的系统命令(必须是字符串格式)
  shell=True,   # 指定命令解释器来解释执行的这条命令
  stdout=subprocess.PIPE, # 将执行的正确结果丢到管道(共享内存空间,用于进程之间共享)
  stderr=subprocess.PIPE # 将执行的错误结果丢到另一个新的管道
)

'''
当从任意一个管道,例如正确或者错误结果管道中获取值,
'''

# 从正确管道中获取值
res=obj.stdout.read() # 主进程去管道里获取正确的结果
print(res.decode('utf-8')) # 获取的结果是bytes类型,需要指定decode指定编码

# 从错误管道中获取值
res2=obj.stderr.read()
print(res2.decode('utf-8'))
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









