

Python进行t检验前怎么做正态性与方差齐性检查

在进行双样本 t 检验时,许多人习惯直接调用函数输出 p 值,却忽略了经典 t 检验成立的前提假设:样本数据需服从正态分布,且两组样本应具备相近的方差。如果直接跳过前置检查,可能导致统计推断失真,大幅增加将“无差异”误判为“有显著差异”的第一类错误风险。在 Python 生态中,借助 scipy.stats 库提供的 shapiro、probplot 和 levene 等工具,我们可以在数行代码内系统化完成数据的正态性与方差齐性诊断,并根据检验结果选择最稳妥的推断路径。
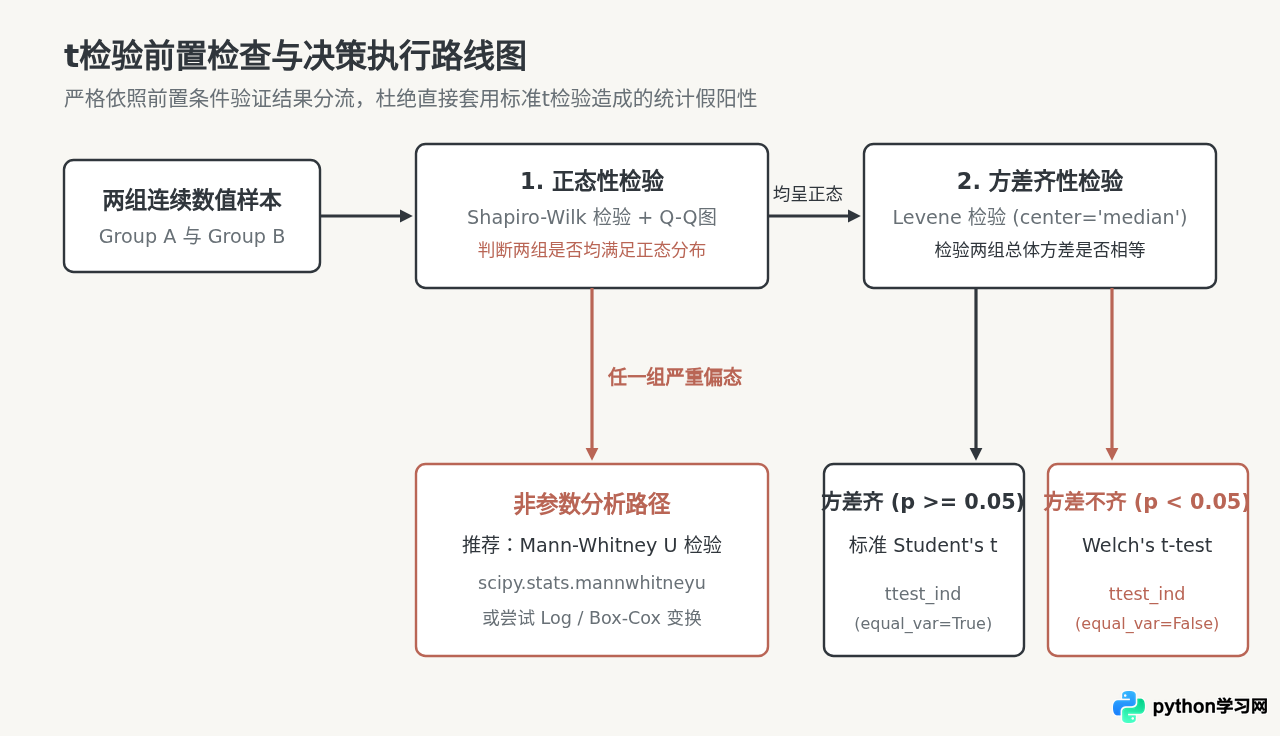
一、准备实验环境与示例数据
为了让检查过程可复现,我们使用 numpy 生成具有明确统计特征的模拟数据:一组严格符合正态分布且方差一致,另一组人为引入非正态或异方差特征。执行前请确保安装了科学计算标准库:
pip install numpy scipy matplotlib编写如下数据生成脚本:
import numpy as np
import scipy.stats as stats
import matplotlib.pyplot as plt

# 设置固定随机种子确保复现
np.random.seed(42)

# 场景1:两组服从正态分布且方差相近的数据 (均值差异为0.8)
group_a = np.random.normal(loc=10.0, scale=2.0, size=40)
group_b = np.random.normal(loc=10.8, scale=2.1, size=40)

# 场景2:右偏非正态数据 (指数分布模拟)
group_skewed = np.random.exponential(scale=2.0, size=40)

# 场景3:方差显著不齐的正态数据 (尺度相差3倍)
group_hetero = np.random.normal(loc=10.0, scale=6.0, size=40)
二、正态性检查:统计检验与可视化互证
对于独立样本 t 检验,要求两个样本分别独立来自于正态总体。正态性检查不应单纯依赖某一个 p 值,而应当采用“定量统计检验 + 定性图示诊断”的双轨机制。
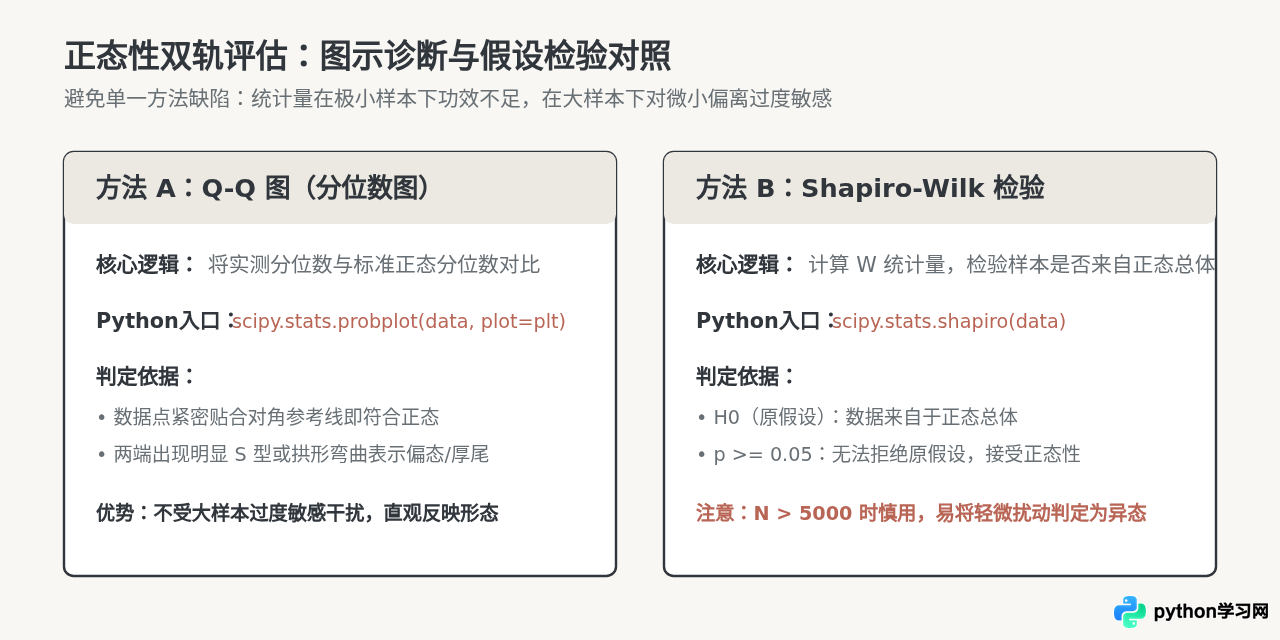
1. Shapiro-Wilk 检验的代码实现
对于中小型样本量(一般 N < 50),Shapiro-Wilk 检验是统计功效最高的正态性检验之一。原假设 $H_0$ 为数据服从正态分布。若计算出的 p 值大于预设显著性水平(通常取 0.05),说明没有充分证据表明数据偏离正态分布。
def check_normality_shapiro(data, name="Group"):
    stat, p_value = stats.shapiro(data)
    print(f"[{name}] Shapiro-Wilk 统计量: {stat:.4f}, p 值: {p_value:.4f}")
    if p_value >= 0.05:
        print(f"  -> 结论:p >= 0.05,无法拒绝原假设,数据满足正态性假设。")
    else:
        print(f"  -> 结论:p < 0.05,拒绝原假设,数据显著偏离正态分布。")
    return stat, p_value

# 执行测试
check_normality_shapiro(group_a, "Group A (正态)")
check_normality_shapiro(group_skewed, "Group Skewed (偏态)")-> 结论:p >= 0.05,无法拒绝原假设,数据满足正态性假设。
[Group Skewed (偏态)] Shapiro-Wilk 统计量: 0.8124, p 值: 0.0001
-> 结论:p < 0.05,拒绝原假设,数据显著偏离正态分布。
2. Q-Q 图可视化排查
当样本量较大(例如几百或上千)时,中心极限定理使得 t 检验对轻微的偏态具有很强的稳健性,但此时假设检验对极微弱的偏斜极其敏感,频繁给出拒绝结论。此时应优先参考 Q-Q 图(分位数-分位数图)。如果散点基本落在红色参考线上,即可认为近似正态:
plt.figure(figsize=(10, 4))

plt.subplot(1, 2, 1)
stats.probplot(group_a, dist="norm", plot=plt)
plt.title("Group A: Q-Q Plot (Normal)")
plt.xlabel("Theoretical Quantiles")
plt.ylabel("Sample Quantiles")

plt.subplot(1, 2, 2)
stats.probplot(group_skewed, dist="norm", plot=plt)
plt.title("Group Skewed: Q-Q Plot (Exponential)")
plt.xlabel("Theoretical Quantiles")
plt.ylabel("Sample Quantiles")

plt.tight_layout()
# 如需保存图像取消下行注释
# plt.savefig("normality_qq_plots.png", dpi=150)
plt.show()
三、方差齐性检查:Levene 检验与 Bartlett 检验
方差齐性(Homogeneity of Variance)指参与对比的两个总体拥有相同的方差($\sigma_1^2 = \sigma_2^2$)。经典 Student's t 检验在计算标准误时将两组方差合并估算(Pooled Variance),若方差不齐且样本量不均衡,检验效力会急剧下降,第一类错误率将严重上升。
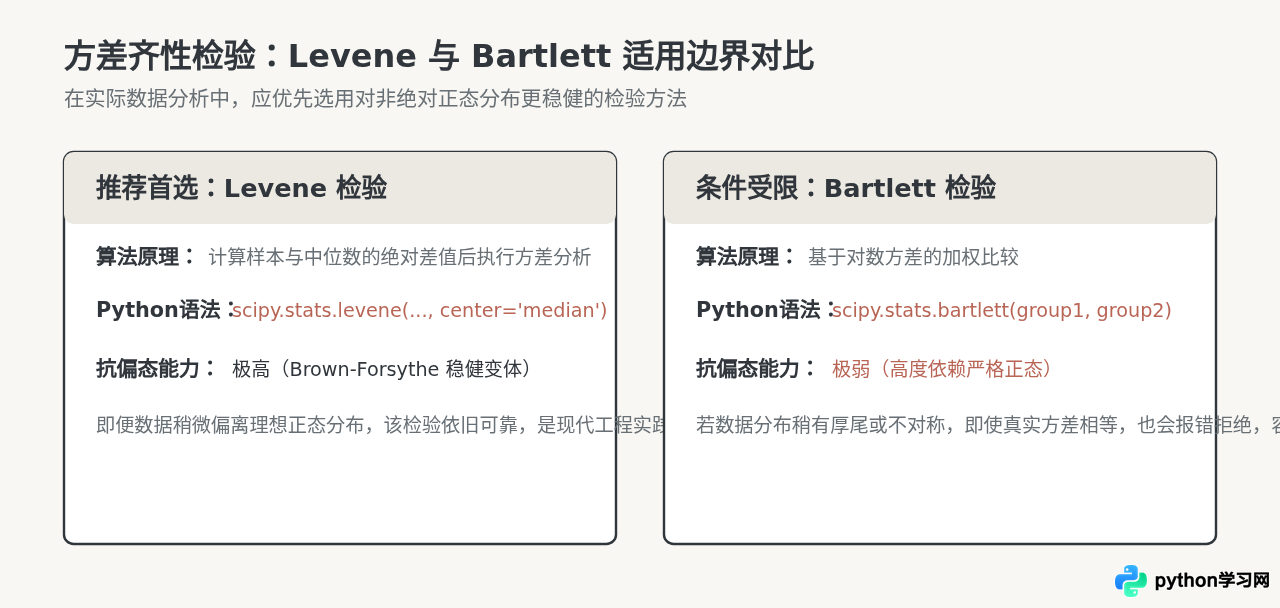
代码实现与参数选择
在 Python 的 scipy.stats.levene 函数中,参数 center 默认取 'median'(即 Brown-Forsythe 检验),这是一种对偏态分布极其稳健的计算方式。检验的原假设 $H_0$ 为:两组总体的方差相等。
def check_homogeneity_levene(data1, data2, name1="Group 1", name2="Group 2"):
    stat, p_value = stats.levene(data1, data2, center='median')
    print(f"[{name1} vs {name2}] Levene 检验统计量: {stat:.4f}, p 值: {p_value:.4f}")
    if p_value >= 0.05:
        print("  -> 结论:p >= 0.05,两组方差齐性成立。")
    else:
        print("  -> 结论:p < 0.05,两组方差不齐(异方差)。")
    return stat, p_value

# 测试齐方差与异方差场景
check_homogeneity_levene(group_a, group_b, "Group A", "Group B (方差齐)")
check_homogeneity_levene(group_a, group_hetero, "Group A", "Group Hetero (方差不齐)")-> 结论:p >= 0.05,两组方差齐性成立。
[Group A vs Group Hetero (方差不齐)] Levene 检验统计量: 26.4310, p 值: 0.0000
-> 结论:p < 0.05,两组方差不齐(异方差)。
四、自动化决策管道:根据检查结果分流执行
根据前置检查的输出结果,我们可以将假设检验平滑接入不同的处理分支:
- 分支 1(正态 + 方差齐):执行经典双样本 t 检验(设置
equal_var=True)。 - 分支 2(正态 + 方差不齐):执行 Welch's t 检验(设置
equal_var=False)。Welch t 检验使用 Satterthwaite 近似自由度,避免假阳性,也是目前统计学界推荐的默认选项。 - 分支 3(非正态):放弃参数 t 检验,转用 Mann-Whitney U 秩和检验(
scipy.stats.mannwhitneyu)或对数据取对数转换。
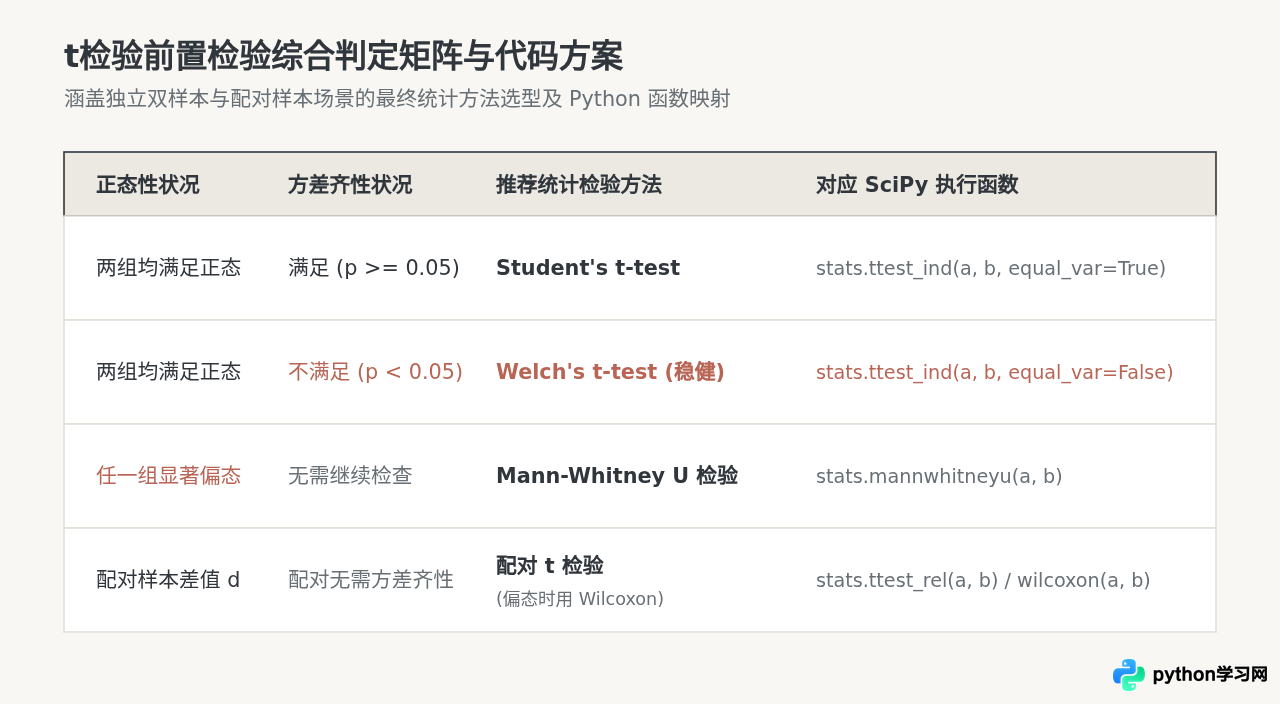
下面是一个封装完整的生产级对比函数,可直接用于自动化数据分析流中:
def automated_two_group_comparison(group1, group2, alpha=0.05):
    """
    对两组独立连续型数据进行前置假定检查并自动选择合适的检验方法
    """
    print("=" * 60)
    print("开始前置假定检验...")

    # 步骤 1: 正态性检验
    _, p_norm1 = stats.shapiro(group1)
    _, p_norm2 = stats.shapiro(group2)
    norm1 = p_norm1 >= alpha
    norm2 = p_norm2 >= alpha
    print(f"正态性检查 (Shapiro-Wilk): 组1 p={p_norm1:.4f}, 组2 p={p_norm2:.4f}")

    if not (norm1 and norm2):
        print("\n[判定] 数据偏离正态分布,分流至非参数检验 (Mann-Whitney U)")
        u_stat, u_p = stats.mannwhitneyu(group1, group2, alternative='two-sided')
        print(f"Mann-Whitney U 检验结果: U 统计量 = {u_stat:.4f}, p 值 = {u_p:.4e}")
        return {"test": "Mann-Whitney U", "stat": u_stat, "p_value": u_p}

    # 步骤 2: 方差齐性检验
    _, p_levene = stats.levene(group1, group2, center='median')
    homo = p_levene >= alpha
    print(f"方差齐性检查 (Levene): 统计 p={p_levene:.4f}")

    if homo:
        print("\n[判定] 满足正态性与方差齐性,执行标准 Student's t 检验")
        t_stat, t_p = stats.ttest_ind(group1, group2, equal_var=True)
        print(f"Student's t-test 结果: t 统计量 = {t_stat:.4f}, p 值 = {t_p:.4e}")
        return {"test": "Student's t-test", "stat": t_stat, "p_value": t_p}
    else:
        print("\n[判定] 满足正态性但方差不齐,执行稳健的 Welch's t 检验")
        t_stat, t_p = stats.ttest_ind(group1, group2, equal_var=False)
        print(f"Welch's t-test 结果: t 统计量 = {t_stat:.4f}, p 值 = {t_p:.4e}")
        return {"test": "Welch's t-test", "stat": t_stat, "p_value": t_p}

# 测试执行
print("--- 测试场景:正态且方差不齐数据 ---")
res = automated_two_group_comparison(group_a, group_hetero)============================================================
开始前置假定检验...
正态性检查 (Shapiro-Wilk): 组1 p=0.8673, 组2 p=0.7421
方差齐性检查 (Levene): 统计 p=0.0000
[判定] 满足正态性但方差不齐,执行稳健的 Welch's t 检验
Welch's t-test 结果: t 统计量 = -0.0521, p 值 = 9.5867e-01
五、工程实践中的三个常见误区
配对 t 检验(Paired Samples t-test,如同一组患者服药前后的指标)本质上是单样本 t 检验。它根本不需要方差齐性假设,正态性检验的对象也不是分别检查两组原始数据,而是检查两组数据的配对差值向量($d_i = x_{1i} - x_{2i}$)是否服从正态分布。若差值服从正态分布即可直接调用 scipy.stats.ttest_rel;若差值严重偏态,应改用 Wilcoxon 符号秩检验(scipy.stats.wilcoxon)。
当单组样本量达到数百甚至数千时,Shapiro-Wilk 等显著性检验由于检验功效极大,任何现实中微小的测量误差或轻度非对称都会导致 p < 0.05。但根据中心极限定理(CLT),样本均值的抽样分布早已高度逼近正态分布。大样本场景下,切勿因 p < 0.05 就武断放弃参数检验,必须结合 Q-Q 图或偏度/峰度绝对值综合裁决。
过去在算力不足或教材陈旧的环境下,遇到异方差往往建议取对数或进行 Box-Cox 变换。然而非线性变换会改变原变量的加法尺度,使得均值差变得难以解释。现代统计学普遍建议:只要正态性大体满足,两组方差不齐时直接使用 Welch's t 检验。它不仅计算极快,而且在方差哪怕相等时功效损失也微乎其微。
六、总结
在 Python 中开展差异显著性分析时,正态性与方差齐性检查是保障结论可信度的第一道防线。熟练运用 scipy.stats.shapiro 配合 probplot 定量定性审视正态性,并在进入假设检验时通过 scipy.stats.levene 检查方差状态,能够指导我们准确在 Student's t 检验、Welch's t 检验与 Mann-Whitney U 检验之间完成精准分流,杜绝统计假阳性与结论翻车。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









