

初学者学Python能从事哪些工作
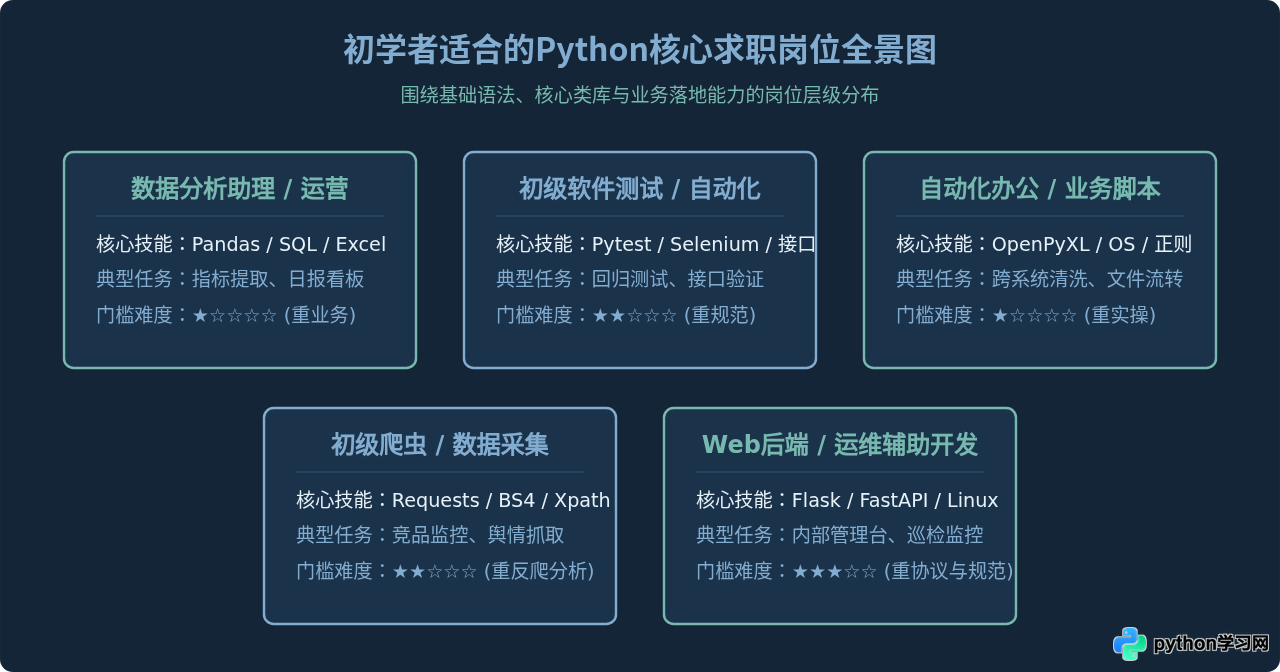
学完Python基础语法、掌握基本数据结构和常用标准库后,初学者往往面临一个实际问题:自己掌握的代码能力到底能在招聘市场中对应哪些真实岗位?实际上,初学者不具备独立设计分布式大型系统或训练深层算法模型的能力,但借助Python极高的人机协作效率与丰富的工具生态,完全可以在“数据分析助理”、“自动化测试”、“办公自动化及业务流程支持”、“初级爬虫/数据采集”以及“初级Web后端辅助开发”等方向实现就业入局。
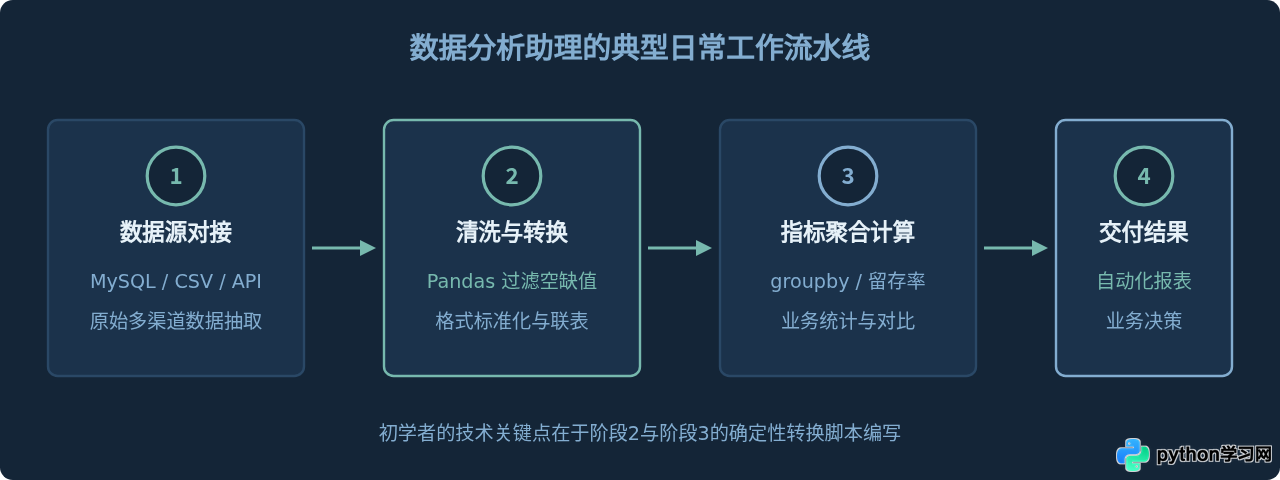
一、初级数据分析师与数据运营
在所有技术与半技术岗位中,初级数据分析和数据运营是初学者需求量最大、转化门槛相对清晰的方向。很多企业的核心业务每天都会产生数万条销售订单、用户点击日志或仓储出入库记录。传统办公人员依赖手工处理Excel极易出现卡顿、公式混乱和错误,而初学者只要掌握Python的基础数据分析栈,就能显著提升处理速度。
1. 核心职责
- 数据提取与合并:从内部数据库(使用SQL或ORM库)抽取多张业务表,将不同来源的分散数据按统一键值合并。
- 缺失值与脏数据清洗:剔除重复提交记录,处理空值,转换日期格式,修正字段拼写偏差。
- 报表自动化输出:按周、月周期自动计算核心KPI指标(如客单价、转化率、留存率),生成可视化图表并输出为固定模板的Excel或PDF。
2. 所需核心技能
该方向不需要初学者精通高深的数学建模与机器学习算法,关键在于熟练调用成熟类库:
- 基础容器与逻辑:掌握列表切片、字典嵌套与推导式,处理基本的分组逻辑。
- 核心库Pandas与NumPy:熟练使用
DataFrame的groupby、merge、pivot_table和条件过滤。 - SQL基础查询:能够熟练编写多表JOIN、WHERE过滤及聚合统计语句。
二、初级软件测试与自动化测试助理
很多互联网团队和传统软件企业的质量保障团队(QA)长期需要补充初级测试人员。纯手动点工(功能测试)薪资与成长受限,而具备Python基础脚本能力的候选人更容易胜任自动化回归与接口测试。
1. 核心工作内容
- 接口测试脚本开发:使用
requests库针对后端HTTP/RESTful接口编写批量测试用例,校验状态码、响应体字段及业务逻辑返回。 - 自动化UI回归测试:在每次发布版本前,通过
Selenium或Playwright自动驱动浏览器登录、点击主要流程并抓取截图,确保主链路未发生异常断裂。 - 测试报告汇总:利用
pytest框架生成自动化测试执行日志和HTML测试报告,推送到企业内部通知群。
2. 初学者进入门槛
这个岗位的优势在于不需要深入编写底层业务架构,逻辑边界非常清晰——“输入特定数据,验证输出是否与预期一致”。只要具备良好的细节关注度、基础的断言知识和异常捕获能力,初学者在系统学习2至3周的自动化测试框架后即可胜任初级执行工作。
三、自动化办公与业务脚本开发
这一类工作常见于非纯研发企业,例如电商公司、外贸企业、金融信贷机构、物流供应链以及中大型企业的运营与财务支撑部门。岗位名称往往不是“Python开发工程师”,而是“运营分析师”、“业务支持专员”或“流程自动化助理”。
1. 典型应用场景
业务部门每天都有大量跨系统的繁琐机械操作:从ERP系统导出数千个订单表格,按业务员分类并生成特定格式的汇总表;或者定时登录邮箱下载供应商发票,提取发票信息后归档至指定网盘。初学者编写的数十行Python脚本,就能替代数小时的人工录入。
# 自动化处理示例:多Excel订单批量汇总至统一报表
import glob
import pandas as pd

def merge_daily_reports(input_dir, output_file):
    excel_files = glob.glob(f"{input_dir}/*.xlsx")
    all_data = []

    for file_path in excel_files:
        df = pd.read_excel(file_path)
        # 清除未付款订单并补充文件归属标记
        valid_df = df[df['status'] == 'PAID'].copy()
        valid_df['source_file'] = file_path
        all_data.append(valid_df)

    final_report = pd.concat(all_data, ignore_index=True)
    final_report.to_excel(output_file, index=False)
    print(f"合并完成,共汇总 {len(final_report)} 条有效数据")
这种能力的价值在于直接且立即可见。很多初学者正是通过为业务部门编写自动化脚本建立起信任,随后顺利转为专职技术岗或业务系统维护人员。
四、初级网络爬虫与数据采集
数据是人工智能与商业决策的基础原料。电商价格监控、房产行情分析、竞品舆情跟踪等领域均需要稳定的外部数据采集机制。初级爬虫工程师负责在合法合规的前提下,将公开网络中的半结构化文本提取成结构化数据库。
robots.txt协议,严禁针对个人隐私数据、未授权登录数据进行抓取,避免给目标服务器造成高并发冲击。
初学者适合从“公开静态页面解析”和“轻量级JSON接口抓取”入手。掌握requests发送网络请求、使用BeautifulSoup或lxml解析HTML节点、利用正则表达式清洗字段,即可完成大部分常规采集任务。针对复杂验证码和高频反爬的高级对抗,则属于资深工程师范畴,初学者不必一开始以此为门槛。
五、初级Web后端与运维自动化辅助
在研发团队中,初学者通常不会直接接手核心高并发系统的架构设计,但在内部后台系统、工单流转平台以及轻量级工具API的搭建上,存在明确的分工需求。
- 微服务与内部工具:使用轻量级框架(如
Flask或FastAPI)为公司内部运营或数据团队编写数据查询、表单提交的小型Web接口。 - 运维巡检脚本:编写定时脚本检测生产服务器的磁盘占用率、内存使用情况以及网络延迟,并将告警信息通过Webhook推送到钉钉或企微。
- 日志归档与分析:定期将Nginx访问日志中非200状态码的异常IP及请求路径提炼成排错报告。
六、初学者求职的现实局限与避坑建议
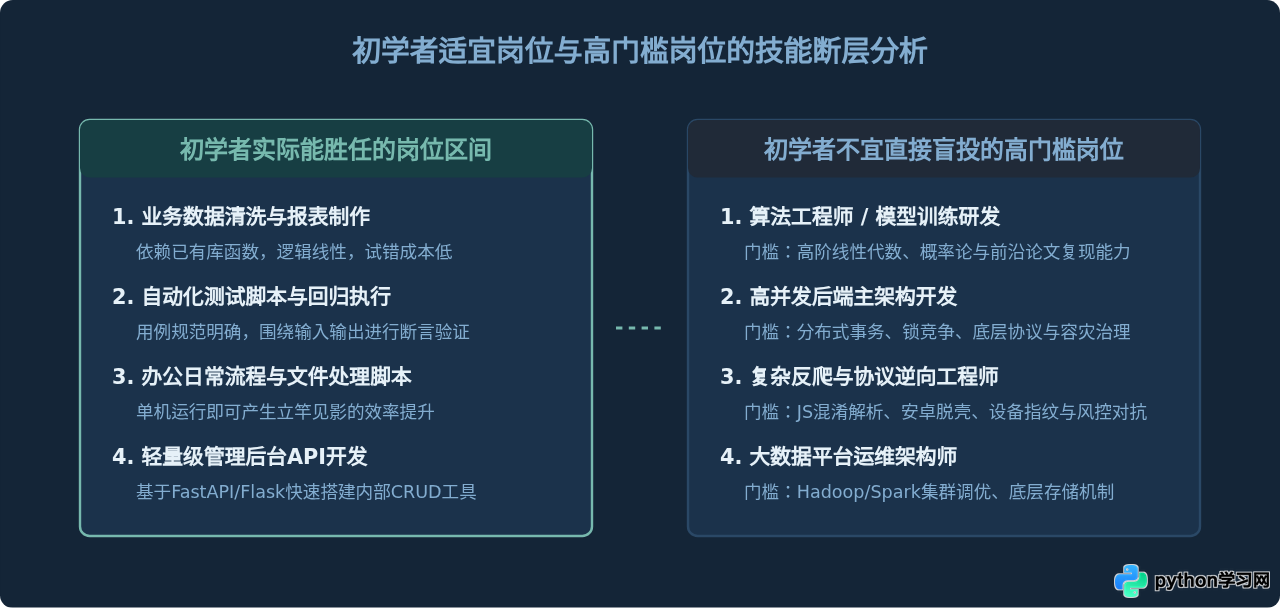
很多营销宣传常给初学者灌输“学会Python就能月薪数万做人工智能”的虚幻预期。认清以下几点事实,能够帮助初学者避开求职弯路:
- 警惕“算法岗位”的学历与理论断层:大厂和科研机构的算法岗绝大多数要求统计学、计算机硕士及以上学历,且对梯度下降、矩阵变换等数学推导有严格考查。仅仅会
import sklearn或调用大模型API,并不能直接胜任算法工程师。 - 工具掌握不等于业务理解:写出
df.groupby()只需要半分钟,但知道“为什么按这三个维度聚合能够发现库存周转率偏低”,需要对行业流程有深入理解。初学者的竞争力往往来自“技术工具 + 业务逻辑”的结合。 - 代码可读性与异常处理是分水岭:很多初学者的自学代码缺乏异常捕获(
try-except),路径写死为本地绝对路径,一旦换台电脑运行就会报错。企业更看重代码的稳定性和模块化规范。
| 岗位方向 | 初学者最低技能配置 | 核心产出物证明 | 招聘高频部门 |
|---|---|---|---|
| 数据分析助理 | SQL多表查询 + Pandas清洗 + 基础统计 | 一份带有业务洞察结论的完整清洗分析报告 | 运营部、财务部、电商部 |
| 自动化测试 | Pytest测试框架 + Selenium/Requests + 断言编写 | 一套包含10个核心用例的自动化回归测试工程 | 研发部QA组、外包测试组 |
| 办公流程自动化 | OpenPyXL/CSV + 正则表达式 + 定时调度脚本 | 可独立运行的文件批量合并与校验工具脚本 | 综合行政、供应链、物流支持 |
| 初级爬虫 | Requests + BeautifulSoup + 数据结构化持久化 | 带异常重试与持久化存储的公开网页抓取模块 | 市场调研部、大数据采集组 |
七、从基础学习到入职验证的实施路径
初学者若希望在3至6个月内实现求职突破,不能停留在被动观看视频教程的阶段,应当遵循一套以“项目作品集”为导向的四步落地法。
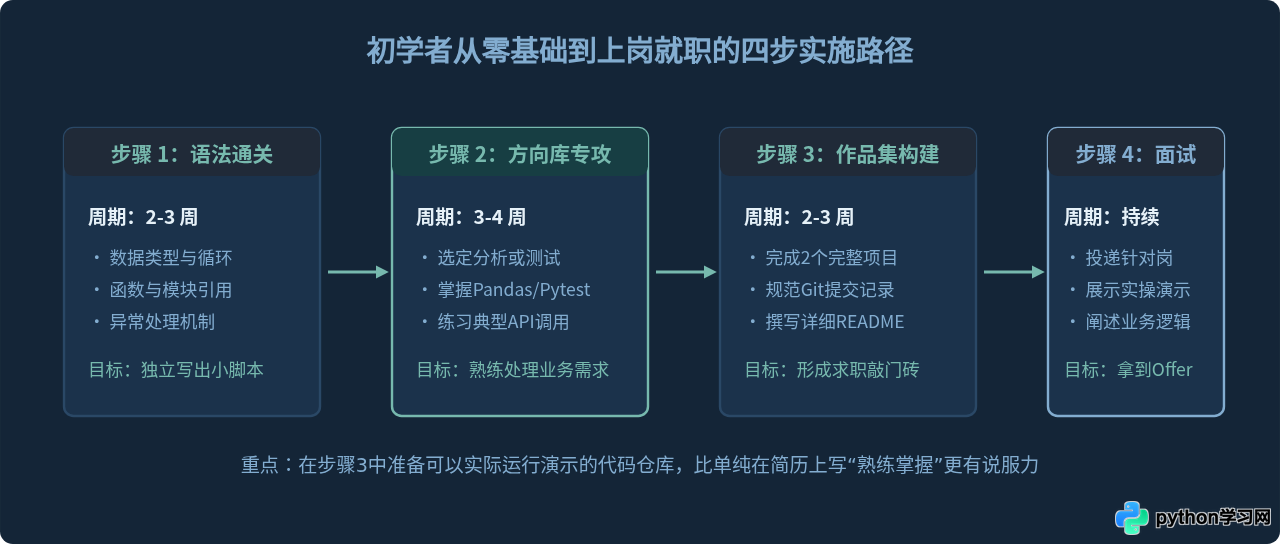
总结而言,初学者学习Python绝非只能从事顶尖的高深研发工作,也并非毫无就业空间。只要合理评估自身当前的编程基础,找准“自动化办公”、“初级测试”、“数据分析助理”和“基础采集开发”等对代码架构要求适度、重视快速实现与业务解决能力的切入点,脚踏实地完成项目积累,就能在技术职场中站稳第一步。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









