

Python只读Excel文件用什么库最轻量

假设你正在一台仅有 512MB 内存的云服务器或边缘设备上运行后台自动化任务,每天需要从外部接收成百上千份几十兆的 .xlsx 报表,并只提取其中的特定几列数据写入数据库。如果你直接使用常规的 pandas.read_excel(),系统往往会在几秒内因内存耗尽被 OOM(Out Of Memory)强行杀掉进程。此时你的核心诉求非常明确:安装依赖尽可能轻、解析时运行内存占用尽可能低、只读速度尽可能快。
针对“只读 Excel”这一特定需求,Python 生态中有两个处于不同维度的轻量级标杆库:如果是追求零额外编译依赖、纯 Python 环境友好,首选 openpyxl 的只读模式(read_only=True);如果是追求极限吞吐速度与极低常驻内存,首选现代 Rust 驱动的 python-calamine。如果是历史遗留的旧版 .xls 格式,则选用极小体积的 xlrd。本文将从底层原理、具体代码及选型边界进行完整拆解。
一、重新定义“轻量”:依赖体积 vs 运行期内存
在讨论哪个库最轻量之前,需要把“轻量”这一概念拆解为两组常常产生冲突的工程指标:
- 安装与依赖轻量:轮子(wheel)包体积小、不依赖大型 C/C++ 运行时环境、对打包工具(如 PyInstaller、Docker 精简镜像)友好。
openpyxl纯 Python 实现,依赖极少,安装包仅约 2.5MB。 - 运行时内存与计算轻量:处理百万行级大表格时,不一次性把整张表转换为 Python 内存对象,而是按需流式消费或在底层紧凑存储。在这点上,
python-calamine凭借底层内存映射与 Rust 的零成本抽象,内存表现极其出色。
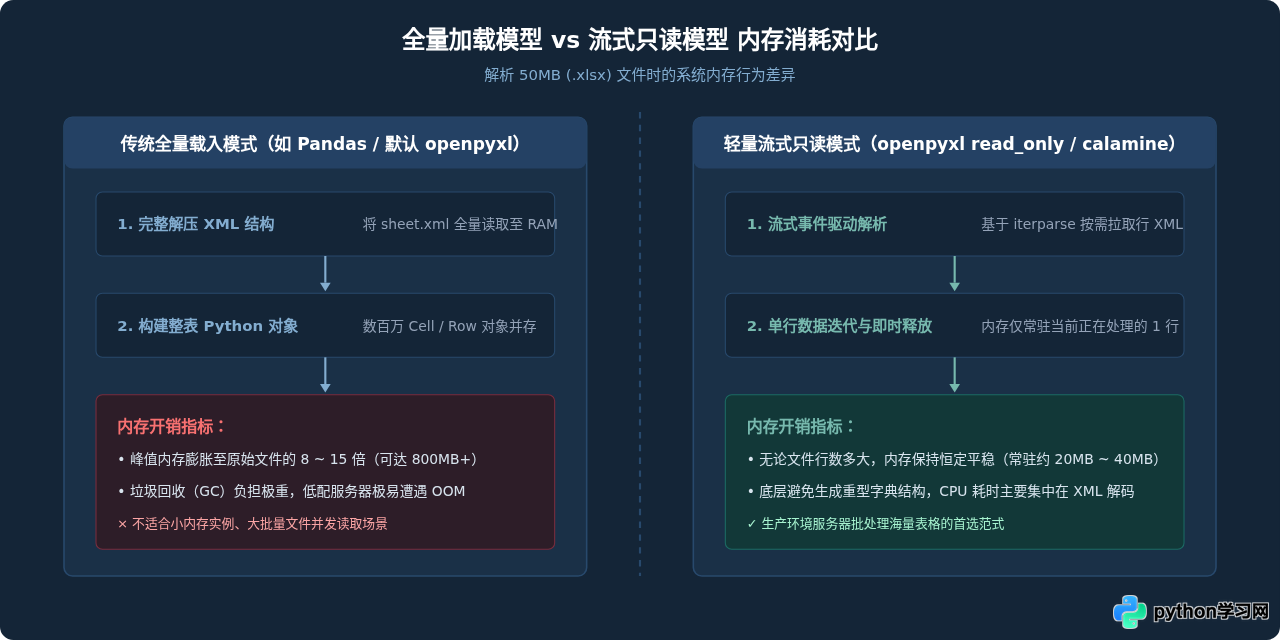
很多开发者在初学时习惯直接导入 pandas,但在纯只读场景下,pandas 绝不是轻量选择。它引入了完整的 numpy 及庞大的依赖链,安装体积动辄近百兆;更关键的是,pandas 在读取表格时会构建庞大的 DataFrame 树结构,内存占用通常是原始文件体积的 5 到 10 倍。
二、方案一:openpyxl 只读模式(最通用的纯 Python 轻量解法)
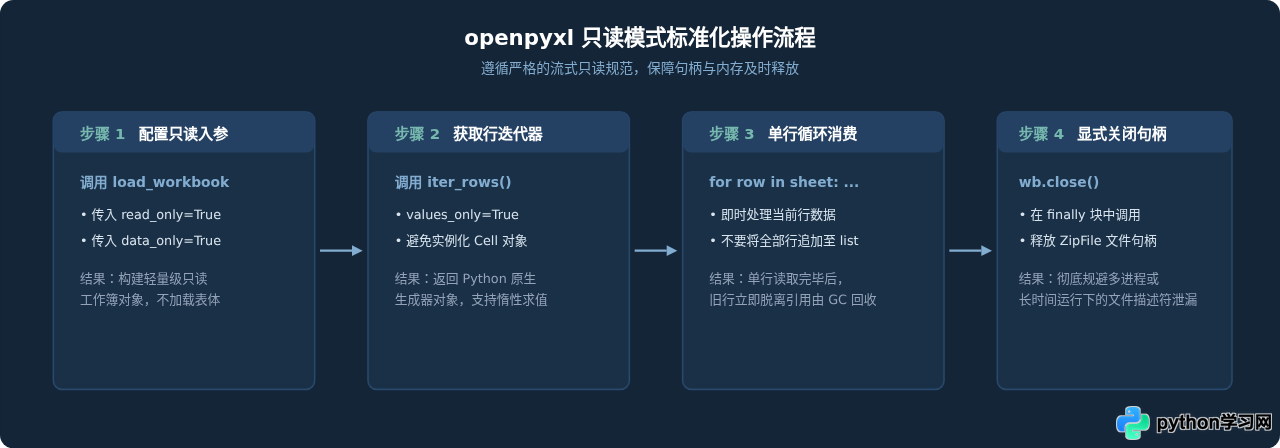
openpyxl 是处理 .xlsx 文件的标准库之一。很多开发者以为 openpyxl 很笨重,实际上这是因为他们没有开启它的流式模式。只要在加载工作簿时显式声明 read_only=True,它的内部机制就会发生根本性转变:底层不再构建整个工作表的 DOM 树,而是通过标准库的 xml.etree.ElementTree.iterparse 变为一个只向前的生成器。
1. 标准只读读取示例
from openpyxl import load_workbook

def process_excel_lightweight(file_path):
    # 启用只读模式与仅数值模式,避免加载格式、样式及公式元数据
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)

    try:
        # 获取首个激活的 sheet
        sheet = wb.active

        # iter_rows 配合 values_only=True 直接返回元组,跳过 Cell 对象封装
        for row_idx, row_values in enumerate(sheet.iter_rows(values_only=True), start=1):
            if row_idx == 1:
                headers = row_values
                continue

            # 此处处理业务逻辑,例如写入数据库或过滤特定值
            # 此时内存中仅保存当前单行的 row_values 元组
            if row_values[0] is not None:
                # 示例处理:打印前几行
                if row_idx <= 5:
                    print(f"行 {row_idx}: {row_values[:3]}")
    finally:
        # 只读模式下必须显式关闭以释放底层 XML 句柄
        wb.close()

if __name__ == "__main__":
process_excel_lightweight("example_data.xlsx")•
read_only=True:通知引擎按行流式解压,禁止生成整表缓存。
•
data_only=True:只获取公式计算后的静态值,避免解析公式树。
•
iter_rows(values_only=True):直接产生 Python 原生类型元组(如字符串、浮点数),避免为每个单元格实例化重量级的 ReadOnlyCell。
2. 只读模式下的重要限制与避坑项
- 必须调用
wb.close():普通加载模式下,整个文件在读取后会完全载入内存并关闭文件句柄;但read_only=True模式下,底层依靠活动的ZipFile流读取,如果不显式close(),在批量处理成千上万个文件时会导致系统“Too many open files”错误。 - 不可反向索引:因为是基于流的单向生成器,你无法使用
sheet['A10']这类随机坐标访问,也不能对迭代器执行切片操作;必须按行从前往后依次读取。 - 最大行列数属性不可信:在只读模式下,
sheet.max_row和sheet.max_column往往返回None,或者仅仅是 Excel 内部记录的估算元数据,不能作为精确遍历的边界,应直接遍历行生成器。
三、方案二:python-calamine(速度与极低内存的现代极致)
如果你所指的“轻量”不仅是安装包体积,而是对运行耗时、CPU 资源与单机并发吞吐量有严苛要求,那么 python-calamine 是目前 Python 生态中最值得推荐的选择。
calamine 本身是 Rust 社区中最著名的只读 Excel 解析器。python-calamine 是其针对 Python 的 CPython/PyO3 绑定:
- 底层完全用 Rust 实现,解析 XML 与解压 ZipFile 的速度通常是纯 Python 库的 3 到 8 倍。
- 它被 Polars 等现代化超高性能数据分析框架选为默认的 Excel 读取后端。
- 它是一个单纯的只读库,没有任何写入、样式修改或排版逻辑,因此设计高度聚焦,代码干净纯粹。
使用示例
from python_calamine import CalamineWorkbook

def read_with_calamine(file_path):
    # Calamine 专注于只读,直接加载文件路径
    workbook = CalamineWorkbook.from_file(file_path)

    # 获取工作表名称列表
    sheet_names = workbook.sheet_names
    print("包含的工作表:", sheet_names)

    # 获取指定工作表
    sheet = workbook.get_sheet_by_name(sheet_names[0])

    # to_python() 以原生的行列表形式返回数据
    # 相比 openpyxl,它的 C/Rust 级别迭代器转换速度极快
    for row_idx, row in enumerate(sheet.to_python()):
        if row_idx == 0:
            print("表头:", row)
        elif row_idx <= 5:
            print(f"数据行 {row_idx}:", row)

if __name__ == "__main__":
read_with_calamine("example_data.xlsx")适用场景:当需要在一个 API 请求内快速完成数万行 Excel 文件的读取、或者在有限算力设备上以极低延迟完成解析时,python-calamine 的优势非常突出。不过需要注意,虽然它提供了绝大多数平台的预编译 Wheel 包(无需用户本地安装 Rust 编译器),但如果处于极端特殊的非主流 CPU 架构(如某些老旧 MIPS 或特定嵌入式 Linux)中,可能需要预先交叉编译。
四、方案三:历史遗留 .xls 格式的轻量方案(xlrd)
如果业务场景中需要处理的是老版本的二进制 .xls 格式(Excel 97-2003),那么无论是 openpyxl 还是现代专用库都无法支持(openpyxl 仅支持 .xlsx / .xlsm)。此时最轻量的选择依然是经典老牌库 xlrd。
xlrd 在 2.0.0 版本之后为了安全考虑,彻底移除了对 .xlsx 的支持,目前仅支持 .xls 文件。它的安装包体积极小(纯 Python,仅约几百 KB),对旧版二进制 BIFF8 格式的解析非常成熟。
import xlrd

def read_legacy_xls(file_path):
    # 打开 .xls 文件
    workbook = xlrd.open_workbook(file_path, on_demand=True)
    try:
        sheet = workbook.sheet_by_index(0)
        for row_idx in range(min(5, sheet.nrows)):
            print(f"行 {row_idx}:", sheet.row_values(row_idx))
    finally:
        workbook.release_resources()
五、选型决策:根据业务约束选择最佳库
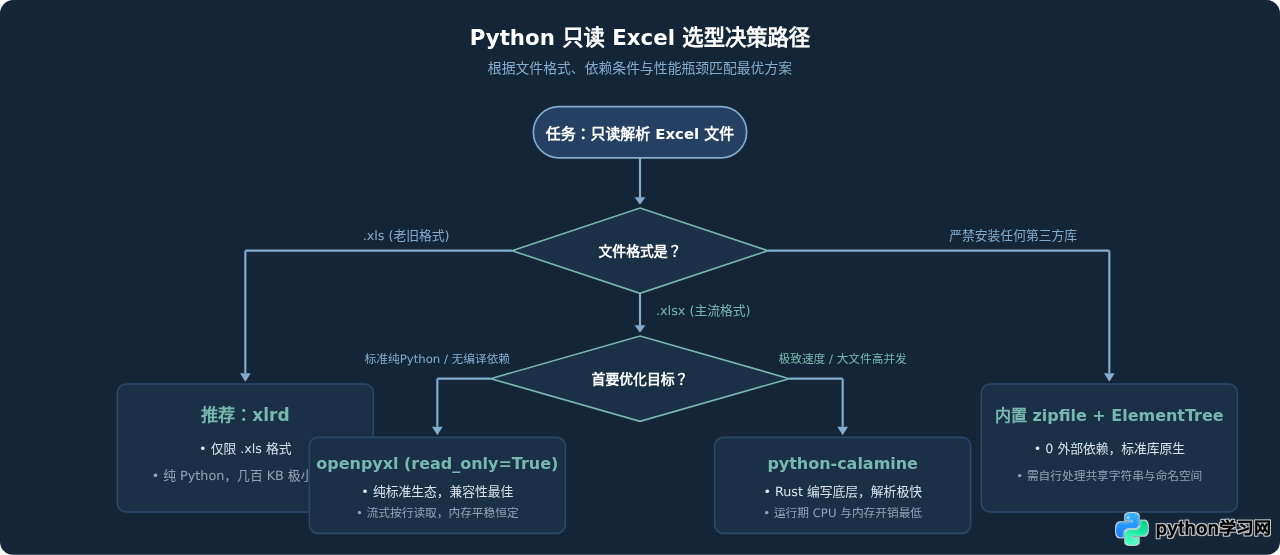
面对具体业务时,应该如何在这些方案中做出明确的技术选型?我们可以根据格式要求、环境约束以及资源瓶颈来快速做出决策:
六、四大方案多维指标对比与总结
为了让不同方案的综合表现一目了然,下表列出了常见方案在实际使用中的关键属性:
| 对比维度 | openpyxl (read_only) | python-calamine | xlrd (>=2.0.0) | pandas (read_excel) |
|---|---|---|---|---|
| 实现语言与依赖 | 纯 Python,依赖极少 | Rust 扩展(提供 Wheel) | 纯 Python,无额外依赖 | C/Python,强依赖 NumPy 等 |
| 安装包体积 | 约 2.5 MB | 约 1.5 MB ~ 3 MB | 约 170 KB | 通常 > 80 MB |
| 支持文件格式 | .xlsx, .xlsm | .xlsx, .xlsb, .xls, .ods | 仅支持 .xls (旧格式) | 依赖后端,多格式支持 |
| 运行时内存占用 | 极低(流式单行迭代) | 极低(Rust 内存映射) | 中等(全量 DOM 式加载) | 极高(整表构建 DataFrame) |
| 读取解析速度 | 中等(受限 Python 循环) | 极快(通常为其他库 3~5 倍) | 快(仅限旧格式二进制) | 慢至中等(封装开销大) |
| 推荐使用场景 | 标准 Web 服务、容器化脚本 | 高性能服务、高并发批处理 | 维护历史旧系统 .xls 数据 | 复杂数据清洗与科学计算 |
总结来说,要在 Python 中以最轻量的方式只读解析 Excel,最推荐的做法是直接使用 openpyxl 并开启 read_only=True 和 values_only=True,它既不需要繁重的外部 C 扩展编译环境,又能在低内存机器上平稳流式消费百万行数据;而在追求极限吞吐、资源极端受限或需要兼顾多种格式的高性能只读场景下,python-calamine 是当下无可匹敌的技术方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









