

构建RAG系统的关键组件:向量数据库、Embedding与LLM协作机制

要实现一个能回答私有领域知识的AI助手,单纯依靠大语言模型往往会出现“幻觉”或知识滞后。检索增强生成(RAG)技术通过引入外部知识库,让模型在回答前先“查阅资料”,从而显著提升准确性。这种架构的核心优势在于数据与模型解耦,更新知识只需替换数据库内容,无需重新训练模型。
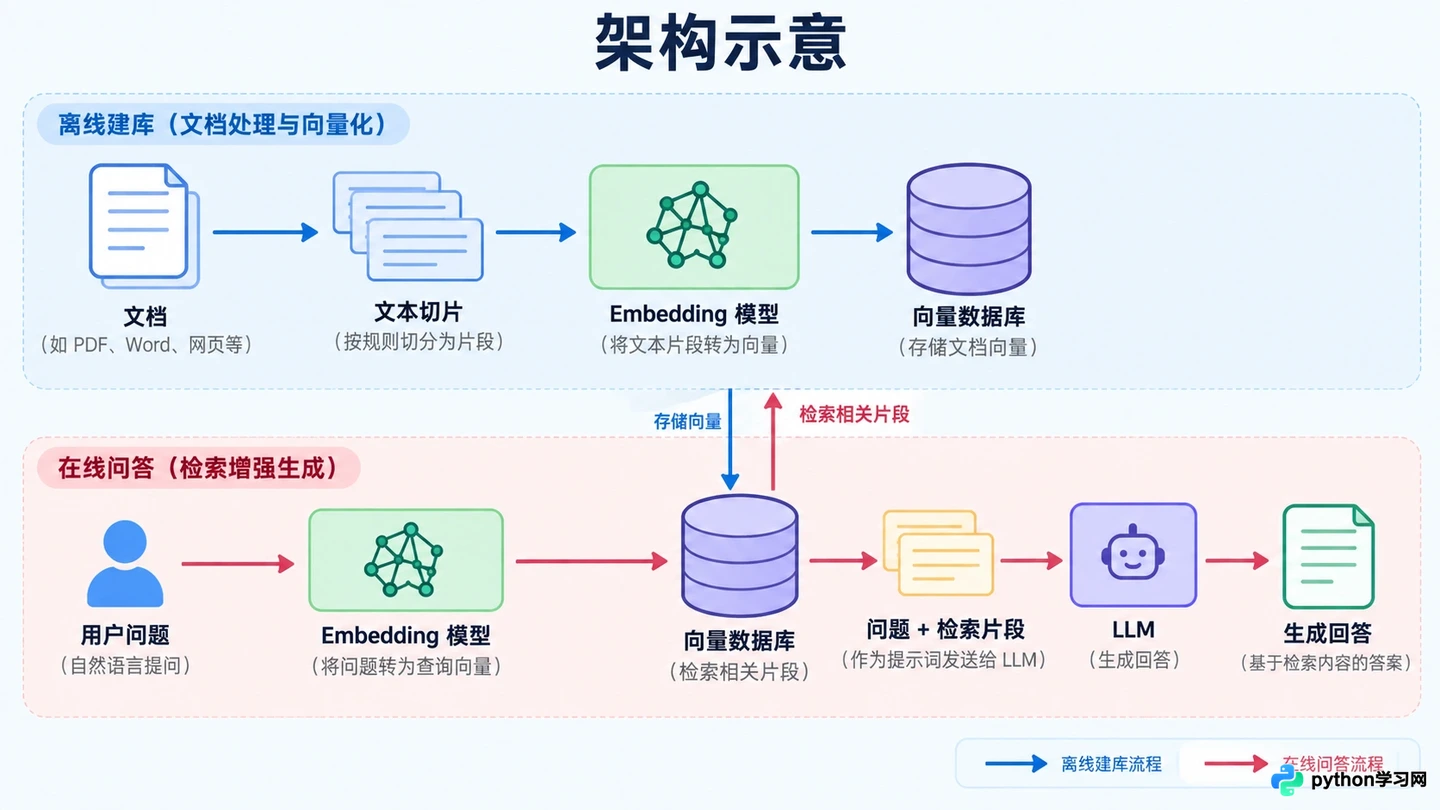
RAG系统数据流向:从文档切片到最终答案生成的完整链路
RAG的工作流并非魔法,而是由三个明确阶段组成的线性管道:首先将文档切片并转化为数学向量,接着在向量空间中寻找最相关的片段,最后将这些片段作为上下文喂给大语言模型。理解这一过程,关键在于看清数据在每个节点的形态变化。
1. 文本切片与Embedding向量化
一切始于原始数据的处理。直接扔给模型几十万字的PDF通常效果不佳,需要先进行分块(Chunking)。使用文本分割工具,按段落或固定字符数将长文档切分为较小的片段,例如每段500字,并保留一定的重叠窗口以维持语义连贯性。
接下来是核心步骤:调用Embedding模型。选中切分好的文本片段,通过API发送给Embedding服务(如text-embedding-ada-002或开源的BGE模型)。模型不会返回文字,而是输出一个高维向量数组,例如长度为1536的浮点数列表。这个向量就是文本在语义空间中的坐标,语义相近的句子,其向量坐标在空间中也彼此靠近。
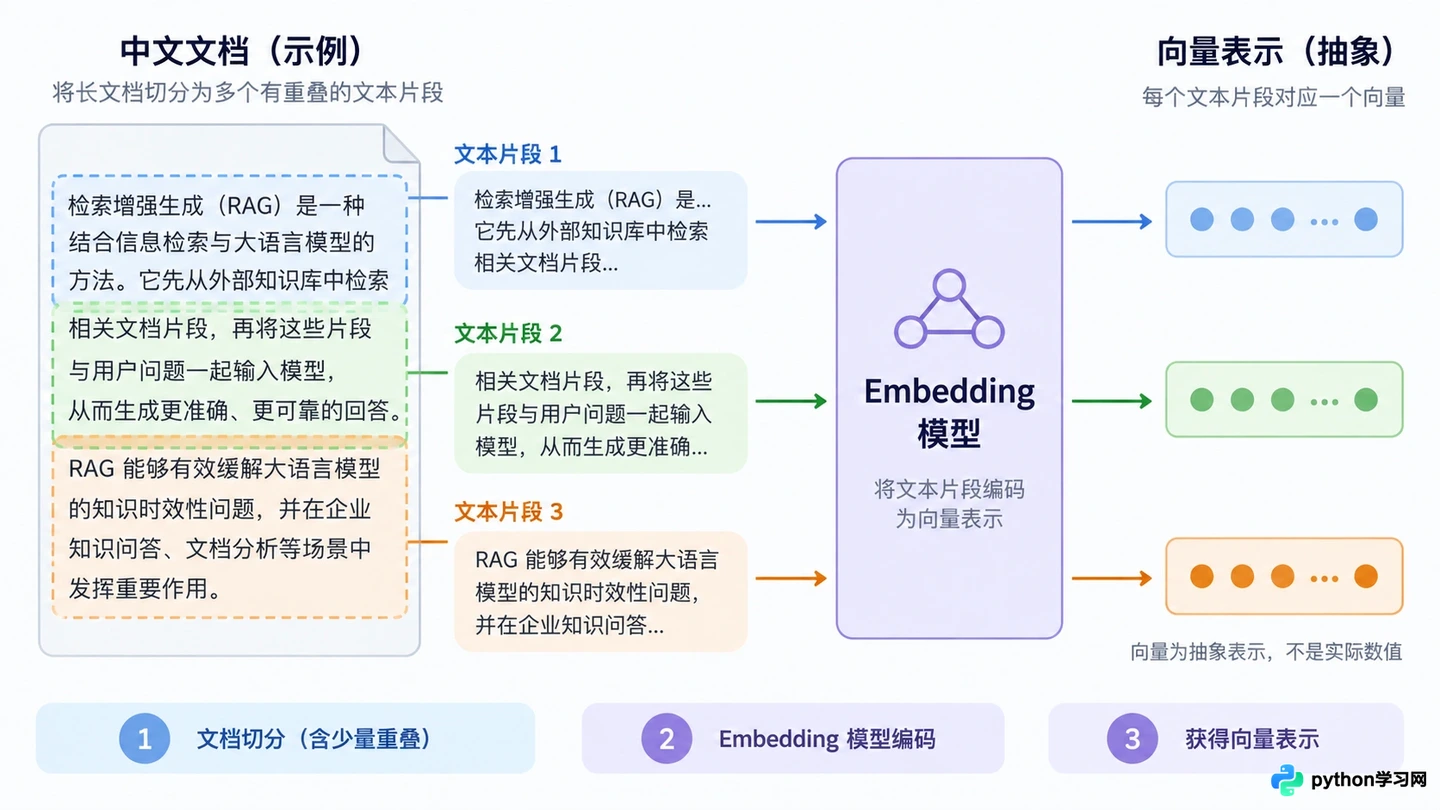
文本被切分为片段并通过Embedding模型转化为高维向量
此时,原始文本与其对应的向量被打包存储。注意,这一步只负责“编码”,不涉及任何问答逻辑。你需要确保Embedding模型的维度与后续向量数据库的配置一致,否则无法写入。
2. 向量入库与索引构建
获得向量后,需要将其存入专门的向量数据库(如Milvus、Chroma或Pinecone)。在数据库控制台或代码客户端中,创建一个集合(Collection),指定维度数和距离度量方式(通常选择余弦相似度Cosine Similarity或欧氏距离)。
执行插入操作,将上一步生成的“文本-向量”对批量写入数据库。系统会自动构建索引结构(如HNSW或IVF_FLAT),这是加速检索的关键。索引构建完成后,数据库不再存储原始文档的全部细节,而是维护着一个巨大的多维空间地图,每个点都指向一段具体的文本。
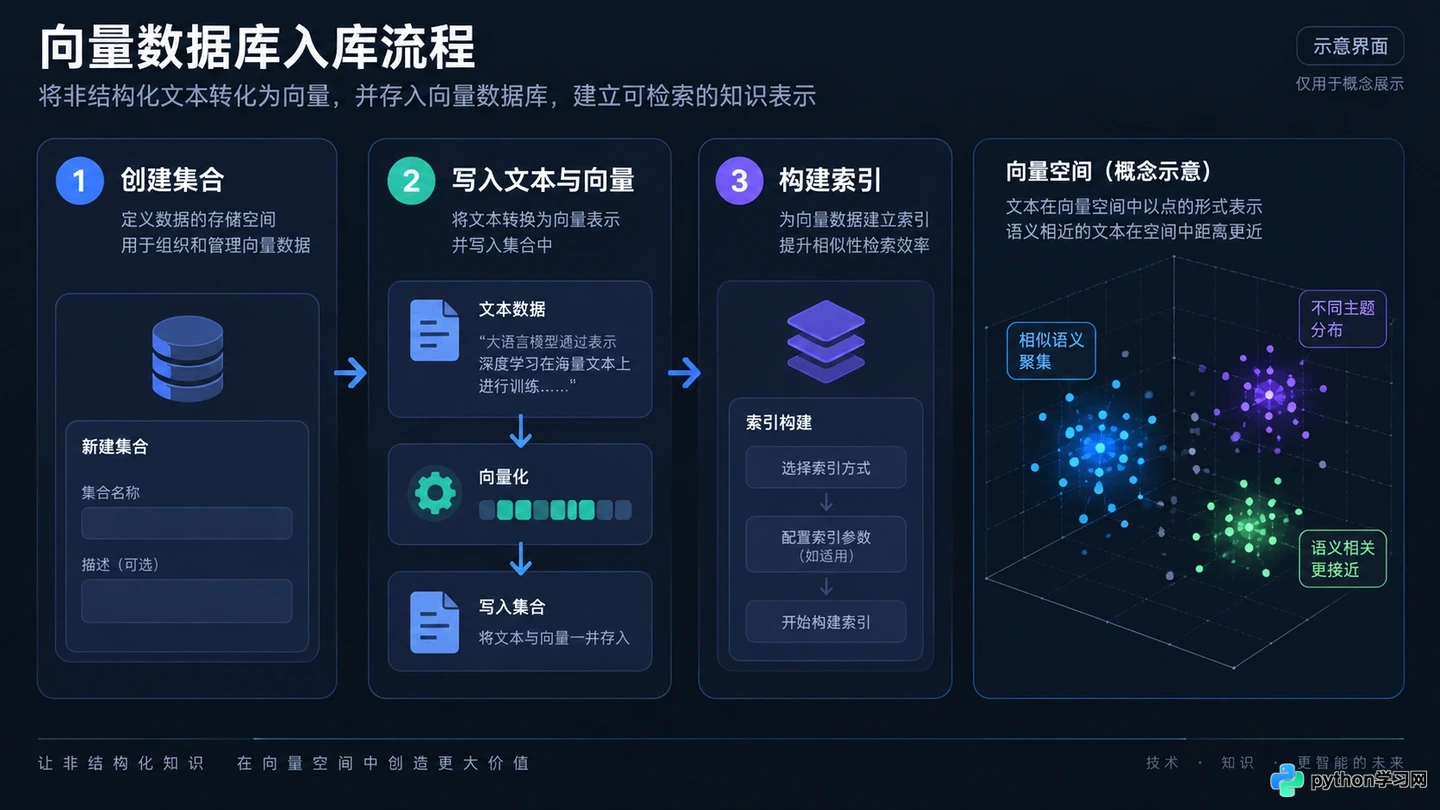
向量数据库控制台显示集合创建与数据插入状态
验证入库是否成功,可以查询集合中的条目数量,应与切片总数一致。此时,数据库已准备好接收查询请求,但尚未发生任何智能匹配。
3. 查询向量化与相似度检索
当用户提出问题(例如“公司的报销政策是什么?”)时,系统不能直接在数据库中搜索关键词,因为自然语言表达多样。首先,必须使用同一个Embedding模型,将用户的问题也转化为向量。务必保证查询向量和库中向量的来源模型一致,否则语义空间不统一,检索结果将毫无意义。
拿着这个“问题向量”,向向量数据库发起相似性搜索请求。设置参数Top-K(例如K=5),表示返回最相似的5个片段。数据库会在高维空间中计算问题向量与所有存储向量的距离,迅速找出距离最近的5个点,并返回它们对应的原始文本片段及相似度得分。
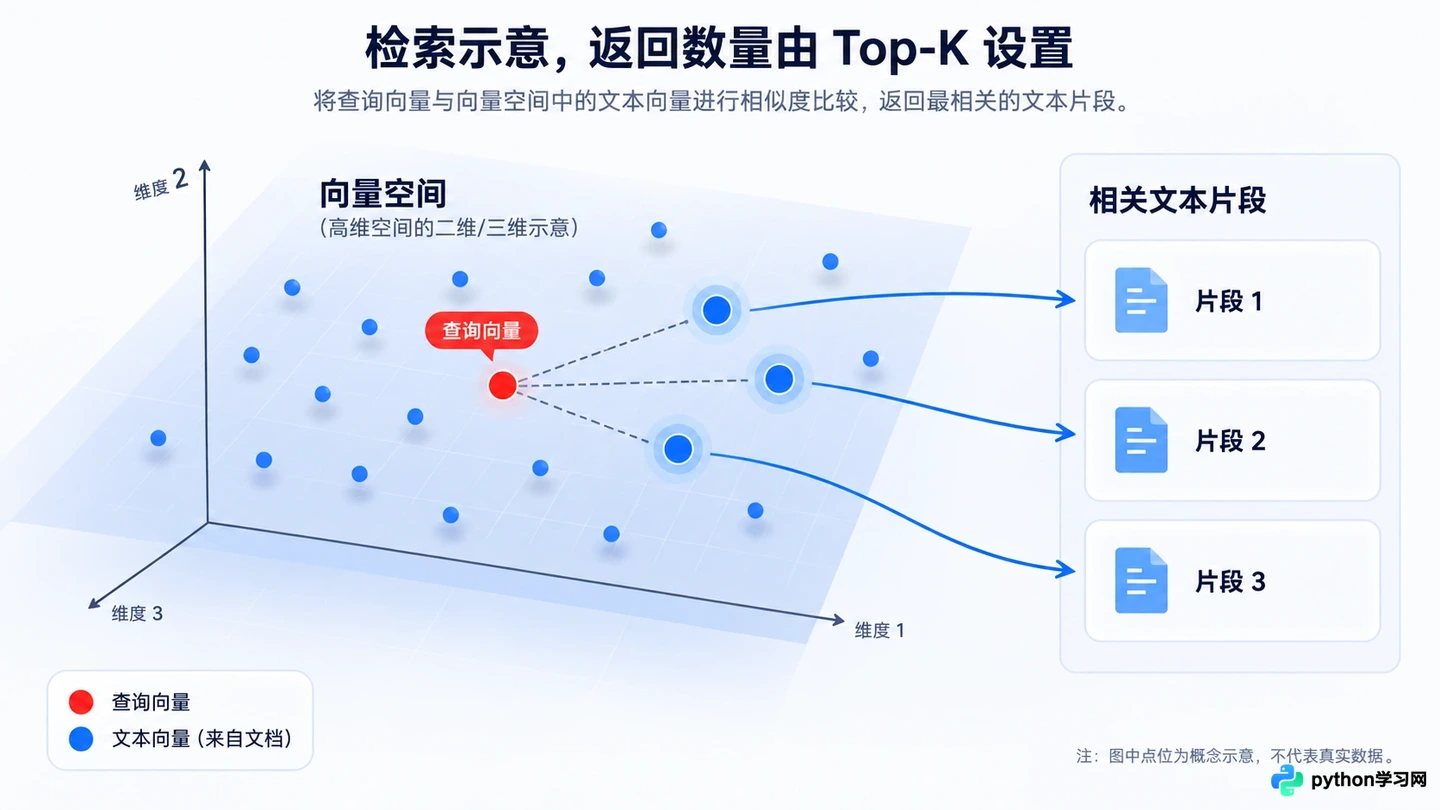
查询向量在数据库中匹配到高相似度文本片段
观察返回结果,你会发现即使问题中没有出现“报销”二字,只要语义相关,高分片段依然会被召回。这就是向量检索超越关键词匹配的能力所在。如果得分普遍过低,说明知识库中可能缺乏相关信息。
4. 提示词组装与LLM生成
拿到检索到的5个文本片段后,最后一步是交给大语言模型(LLM)。构建一个Prompt模板,结构通常为:“请根据以下参考信息回答问题。参考信息:{context}。问题:{question}。”
将检索到的文本片段填入{context},用户原始问题填入{question},然后发送给LLM。LLM阅读这些限定范围内的材料,生成最终答案。由于有了明确的参考依据,模型会大幅减少胡编乱造,并能提供基于事实的回答。
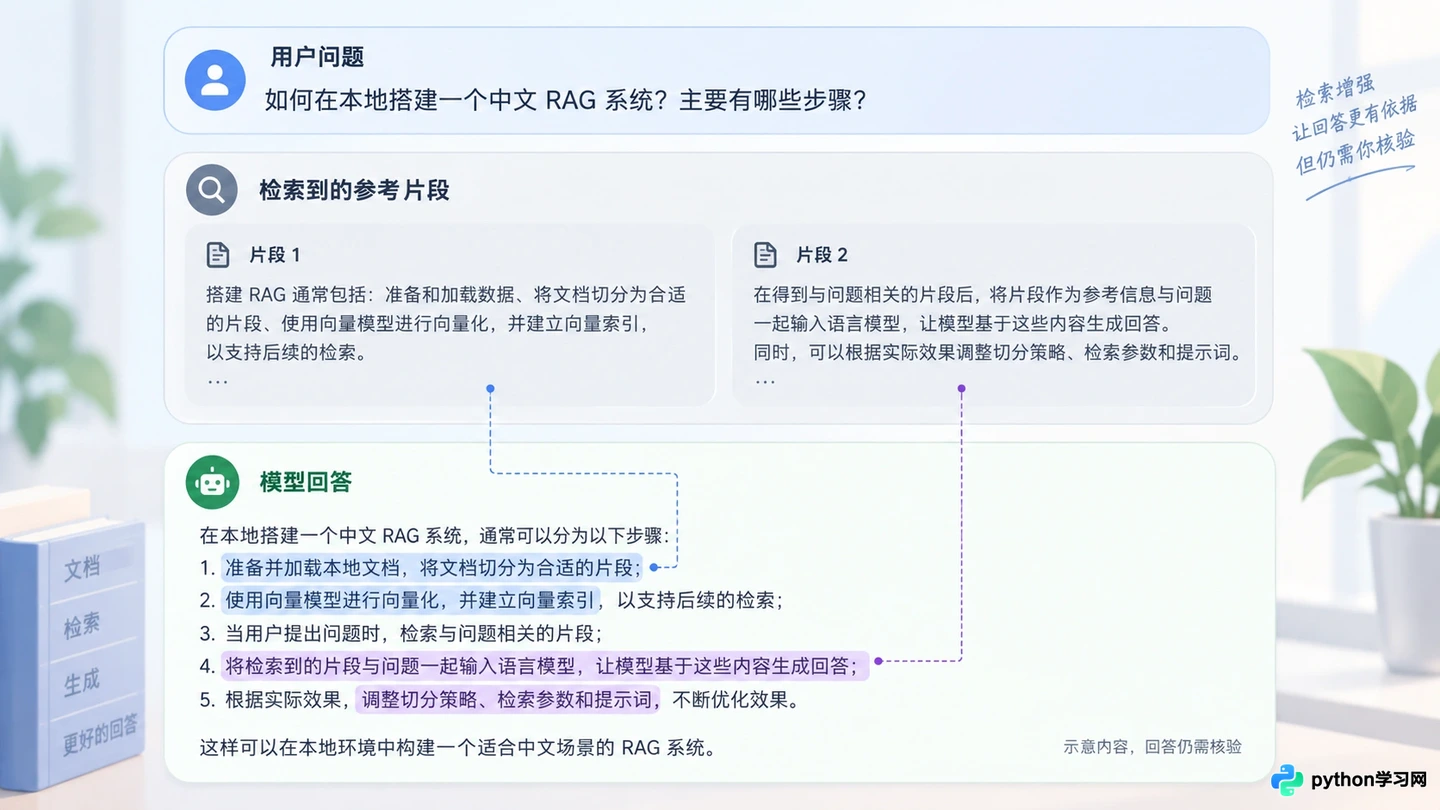
大语言模型根据检索到的上下文生成准确回答
检查最终输出,确认答案是否严格基于提供的片段。如果LLM回答了片段中不存在的内容,需调整Prompt指令,增加“如果参考信息不足,请回答不知道”的限制。至此,一个完整的RAG闭环完成,数据从非结构化文本变为向量,经检索回归为文本,最终转化为智能回答。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









