


大模型一旦碰到企业内部制度、私有知识或时效性很强的问题,最容易暴露的不是“不会”,而是“看起来很会、实际上在编”。这也是很多团队把 LLM 接进业务后最先遇到的落差:回答流畅,但难以核验,越像真话越危险。
要解决这个问题,关键不是继续逼模型“背更多”,而是给它一个先检索、后回答的工作流。下面就从 RAG 的基本逻辑讲起,先看朴素方案为什么容易失真,再落到 Go 里的实现方式,帮助你判断它适不适合当前项目。
RAG 到底解决了什么问题?
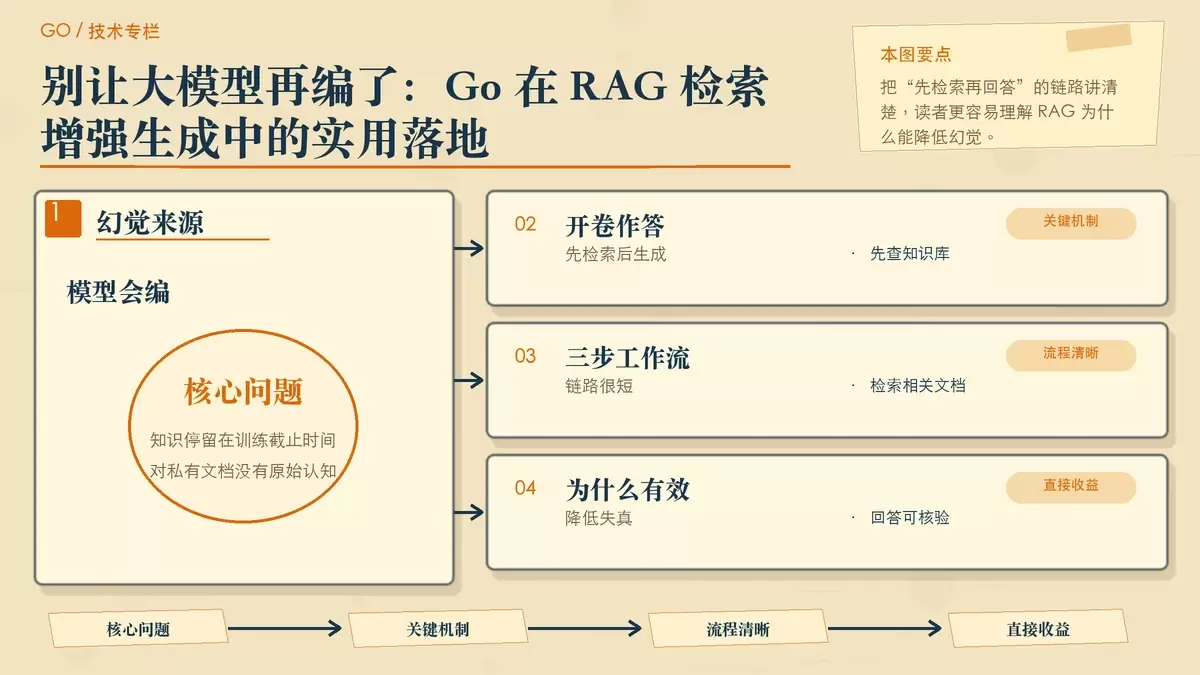
RAG,Retrieval-Augmented Generation,通常译作“检索增强生成”。它的核心并不复杂,可以理解为让大模型从“闭卷作答”变成“开卷作答”。
传统问答里,模型只能依赖训练阶段学到的知识。这样一来,它既不知道训练截止日期之后的新信息,也不了解团队内部的私有文档。但它又往往不会直接承认“我不知道”,于是就出现了最棘手的幻觉问题。
RAG 的处理方式是:先从知识库中找出和问题相关的内容,再把这些内容连同用户问题一起交给模型生成回答。这样带来的直接收益有两个:
- 回答有依据,能显著降低幻觉概率;
- 知识更新不依赖重新训练模型,只需要更新知识库。
它的典型流程可以概括为:
用户提问 → 检索相关文档 → 拼接到 Prompt → LLM 生成回答比如用户问“我们公司的年假政策是什么?”,系统不会直接让模型凭记忆回答,而是先从公司制度文档中检索出对应段落,再把段落和问题一起提交给模型。此时模型不是“猜答案”,而是在“读资料后回答”。
为什么 Naive RAG 很难直接上生产?
很多入门实现会把 RAG 简化成一条标准流程:文档切块、向量化、写入向量库,提问时再取最相似的 Top-K 片段塞进 Prompt。这个方案能跑通 Demo,但离稳定可用还有明显距离。
问题首先出在切分策略上。若按固定 512 token 去切,很容易把本来连续的语义拆散。一个完整的问答对、一个操作步骤,甚至一段定义和限制条件,都可能被切到不同 chunk 里,导致检索出来的只是“半截上下文”。
其次,语义相似不等于真实相关。用户搜“如何重置密码”,向量检索可能同时召回“密码重置政策”“密码安全规范”这类内容。它们在语义空间里足够接近,但用户真正需要的是操作步骤,而不是制度条款。
还有一个常见问题是 Top-K 检索过于粗糙。最相似的 K 个片段,不代表就是最适合回答问题的 K 个片段。某些关键段落可能排名并不靠前,但恰恰决定了回答是否准确,结果却被漏掉了。
所以,Naive RAG 的主要问题不在“有没有检索”,而在“检索结果能不能真正支撑生成”。这也是生产环境要继续做优化的原因。
生产级 RAG 常见的三类优化
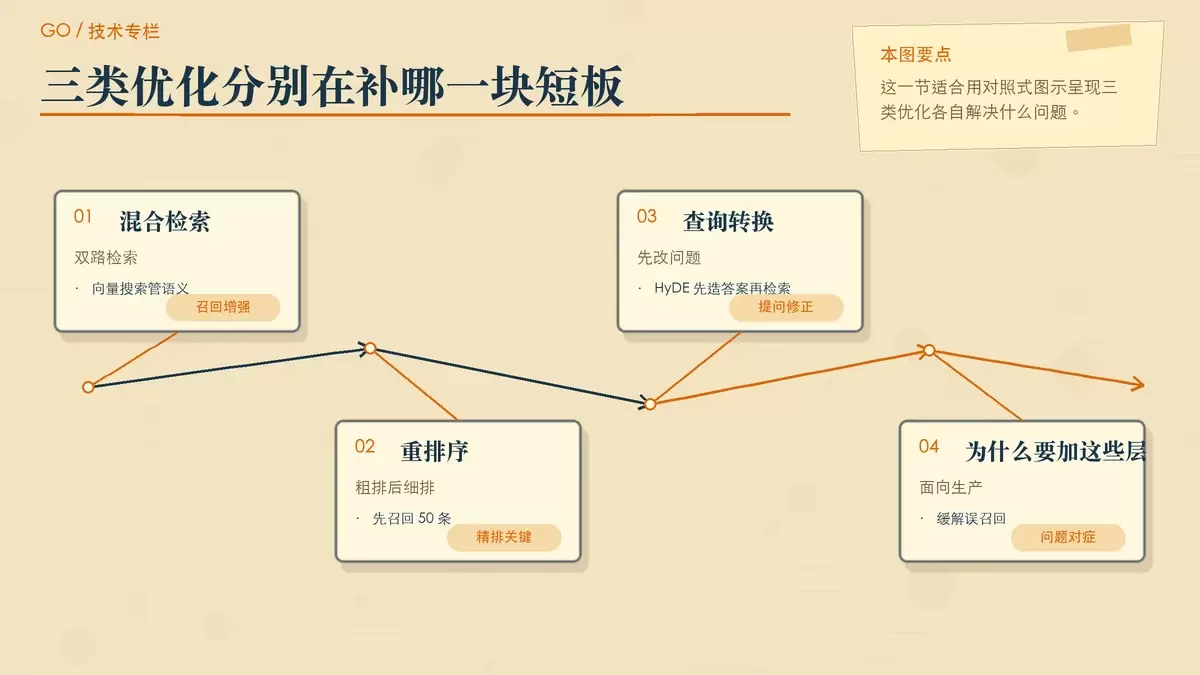
进入真实业务场景后,RAG 往往要补上几层能力,才能兼顾召回率、精度和可控成本。文中提到的三类优化,基本就是当前生产实践里最常见的方向。
混合检索:把语义理解和关键词命中结合起来
单独使用向量检索的优势在于理解语义,但它对精确匹配并不敏感,尤其是错误码、方法名、产品名、字段名这类信息。现实里,用户很多时候搜的恰恰就是这些“不能模糊理解”的词。
因此,更稳妥的做法是把向量搜索和 BM25 关键词搜索结合起来:
- 向量搜索负责理解“用户想表达什么”;
- BM25 搜索负责命中“用户明确提到了什么”。
两路结果再通过 RRF(Reciprocal Rank Fusion)做融合排序。这样既能保留语义召回能力,也能把精确命中的内容拉回来,通常会比单一检索方式更稳定。
重排序:先广泛召回,再精细筛选
重排序通常被认为是最有性价比的一步。原因很简单:第一轮检索只负责“尽量别漏”,第二轮再负责“尽量别错”。
一个常见做法是,先粗排召回 50 条候选文档,再用 Cross-encoder 模型逐条判断“问题 + 文档”这对输入的相关性,最后只保留最相关的 Top 5。相比 Bi-encoder 分别编码问题和文档,Cross-encoder 对两者之间关系的理解更细,判断通常也更准。
它的代价是计算更重,但因为只处理少量候选结果,整体成本通常仍可接受。对很多团队来说,这一步往往比继续调 chunk 大小、盲目增加 Top-K 更有效。
查询转换:先把问题变得更适合检索
检索效果不好,不一定是知识库有问题,也可能是用户问题本身过于模糊。查询转换的目标,就是先把原始提问改写成更容易命中文档的形式。
- HyDE:先让 LLM 生成一个假设性答案,再用这个答案去检索。因为“答案表述”往往比“问题表述”更接近目标文档的语义分布。
- Multi-Query:从不同角度生成多个查询变体,分别检索后再合并去重,减少单一表述带来的遗漏。
- Step-Back:先退一步问更宽泛的问题,获取背景知识,再回到原始问题做更精确的检索。
这类方法本质上是在改善“检索入口”,尤其适合用户提问口语化、简称多、上下文缺失的场景。
用 Go 搭一个可运行的 RAG 流程
如果要把 RAG 落到 Go 项目里,LangChainGo 是一个比较直接的起点。它是 LangChain 的 Go 语言实现,已经提供了文档加载、切分、嵌入、向量存储和检索问答链等核心组件。
1. 加载文档并切分
// 创建文本加载器和切分器
f, _ := os.Open("knowledge.md")
loader := documentloaders.NewText(f)
splitter := textsplitter.NewRecursiveCharacter(
    textsplitter.WithChunkSize(500),
    textsplitter.WithChunkOverlap(50),
)
// 加载文档并按语义切分
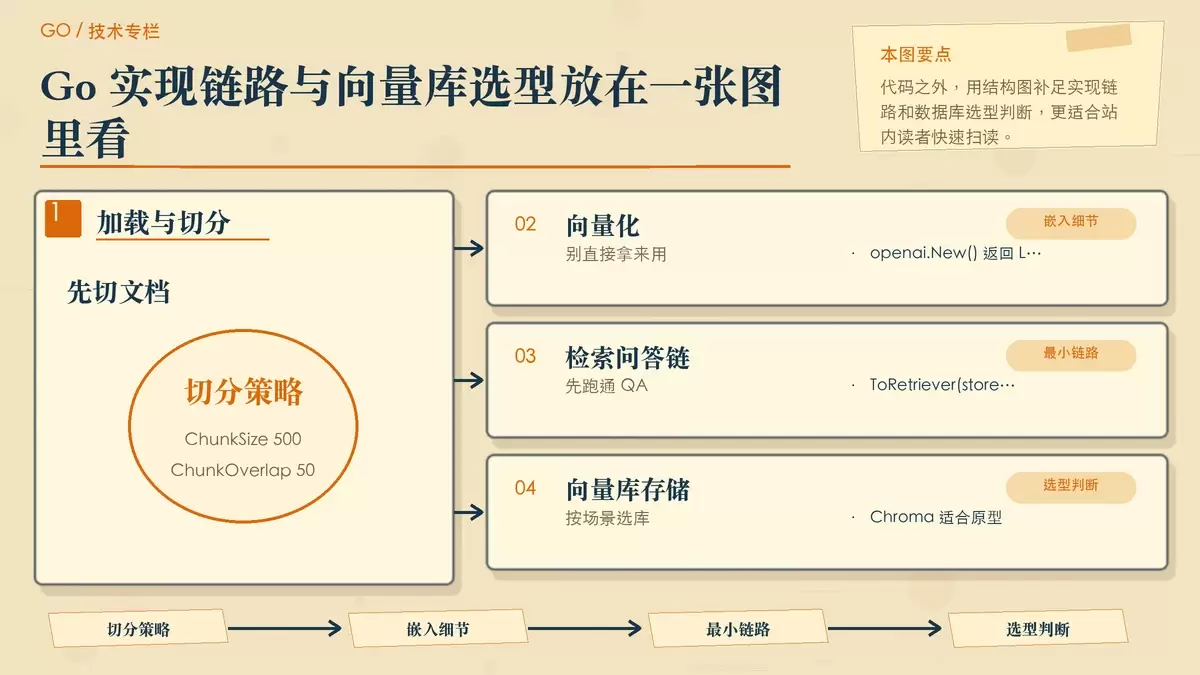
docs, _ := loader.LoadAndSplit(ctx, splitter)这里有两个点值得注意。第一,ChunkOverlap 设为 50,可以在 chunk 边界保留一部分重叠内容,减少上下文被截断的风险。第二,NewRecursiveCharacter 使用递归字符切分,比简单按固定长度硬切更适合保留语义连续性。
2. 向量化并写入存储
// 创建 LLM 并包装为 Embedder
llm, _ := openai.New()
embedder, _ := embeddings.NewEmbedder(llm)
// 创建 Chroma 向量存储
store, _ := chroma.New(
    chroma.WithEmbedder(embedder),
    chroma.WithNameSpace("my-knowledge"),
)
store.AddDocuments(ctx, docs)这里的细节是,openai.New() 返回的是 LLM,本身不能直接当嵌入器使用,需要先通过 embeddings.NewEmbedder() 包装,之后才能交给向量存储。
示例里使用的是 Chroma,适合快速原型和小规模试验。如果只是先验证流程,门槛相对低,部署也比较轻。
3. 构建检索问答链
// 创建 Retriever 和检索问答链
retriever := vectorstores.ToRetriever(store, 5)
chain := chains.NewRetrievalQAFromLLM(llm, retriever)
result, _ := chains.Run(ctx, chain,
    "Go语言的垃圾回收机制是怎样的?")
fmt.Println(result)
vectorstores.ToRetriever(store, 5) 会把向量存储转成检索器,并在查询时取最相关的 5 个文档片段。接着,chains.NewRetrievalQAFromLLM 创建检索问答链,内部默认采用 Stuff 模式,把检索结果统一拼进 Prompt 再交给模型回答。
这套流程足够跑通一个最小可用的 RAG 原型,但如果你准备接入真实业务,前面提到的混合检索、重排序和查询转换,通常都要逐步补上。
向量数据库怎么选更合适?
RAG 的效果不只由模型决定,底层向量存储的选择也会影响开发成本、部署复杂度和后续扩展空间。文中的几种常见方案可以这样理解:
| 数据库 | 特点 | 适用场景 |
|---|---|---|
| Chroma | 轻量、嵌入式 | 原型开发、小规模 |
| pgvector | PostgreSQL 扩展 | 已用 PG 的团队 |
| Milvus | 分布式、十亿级 | 大规模生产环境 |
| Qdrant | 高性能、Rust 编写 | 对延迟要求高 |
如果团队已经深度使用 PostgreSQL,那么 pgvector 往往是最自然的选择,数据体系不用拆得太开。若当前重点是快速验证,Chroma 更轻,适合先把链路打通。等数据规模、并发量和检索延迟要求逐步上来,再考虑迁移到 Milvus 或 Qdrant,会更符合工程节奏。
Go 适不适合做 RAG 落地?
RAG 不是银弹,它不能替你解决知识库质量、文档治理和评测体系的问题。但在“降低幻觉、接入私有知识、让答案可追溯”这几个关键目标上,它确实是当前最务实的一条路径。
从工程实现角度看,Go 在这类系统里有自己的优势:检索服务并发处理能力强、响应延迟低,部署时还能打成单一二进制,比较适合做在线问答和内部知识服务。虽然 Go 的 AI 生态目前没有 Python 那么丰富,但仅从 RAG 这条链路出发,LangChainGo 已经足够覆盖不少常见场景。
如果你的目标是尽快做出一个可信度更高、能接私有知识的问答系统,那么与其继续和提示词较劲,不如先把 RAG 链路搭起来,再围绕检索质量持续优化。很多时候,决定回答是否靠谱的,不是模型说得多流畅,而是它手里有没有真正相关的资料。









