

RAG技术在企业知识库与智能客服中的实际应用案例

传统的大语言模型虽然能流畅对话,但面对企业内部特有的产品参数、最新政策或私有文档时,往往因为训练数据截止或知识盲区而产生“幻觉”。检索增强生成(RAG)技术通过外挂实时知识库,让AI在回答前先“查阅”最新资料,从而给出有据可依的答案。这种架构不仅解决了数据时效性问题,还大幅降低了模型微调的成本,成为企业智能化转型的首选方案。
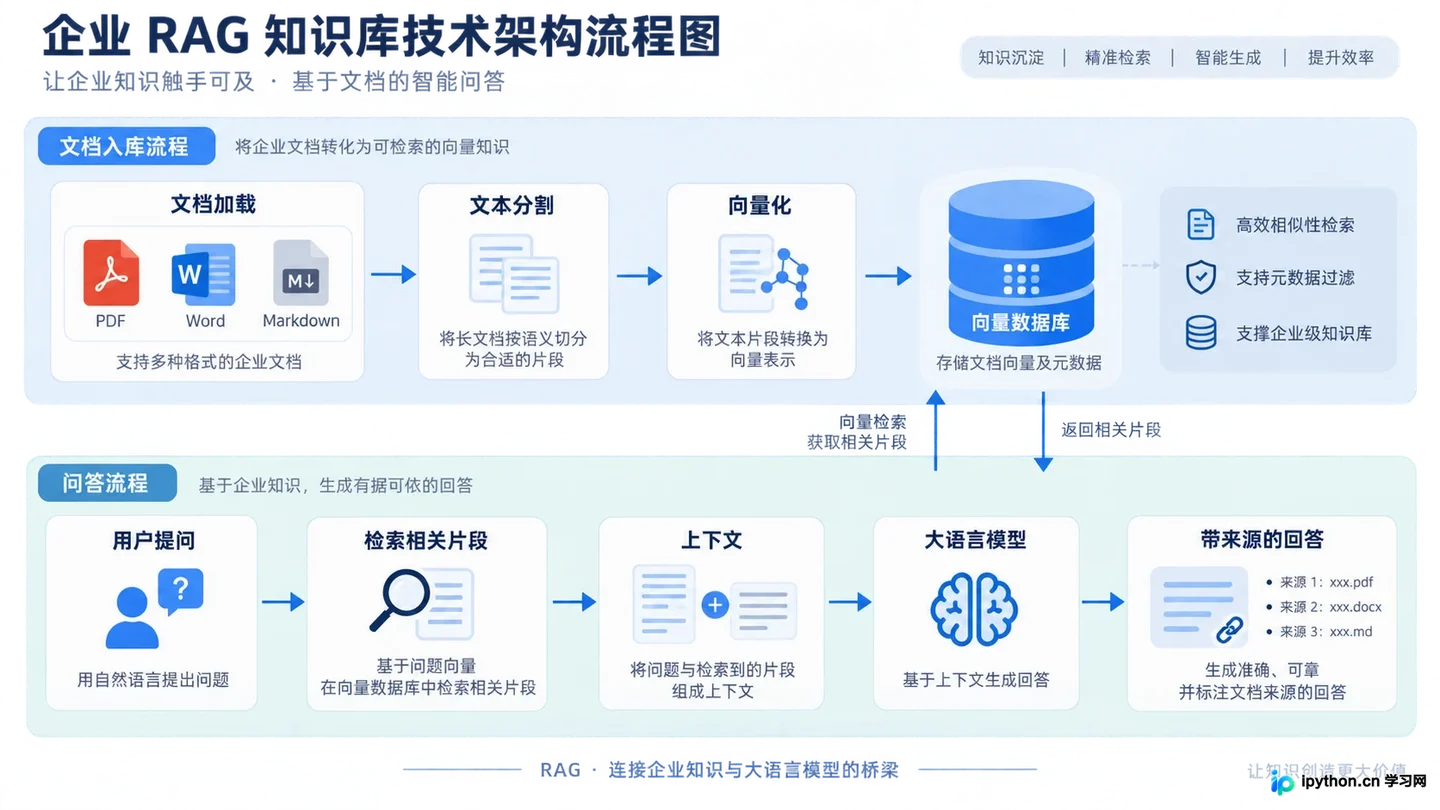
RAG技术工作流程:从文档加载到向量检索再到生成的全过程
实施RAG应用前,需准备结构清晰的企业文档(如PDF、Word、Markdown格式),并部署支持向量检索的数据库及大语言模型接口。核心逻辑是将非结构化文本转化为向量存储,用户提问时系统先检索相关片段,再将其作为上下文输入给模型生成最终回复。
1. 构建动态企业知识库
首先,将分散在各部门的产品手册、售后FAQ和政策文件汇总至统一存储路径。在数据处理阶段,使用文本分割工具将长文档切分为语义完整的短段落,通常每段300-500字,并保留一定的重叠窗口以维持上下文连贯性。
接着,调用嵌入模型(Embedding Model)将这些文本块转化为高维向量,存入向量数据库中。这一步的关键是确保元数据标记准确,例如标注文档来源、更新日期和适用部门,以便后续检索时进行过滤。当新政策发布时,只需重新向量化新增文档并插入数据库,无需重新训练整个模型,实现了知识的秒级更新。
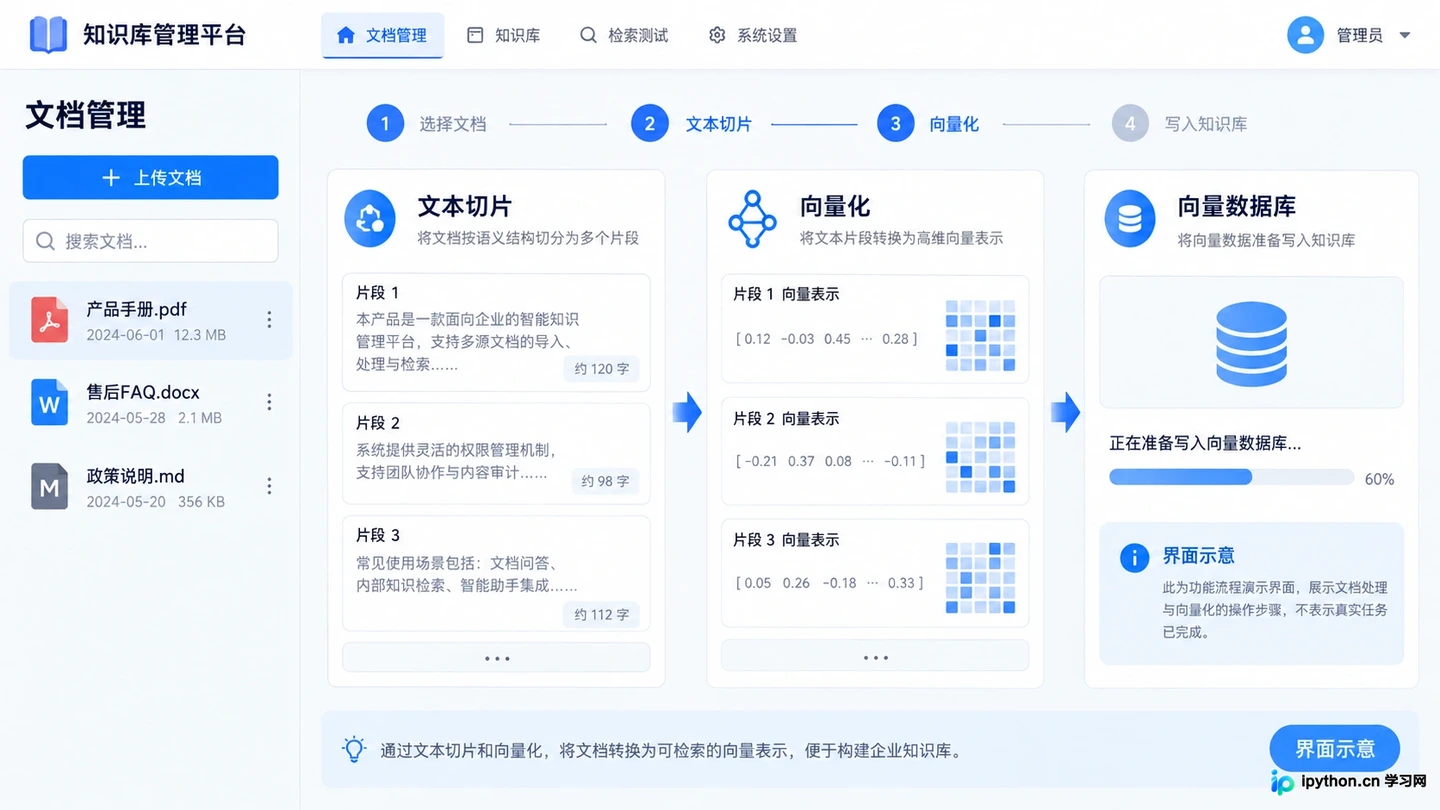
文档切片与向量入库的操作示意
2. 优化智能客服的检索策略
在智能客服场景中,用户提问往往口语化且模糊。系统接收到查询后,首先对问题进行语义重写和扩展,以提高检索命中率。例如,将“怎么退钱”扩展为“退款流程、退货政策、资金到账时间”等相关向量搜索词。
设置相似度阈值是关键步骤。若检索到的文档片段与问题相似度低于设定值(如0.7),系统应直接返回“未找到相关信息”或转接人工,避免强行生成错误答案。对于高匹配度的片段,系统会按相关性排序,选取前3-5个最相关的文本块作为参考上下文。
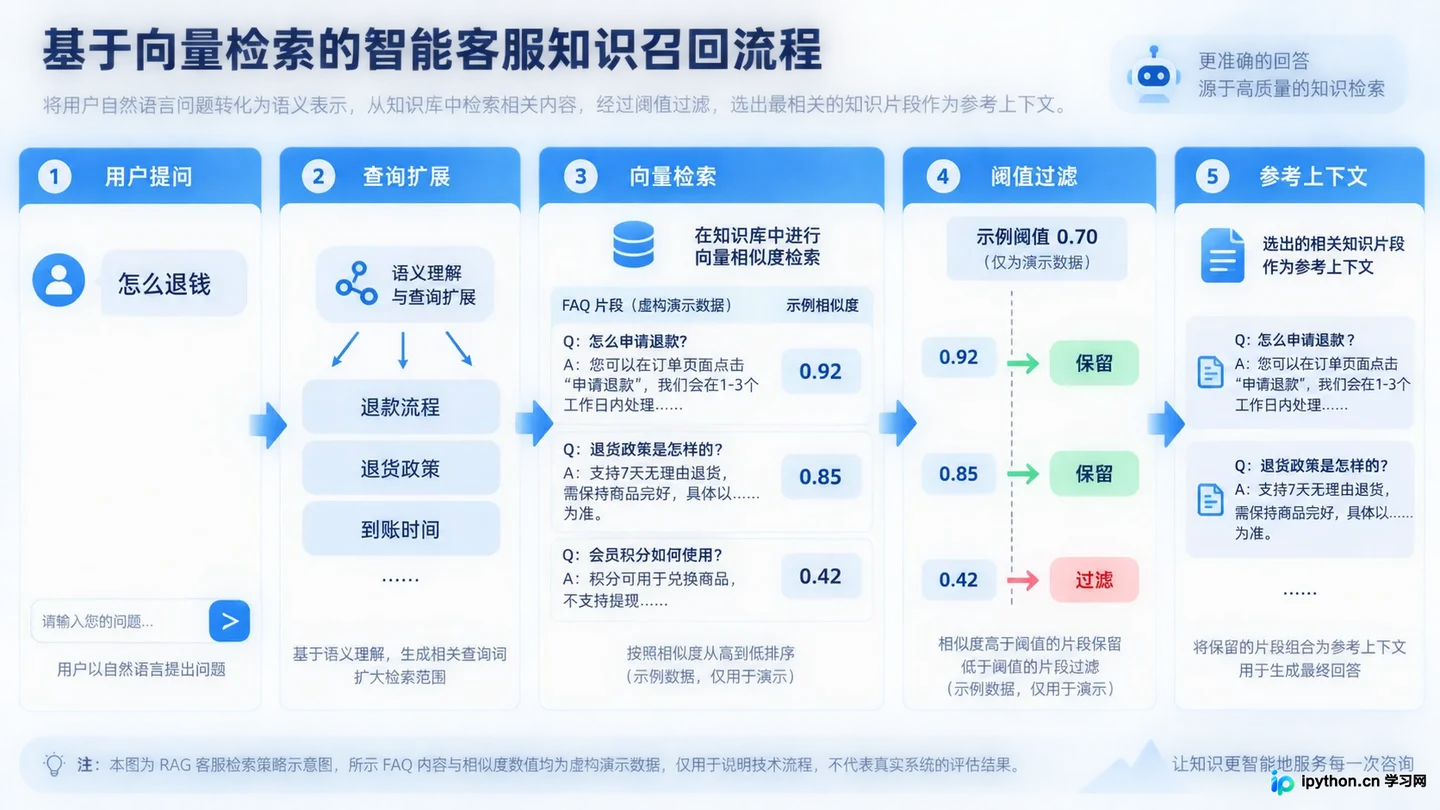
用户提问与向量相似度匹配过程
3. 生成带引用的精准回复
大语言模型接收包含用户问题和检索上下文的提示词模板。指令中需明确要求模型“仅依据提供的上下文回答问题”,并在回答末尾标注信息来源。例如:“根据《2024年售后服务手册》第12页,退款需在7个工作日内申请。”
这种机制不仅提升了回答的可信度,还方便用户核实。在实际测试中,对比未使用RAG的基线模型,采用RAG技术的客服系统在专有名词解释和政策咨询上的准确率提升了40%以上,且完全消除了编造不存在产品的现象。
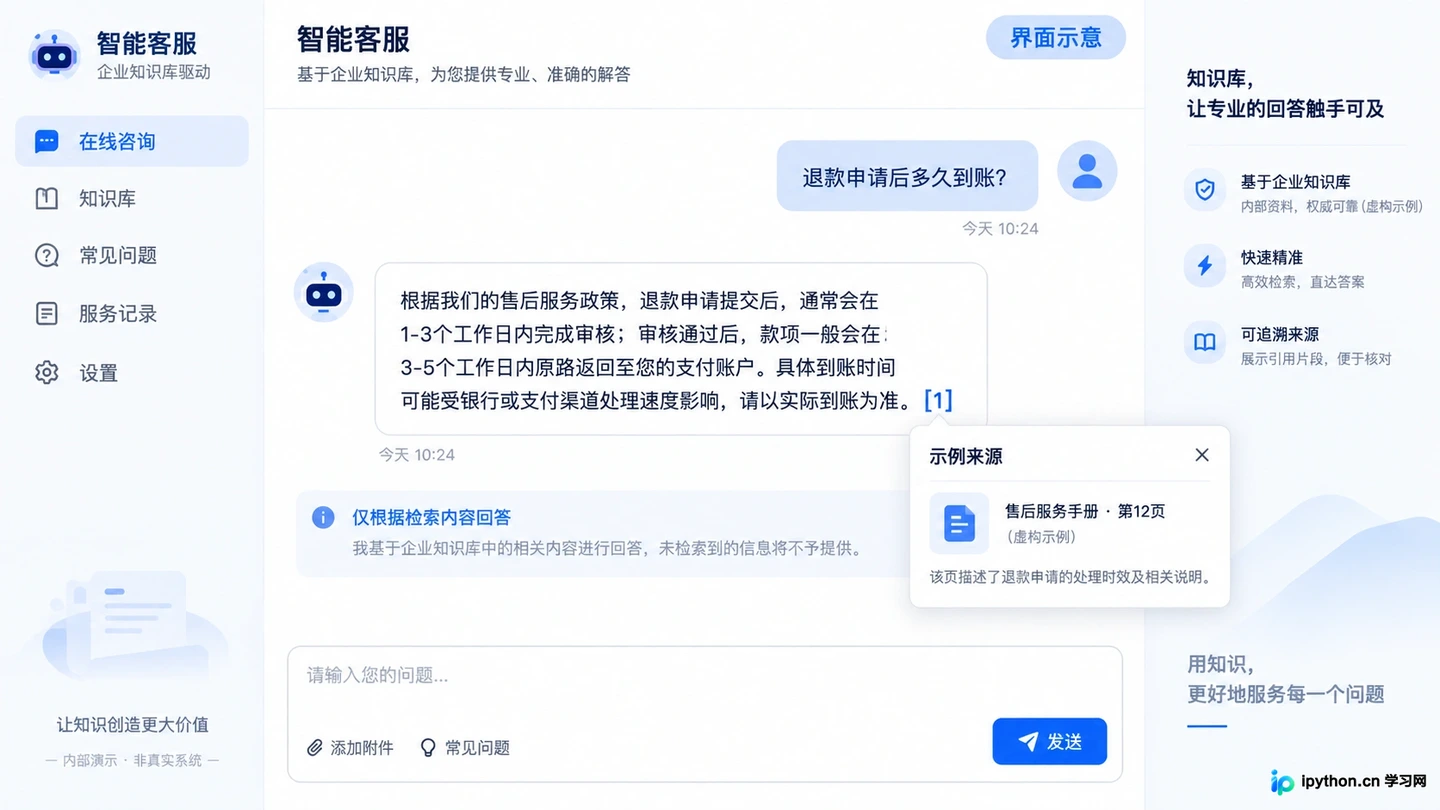
生成包含来源标注的精准回答
4. 验证效果与持续迭代
上线后,通过后台日志监控用户的点赞、点踩及转人工率。针对点踩较多的问答对,分析是检索片段不相关还是模型理解偏差。若是检索问题,需优化文本分割粒度或调整嵌入模型;若是生成问题,则优化提示词工程,增加思维链引导。
定期评估知识库的覆盖率,确保新业务上线时文档同步入库。通过这种闭环反馈机制,RAG系统能够随着企业业务的发展不断自我完善,保持长期的实用性和准确性。
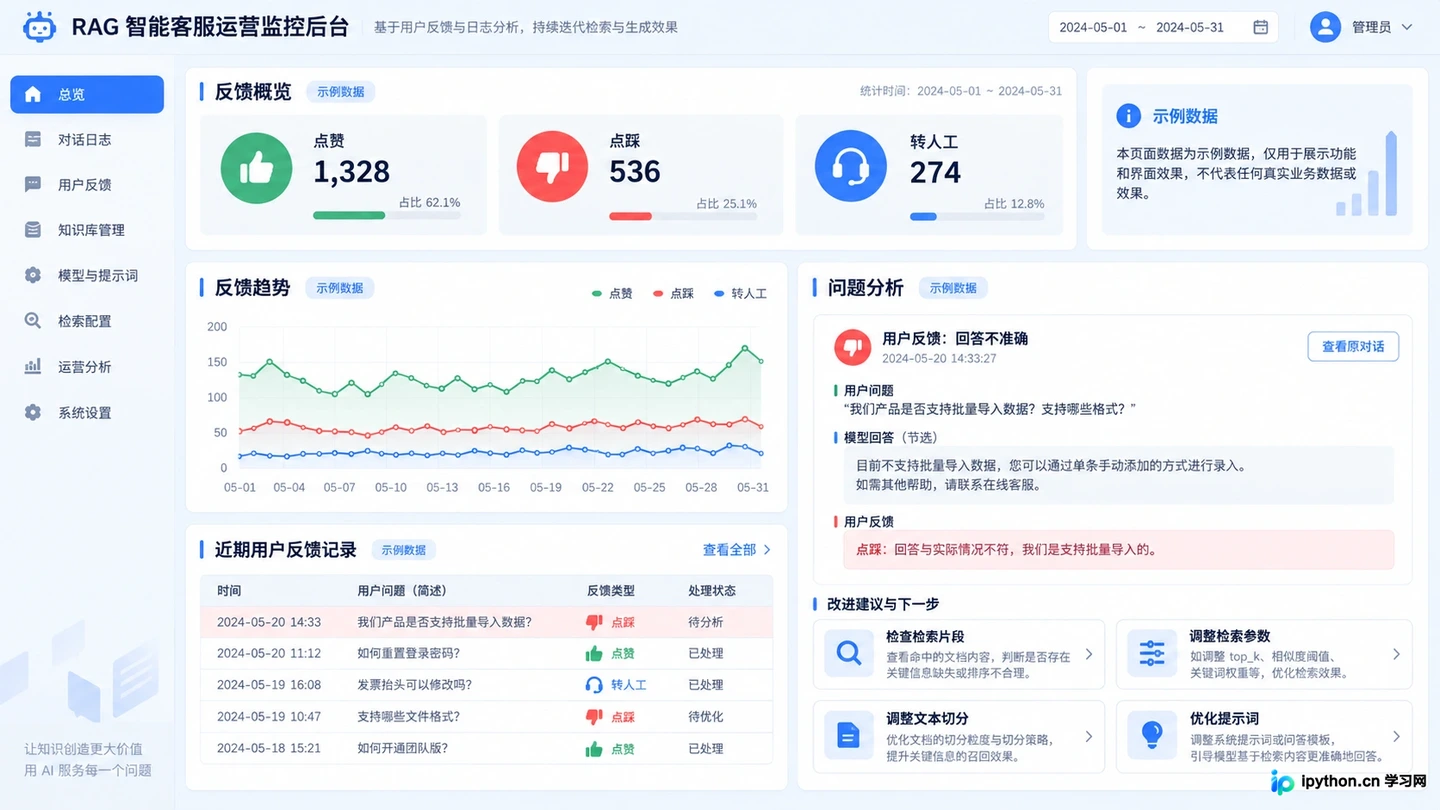
监控用户反馈以优化系统性能
RAG技术通过将静态的大模型能力与动态的企业数据相结合,实现了低成本、高精度的智能服务落地。它不要求企业拥有庞大的算力资源去训练专属模型,而是专注于数据治理和检索链路优化,是当前最具性价比的企业AI应用路径。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









