

Python截取中文乱码怎么办?理解str与bytes的长度区别

在 Python 中对包含中文的数据进行切片截取时出现乱码或 UnicodeDecodeError,核心原因在于在字节序列(bytes)层面上进行了硬截断,导致多字节字符(如常见的 3 字节 UTF-8 中文字符)被从中切开,破坏了字符的编码完整性。如果仅在字符层面(str)操作,Python 3 的切片天然按字符计数,不会切断汉字;乱码通常发生在网络传输、协议解析或限制固定字节存储的场景下。解决这一问题的关键,是厘清 str 与 bytes 的长度定义,并掌握安全切片与容错解码的方法。
一个典型的截取乱码场景
假设我们正在开发一个简易的消息传输模块,为了适配协议规范,限定每次发送的文本载荷最多不能超过 10 个字节。开发者写出了类似下面的处理逻辑:
# 假设待发送的文本内容
text = "你好Python世界"

# 将文本编码为 bytes 并限制前 10 个字节
raw_bytes = text.encode("utf-8")
sliced_bytes = raw_bytes[:10]

# 接收端尝试还原文本
result = sliced_bytes.decode("utf-8")
print(result)
运行这段代码,程序不会打印截取后的文字,而是直接抛出如下异常:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x50 in position 9: unexpected end of data即使在某些情况下指定了忽略或替换错误(如 decode('utf-8', errors='replace')),终端里显示的末尾字符也会变成类似 你好P 的黑菱形乱码。问题究竟出在哪里?这需要从 Python 中字符串与字节流的本质区别谈起。
关键概念:str 长度与 bytes 长度的区别
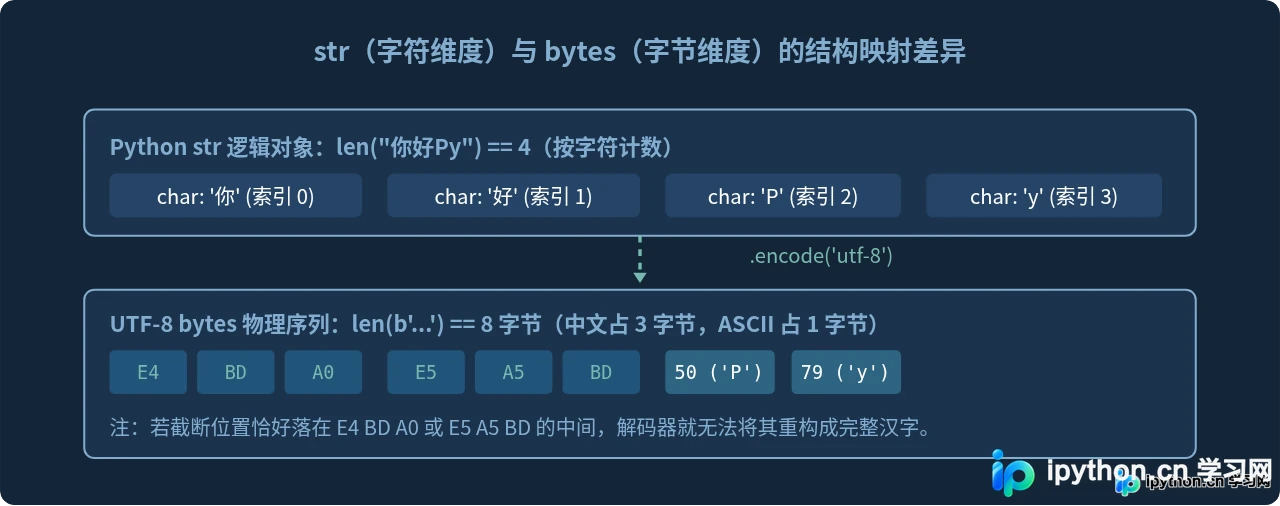
在 Python 3 中,文本由 str 类型表示,其底层是抽象的 Unicode 码位(Code Point);而计算机磁盘、网络套接字中读写的数据由 bytes 类型表示,代表物理存储的一组 8 位二进制字节。
len(str)统计的是字符数量:无论该字符是 ASCII 字母、标点还是复杂汉字,在str体系中都只算作 1 个字符长度。len(bytes)统计的是字节数:字符串经过编码(Encode)转换成物理字节后,每个字符占用的字节数取决于编码规则。在互联网主流的UTF-8编码下,标准 ASCII 字符占 1 字节,而常用汉字通常占用 3 个字节。
乱码的根本原因:多字节字符被截断
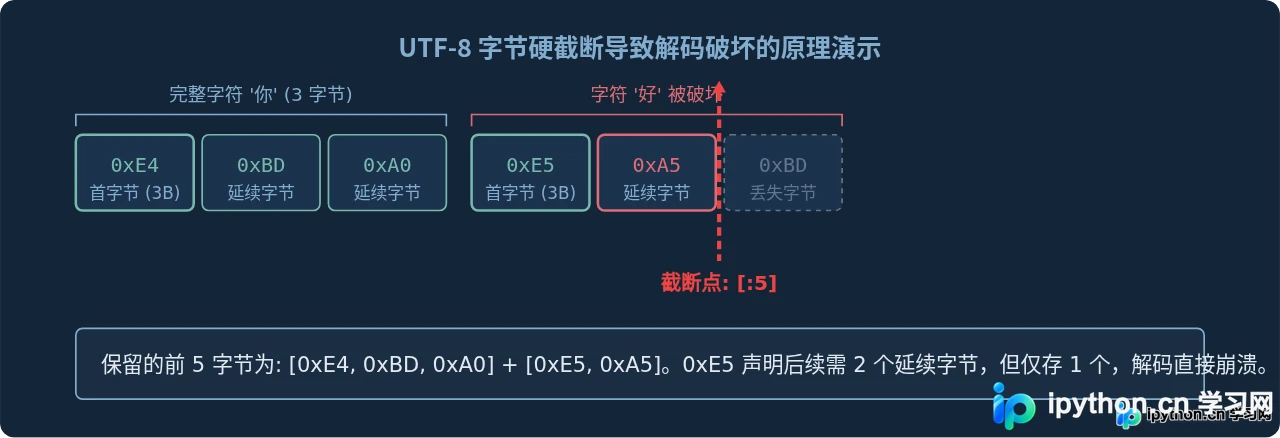
UTF-8 是一种可变长字符编码。为了使解码器能准确拆分每一个字符,UTF-8 为每个字节的高位设定了明确标记:
- 单字节字符(ASCII):最高位为
0(形如0xxxxxxx)。 - 多字节起始字节(Leading Byte):高位 1 的数量代表该字符的总字节数。例如中文三字节字符的首字节固定为
1110xxxx(十六进制以E开头)。 - 多字节延续字节(Continuation Byte):高位固定为
10xxxxxx(十六进制通常在80到BF之间)。
当开发者执行 raw_bytes[:k] 时,切片索引 k 是按照纯字节位置计算的。如果 k 恰好落在一个汉字的中间字节(即第 2 或第 3 字节),切片结果就会丢失后续字节。剩下的残缺字节序列不再符合 UTF-8 编码规范,解码器自然直接报错。
排查与解决方法
要彻底解决中文截取乱码问题,首先要明确业务截取的目标依据:是基于字符数量截断,还是基于存储/协议的字节长度截断?
情况一:仅限制文本可读字符数量(在 str 层面截取)
如果业务目标只是限制用户界面上显示的文字个数(例如标题只显示前 10 个字),切勿先调用 encode() 再切片。直接在 str 对象上使用 Python 标准切片语法,Python 会自动以字符为单位进行切分,天然免疫乱码。
# 正确做法:直接在 str 层面按字符切片
text = "你好Python世界"
safe_str = text[:4]

print(safe_str)
# 预期输出示例: 你好Py
# 实际长度 len(safe_str) 为 4 个字符
情况二:受到外部协议严格限制,必须按字节截断
在网络数据包头部、固定长度数据库字段(如 MySQL 的某些存储规格)或硬件接口中,往往强制限制总 Payload 不超过 N 字节。此时,切片后不能盲目解码,需要采用“安全回退截断”算法。
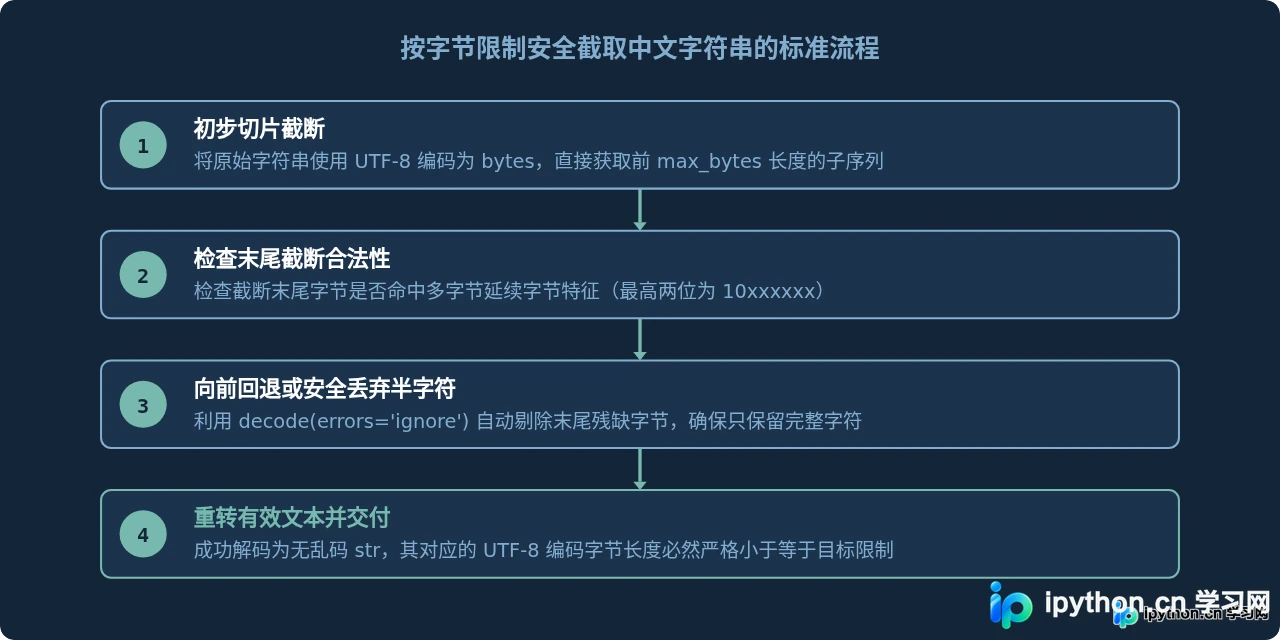
在 Python 中,实现上述安全截断有两种最常用的工程解法:
解法 A:利用解码器 errors='ignore' 机制(简洁推荐)
Python 的内置解码器提供错误处理策略。对切片后的字节序列直接使用 decode('utf-8', errors='ignore'),它会在遇到无法拼装成完整字形的末尾悬空字节时,自动将其丢弃,从而保证还原出的 str 纯净完整。
def truncate_by_bytes(text: str, max_bytes: int, encoding: str = "utf-8") -> str:
    """
    按最大字节长度截取字符串,避免中文半字乱码
    """
    encoded = text.encode(encoding)
    if len(encoded) <= max_bytes:
        return text

    # 截取 max_bytes 后忽略末尾不成字的破损片段
    truncated_bytes = encoded[:max_bytes]
    return truncated_bytes.decode(encoding, errors="ignore")

# 运行验证
raw = "你好Python世界"
# '你' (3) + '好' (3) + 'P' (1) + 'y' (1) + 't' (1) + 'h' (1) = 10 字节
# 若限制为 5 字节,只够容纳 '你'(3),'好' 需 3 字节装不下
print("限制 10 字节:", repr(truncate_by_bytes(raw, 10)))
print("限制 5 字节:", repr(truncate_by_bytes(raw, 5)))
示例输出:
限制 10 字节: '你好Pyth'
限制 5 字节: '你'
解法 B:逐字追加测算(适合对字符完整度有严格审查的交互层)
如果不想经过字节切割后再解码,可以在字符序列上遍历,累计每个字符编码后的字节增量,一旦达到上限立即终止。
def truncate_str_by_bytes_loop(text: str, max_bytes: int, encoding: str = "utf-8") -> str:
    current_bytes = 0
    result_chars = []

    for ch in text:
        ch_bytes_len = len(ch.encode(encoding))
        if current_bytes + ch_bytes_len > max_bytes:
            break
        result_chars.append(ch)
        current_bytes += ch_bytes_len

    return "".join(result_chars)
常见开发注意事项
errors='replace': 在协议序列化或截取环节,若指定 errors='replace',末尾的残余字节会被解码为 \ufffd(即显示为“”)。不仅破坏展示外观,还会让替换字符本身额外占用 3 个字节(在 UTF-8 下),甚至可能导致截取后的总字节数反超原限制。
- GBK 与 UTF-8 编码差异:国内一些老旧系统或 Windows 控制台常用 GBK 编码。GBK 中中文通常占 2 个字节,而 UTF-8 占 3 个字节。做字节截断时,必须显式传入对应的
encoding标识,不可依赖操作系统默认值。 - 协议填充边界:若系统要求严格固定字节长度(如不足 100 字节必须补齐),应在安全截取并解码后,再重新编码并对
bytes进行右侧填充(例如使用b'\x00'或空格),而不是直接对包含中文的str做ljust。
总结
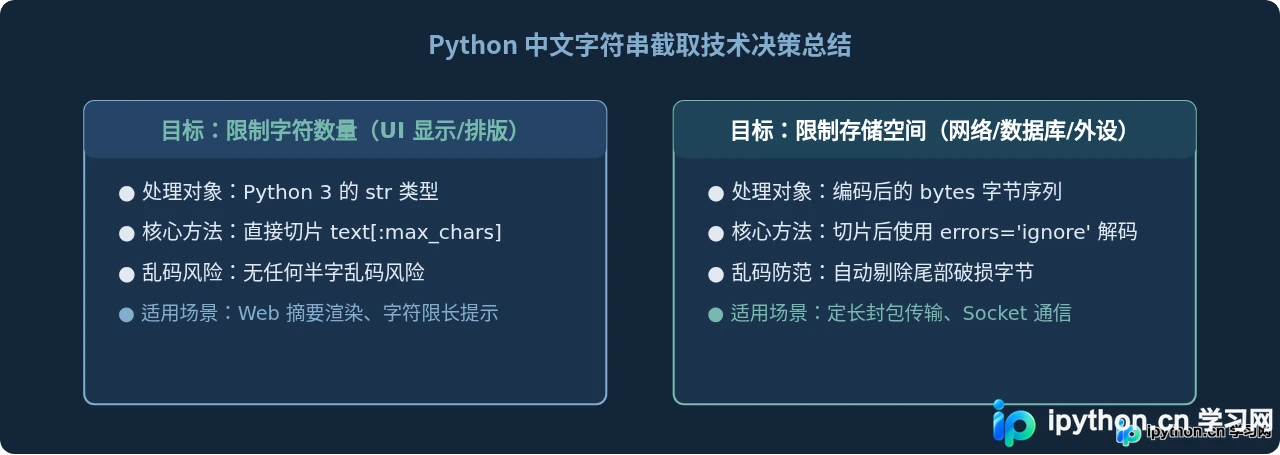
Python 截取中文导致乱码的根本原因,是在多字节编码(如 UTF-8)的 bytes 数据上执行了盲目切片,把属于同一个字符的连续字节强行劈开。
只要理清 len(str)(字符个数)与 len(bytes)(物理字节数)的界限,就能根据需求快速对症下药:纯文本展示直接对 str 做切片,协议限长则利用 encode()[:N].decode(errors='ignore') 剔除尾部半字。把握好编码转换的位置与策略,中文处理中的截断乱码问题便能彻底规避。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









