

MySQL Shell import_table:高效并发数据导入与性能对比

MySQL Shell的parallel table import utility(import_table)是8.0.23版本后完善的高效数据导入工具。它支持并发导入、多文件模糊匹配、速率控制及自定义chunk大小,并能通过JSON配置灵活处理字段映射与数据转换。相比传统LOAD DATA,在相同条件下其导入速度可提升一倍以上。
import_table核心功能介绍
import_table作为MySQL Data Load的强力替代方案,主要解决大规模数据快速入库及复杂ETL预处理需求。其核心特性包括:
- 并发导入:默认开启多线程并发(threads参数),支持自定义线程数与chunk大小,显著提升I/O利用率。
- 多文件批量处理:支持通过通配符(如
*.csv)同时导入结构一致的多个文件至同一张表,便于数据汇总。 - 资源限速:提供
maxRate参数,可按需限制每个线程或总体的导入带宽,避免阻塞生产环境。 - 格式兼容:原生支持CSV、TSV、JSON等常见格式,支持处理压缩文件(如gz),无需预先解压。
- 向下兼容:支持将数据导入MySQL 5.7及以上版本。
基础导入:字段映射与数据处理
为了演示import_table的数据处理能力,我们以经典的 employees 数据集为例。假设源数据为CSV格式,而目标表包含一些源文件中不存在的衍生字段或需要格式转换的字段。
第1步:准备测试数据与表结构
源数据 employees_01.csv 包含员工编号、出生日期、名、姓、性别和入职日期。目标表 emp 在此基础上增加了 full_name、modify_date 和 delete_flag 三个字段。
# 源数据示例 (employees_01.csv)
"10001","1953-09-02","Georgi","Facello","M","1986-06-26"
"10003","1959-12-03","Parto","Bamford","M","1986-08-28"
... ...
-- 目标表结构 (desc emp)
+-------------+---------------+------+-----+---------+-------+
| Field | Type | Null | Key | Default | Extra |
+-------------+---------------+------+-----+---------+-------+
| emp_no | int | NO | PRI | NULL | |
| birth_date | date | NO | | NULL | |
| first_name | varchar(14) | NO | | NULL | |
| last_name | varchar(16) | NO | | NULL | |
| full_name | varchar(64) | YES | | NULL | | -- 需合并生成
| gender | enum('M','F') | NO | | NULL | |
| hire_date | date | NO | | NULL | |
| modify_date | datetime | YES | | NULL | | -- 自动记录时间
| delete_flag | varchar(1) | YES | | NULL | | -- 基于日期逻辑判断
+-------------+---------------+------+-----+---------+-------+第2步:使用LOAD DATA INFILE导入(传统方式)
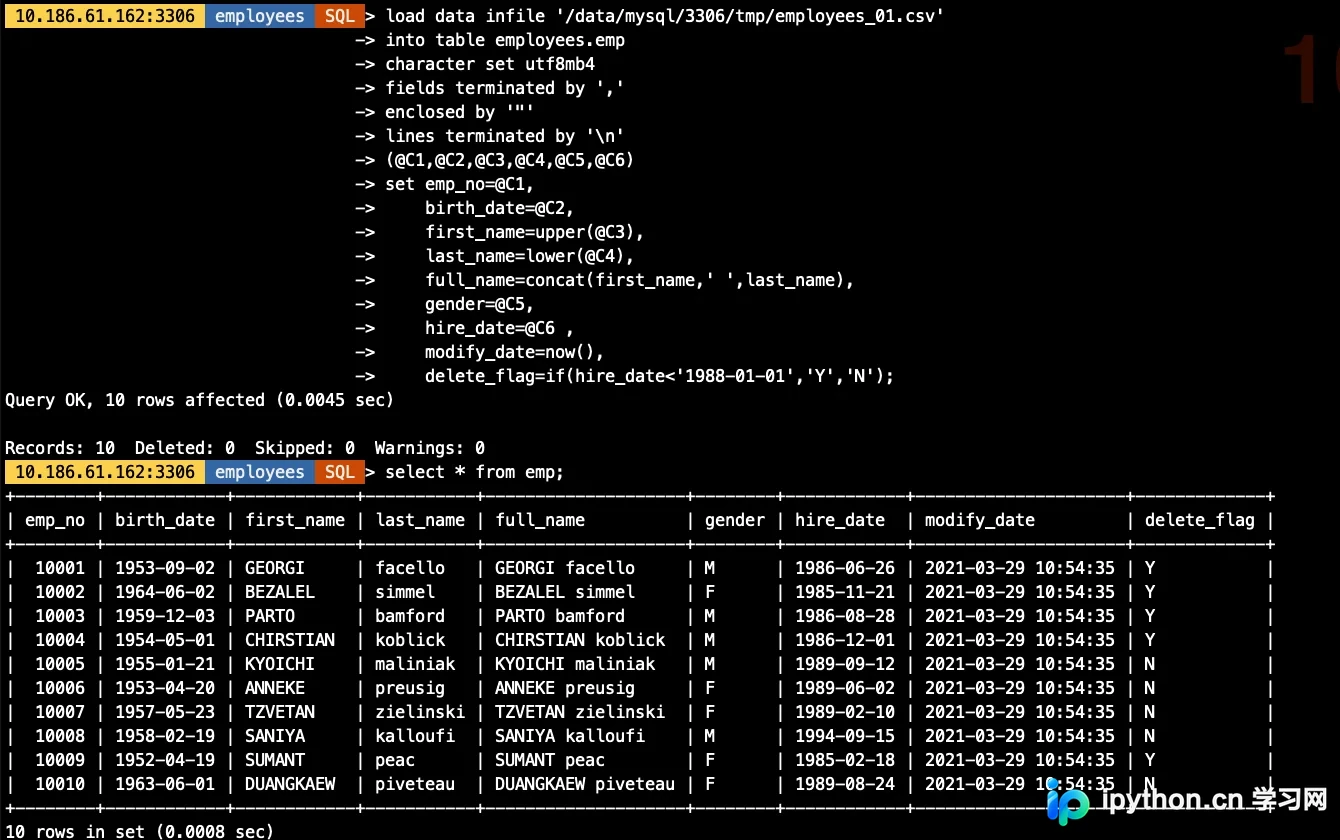
传统方法需使用用户变量接收每一列,再通过 SET 子句进行函数调用、拼接或逻辑赋值。代码如下:
load data infile '/data/mysql/3306/tmp/employees_01.csv'
into table employees.emp
character set utf8mb4
fields terminated by ','
enclosed by '"'
lines terminated by '\n'
(@C1,@C2,@C3,@C4,@C5,@C6)
set emp_no=@C1,
    birth_date=@C2,
    first_name=upper(@C3),
    last_name=lower(@C4),
    full_name=concat(first_name,' ',last_name),
    gender=@C5,
    hire_date=@C6 ,
    modify_date=now(),
    delete_flag=if(hire_date<'1988-01-01','Y','N');
第3步:使用import_table导入(推荐方式)
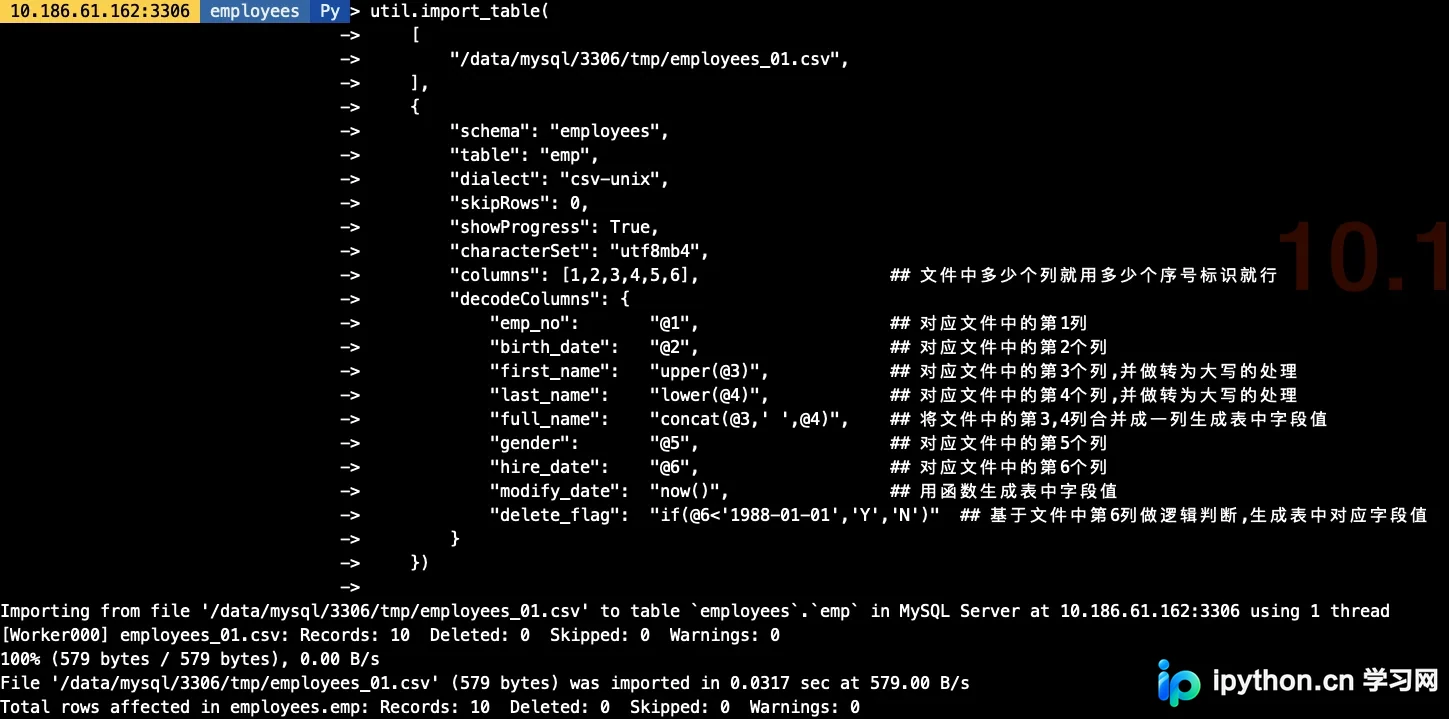
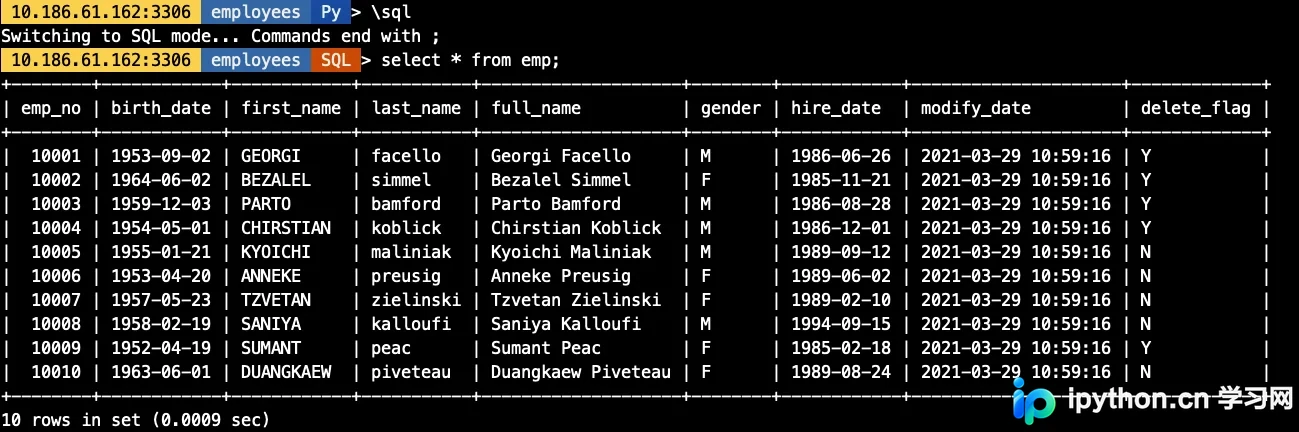
import_table通过Python风格的字典配置 decodeColumns,可直接引用源文件的列序号(@1~@N),并在配置中直接书写SQL表达式或函数,更加直观且易于维护。
util.import_table(
    [
        "/data/mysql/3306/tmp/employees_01.csv",
    ],
    {
        "schema": "employees",
        "table": "emp",
        "dialect": "csv-unix",  # 定义CSV分隔符和编码风格
        "skipRows": 0,
        "showProgress": True,
        "characterSet": "utf8mb4",
        "columns": [1,2,3,4,5,6],                   # 映射源文件的物理列索引
        "decodeColumns": {                          # 目标表字段映射规则
            "emp_no":       "@1",                   # 直接对应第1列
            "birth_date":   "@2",                   # 直接对应第2列
            "first_name":   "upper(@3)",            # 第3列转大写
            "last_name":    "lower(@4)",            # 第4列转小写
            "full_name":    "concat(@3,' ',@4)",    # 合并第3、4列生成全名
            "gender":       "@5",                   # 直接对应第5列
            "hire_date":    "@6",                   # 直接对应第6列
            "modify_date":  "now()",                # 使用当前时间戳
            "delete_flag":  "if(@6<'1988-01-01','Y','N')" # 基于第6列逻辑计算标记
        }
    })
高级特性:并发、限速与批量处理
第4步:多文件通配符导入
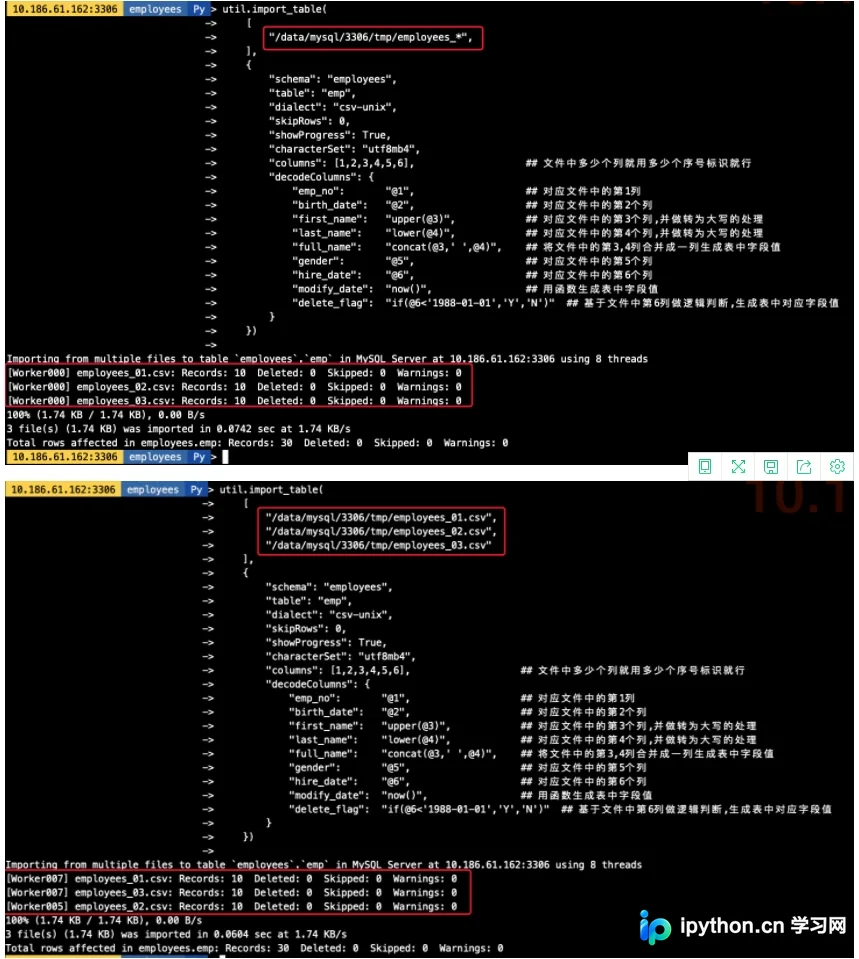
当需要将分散在多份CSV中的数据汇入一张总表时,可使用通配符路径。import_table会自动读取所有匹配文件并按顺序处理。
# 匹配目录下的所有employees开头的CSV文件
util.import_table(
    [
        "/data/mysql/3306/tmp/employees_*",  # 支持通配符
    ],
    {
        "schema": "employees",
        "table": "emp",
        "dialect": "csv-unix",
        "skipRows": 0,
        "showProgress": True,
        "characterSet": "utf8mb4",
        "columns": [1,2,3,4,5,6],
        "decodeColumns": {
            "emp_no":       "@1",
            "birth_date":   "@2",
            "first_name":   "upper(@3)",
            "last_name":    "lower(@4)",
            "full_name":    "concat(@3,' ',@4)",
            "gender":       "@5",
            "hire_date":    "@6",
            "modify_date":  "now()",
            "delete_flag":  "if(@6<'1988-01-01','Y','N')"
        }
}) 
第5步:调整并发线程数
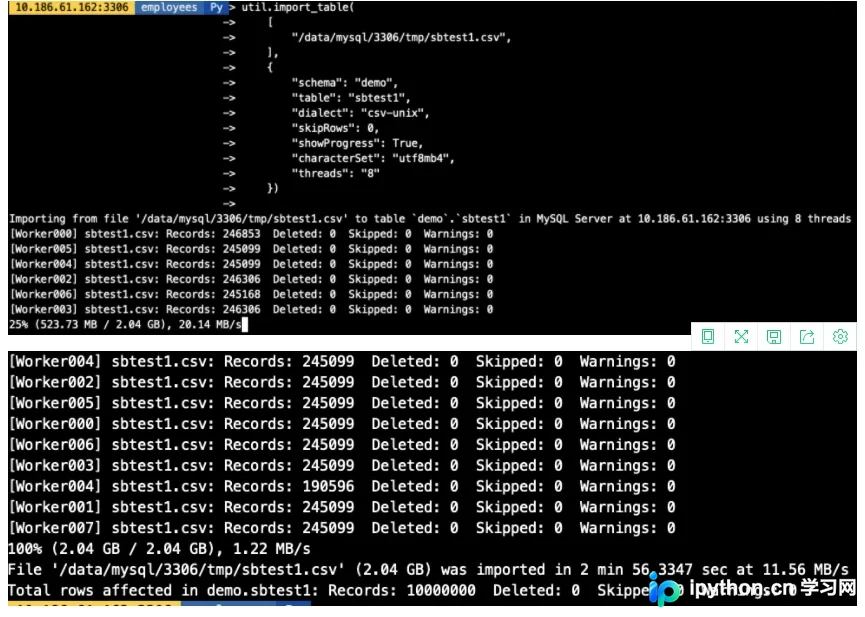
默认情况下,threads 参数设为8。对于大型数据文件,适当增加线程数可以充分利用磁盘I/O和CPU资源。此处以创建一个约1000万行、2GB大小的 sbtest1 测试表为例,显式设置并发数为8。
util.import_table(
    [
        "/data/mysql/3306/tmp/sbtest1.csv",
    ],
    {
        "schema": "demo",
        "table": "sbtest1",
        "dialect": "csv-unix",
        "skipRows": 0,
        "showProgress": True,
        "characterSet": "utf8mb4",
        "threads": "8"  # 设置8个并发线程
}) 
第6步:控制导入速率(MaxRate)
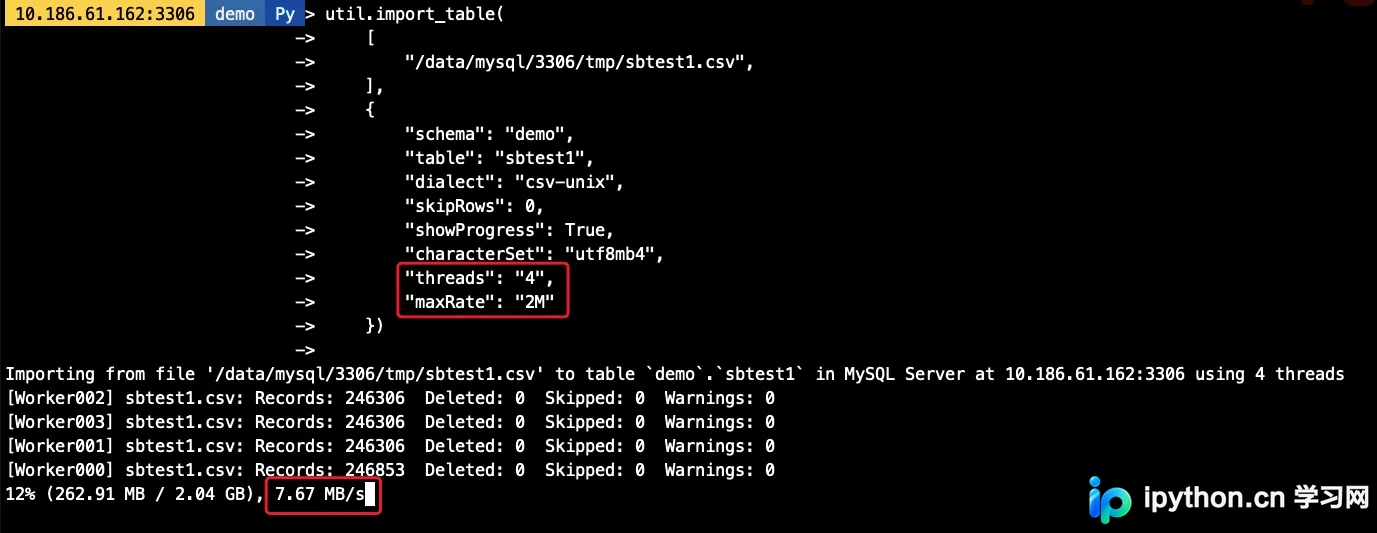
在生产环境中,为防止导入操作耗尽服务器带宽或I/O带宽,可通过 maxRate 限制速度。例如,设置4个线程,每个线程限速2MB/s,则总吞吐量控制在8MB/s左右。
util.import_table(
    [
        "/data/mysql/3306/tmp/sbtest1.csv",
    ],
    {
        "schema": "demo",
        "table": "sbtest1",
        "dialect": "csv-unix",
        "skipRows": 0,
        "showProgress": True,
        "characterSet": "utf8mb4",
        "threads": "4",
        "maxRate": "2M"  # 限制每个线程的传输速率为2MB/s
    })
第7步:自定义Chunk大小
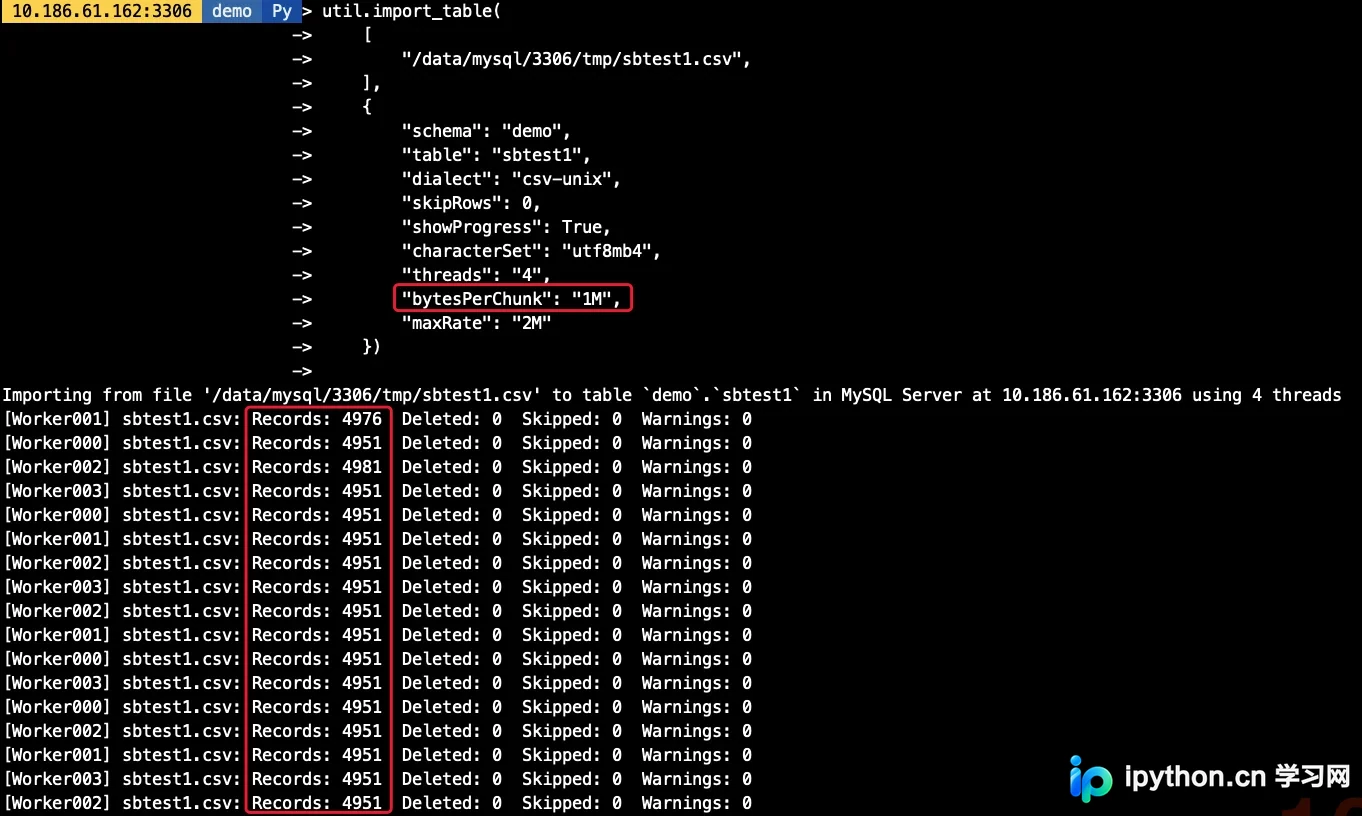
bytesPerChunk 决定了单个事务的大小。默认的Chunk为50MB。减小此值(如设为1MB)可以降低单次事务对锁资源的占用,减少长事务风险,适用于对数据库负载敏感的场景。
util.import_table(
    [
        "/data/mysql/3306/tmp/sbtest1.csv",
    ],
    {
        "schema": "demo",
        "table": "sbtest1",
        "dialect": "csv-unix",
        "skipRows": 0,
        "showProgress": True,
        "characterSet": "utf8mb4",
        "threads": "4",
        "bytesPerChunk": "1M",  # 每1MB数据作为一个独立事务提交
        "maxRate": "2M"
    })
性能对比:Load Data vs import_table
为了验证效率差异,我们在同一虚拟机环境下(磁盘IO受限),对1.9GB的测试数据进行纯导入测试(无字段转换,保持默认参数)。结果显示:
- LOAD DATA INFILE:耗时约5分钟。单线程串行处理,难以跑满硬件性能。
- import_table:耗时不到2.5分钟。得益于多线程并发写入,在相同硬件下效率提升超过一倍。
-- 对比实验命令
-- 1. Load Data
load data infile '/data/mysql/3306/tmp/sbtest1.csv'
into table demo.sbtest1
character set utf8mb4
fields terminated by ','
enclosed by '"'
lines terminated by '\n'

-- 2. import_table
util.import_table(
    [
        "/data/mysql/3306/tmp/sbtest1.csv",
    ],
    {
        "schema": "demo",
        "table": "sbtest1",
        "dialect": "csv-unix",
        "skipRows": 0,
        "showProgress": True,
        "characterSet": "utf8mb4"
    })
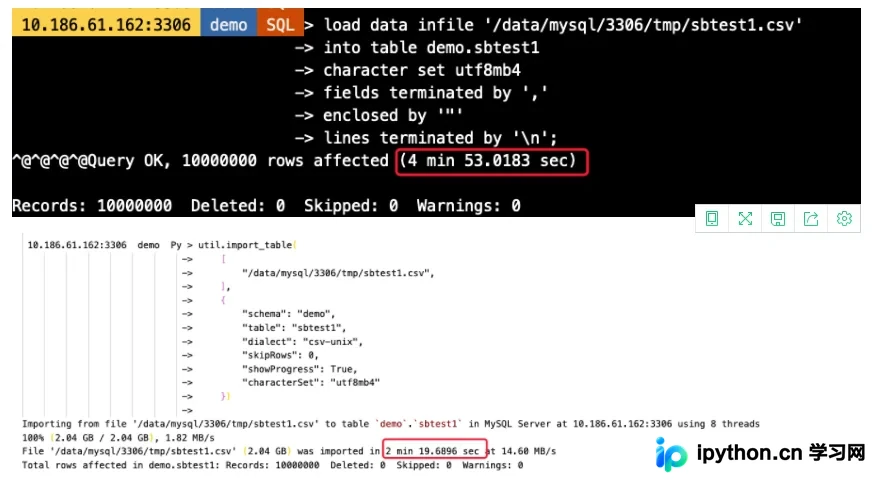
综合来看,import_table 不仅在配置语法上更贴近现代编程习惯,且在处理海量数据时提供了显著的性能优势和更灵活的控流手段,是MySQL管理员和数据工程师进行批量化数据迁移的理想选择。
以上就是MySQL Shell import_table数据导入详情的详细内容,更多关于import_table数据导入的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









