

Python中使用正则表达式精准匹配IP地址
本文详细介绍如何利用Python内置re模块编写正则表达式,实现对IPv4和IPv6地址的精确匹配、字符串验证及日志提取。涵盖数字段拆分逻辑、边界符使用及常见陷阱,并提供实际项目中的优化方案。
2026-10-11
39
本文详细介绍如何利用Python内置re模块编写正则表达式,实现对IPv4和IPv6地址的精确匹配、字符串验证及日志提取。涵盖数字段拆分逻辑、边界符使用及常见陷阱,并提供实际项目中的优化方案。
针对Python中正则表达式如何精准提取和匹配中文汉字的问题,本文提供两种主流实现路径。通过调用内置re模块,分别采用Unicode标准编码范围与直写字面量区间的方式,配合findall函数过滤混合文本中的非中文字符。代码已适配Python 3环境,附带完整示例与参数解析,可直接复制用于爬虫清洗或数据校验场景。

本文介绍Python中正则表达式的基础概念,包括原子、元字符及模式修正符。重点讲解如何实现字符串的重叠匹配,并详细解析re模块中search、match、compile、findall及sub等常用函数的用法与参数,帮助开发者高效进行文本提取与清洗。
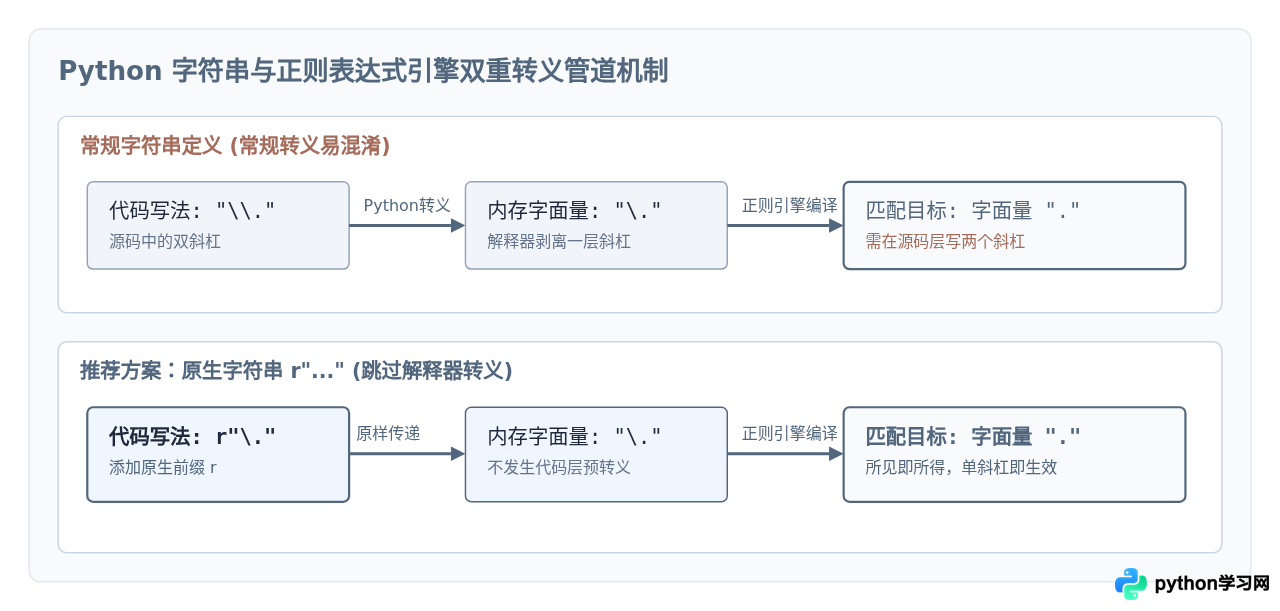
针对Python中使用re模块匹配点号、星号、美元符、反斜杠及方括号等特殊字符时常见的报错与匹配落空问题,系统分析双重转义机制与元字符特性,提供原生字符串r前缀、反斜杠转义与re.escape动态处理方案。
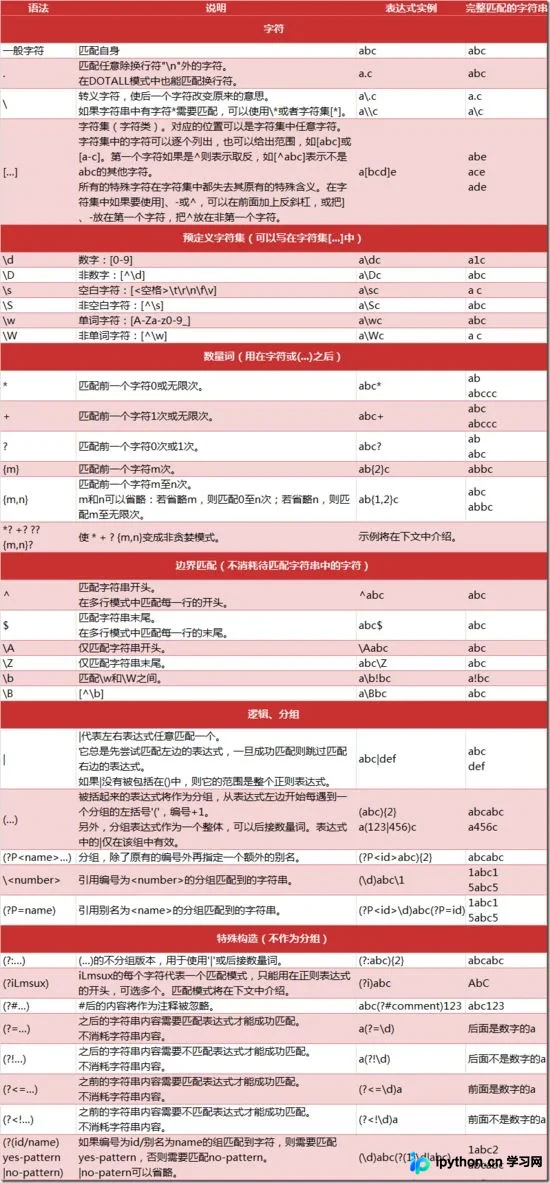
本文详解Python中re模块的核心用法,涵盖match与search的区别、贪婪与非贪婪匹配、分组提取及编译优化。通过HTML解析、字符串替换等实例,演示如何高效利用正则表达式进行数据抓取与处理,助力爬虫开发。
本文介绍如何利用 Python 正则表达式精准匹配字符串中的 HTTP 及 HTTPS 链接。通过编译特定模式,可有效识别包含特殊字符、百分号编码及子域名的 URL。示例代码展示了从文本中提取短链接的全过程,为网络爬虫和数据清洗提供实用参考。
本文介绍Python中使用正则表达式匹配日期与时间的方法,涵盖日期格式如2016-12-12及带时间的2016-12-12 14:34的匹配模式。同时解析原生字符串r的作用,说明其如何简化反斜杠转义处理,避免多重转义带来的困扰,提升代码可读性与准确性。
本文介绍在Python中使用正则表达式匹配以https?://开头、以jpg/png/jpeg结尾的字符串,并排除空格及引号等干扰字符的方法。通过实例演示从基础表达式到优化表达式的过程,展示如何利用[^ ",]排除特定字符,实现精准匹配。
本文详细解析Python中Beautiful库如何结合Lambda表达式进行网页数据抓取。通过具体案例演示如何利用匿名函数筛选具有特定属性数量的标签,并展示如何用Lambda替代内置find_all参数。此外,还介绍了结合正则表达式匹配属性字符串模式的进阶用法,帮助开发者灵活处理复杂的HTML解析需求。
Python 正则表达式在进行文本处理时至关重要。本文详细拆解了 re 模块的核心操作,包括利用 search() 快速定位、findall() 批量提取、sub() 智能替换与 split() 灵活切割。结合动态回调函数与预编译优化策略,帮助开发者编写高可读性且高性能的数据清洗代码。
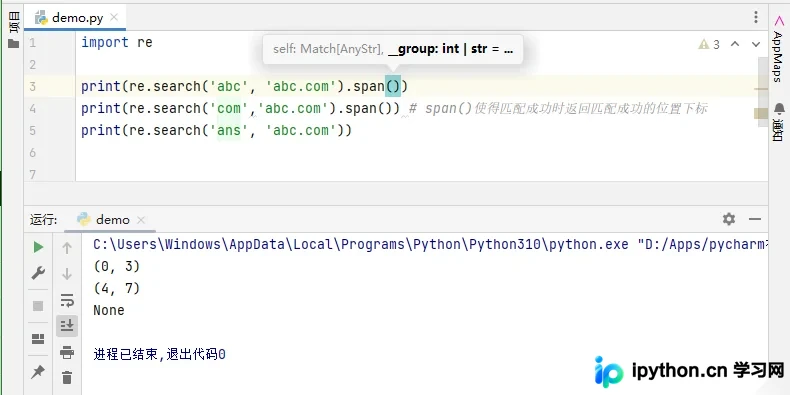
本文介绍如何在Python中使用正则表达式匹配以特定关键词开头的字符串。通过re.compile定义模式,利用finditer遍历匹配项并提取内容。示例展示了匹配成功与失败的情况,并提供了在线测试工具链接供参考。
本文深入解析Python中正则表达式精准匹配时间格式的方法。通过对比基础匹配与严格范围校验,详细拆解时、分、秒的正则逻辑,并提供完整代码示例及在线测试工具推荐,帮助开发者避免无效时间格式匹配,提升数据处理的准确性。