


基于pandas将类别属性转化为数值属性的方法
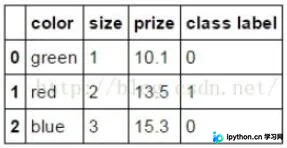
在数据预处理中,将类别属性转化为数值属性是常见需求。本文介绍两种基于pandas的处理方法:针对无大小意义的离散特征使用get_dummies进行One-Hot编码;针对有大小意义的特征,通过字典映射将其转换为有序的数值。
2026-10-11
7
在数据预处理中,将类别属性转化为数值属性是常见需求。本文介绍两种基于pandas的处理方法:针对无大小意义的离散特征使用get_dummies进行One-Hot编码;针对有大小意义的特征,通过字典映射将其转换为有序的数值。
计算机在存储和传输文本时依赖特定规则进行字节映射。本文详解Python中字符编码、Base64、URL及Hex等数据转换方法,结合encode与decode函数演示实际用法,并提供文件读写配置与异常处理策略,帮助开发者高效解决乱码问题并保障跨平台数据兼容性。
本文通过Flask框架实现一个完整的登录案例,详细讲解如何处理POST请求。内容涵盖应用目录创建、路由配置、模板渲染、重定向逻辑以及前端表单交互,帮助开发者掌握Flask中POST请求的处理机制。
面对GB级文本、CSV或二进制文件,一次性加载极易引发内存溢出。本文系统梳理Python中高效处理大型文件的7种核心方案,涵盖逐行迭代、固定分块读取、内存映射、Pandas/Numpy分批解析及随机访问技巧。提供完整代码模板与适用场景对照,帮助开发者根据数据类型灵活选型,显著提升I/O性能与程序稳定性。
本文总结了Python中保存文件的几种常用方法,包括使用pickle模块保存为二进制文件、使用numpy保存为npz格式以及使用pandas保存为csv格式。文章提供了具体的代码示例,帮助读者快速掌握这些技术。
本文深入解析Python中函数调用的四种核心参数传递机制。通过具体代码示例,详细阐述位置参数、带默认值的参数、不定长位置参数(*args)以及不定长关键字参数(**kwargs)的定义与调用规则。重点说明参数名称匹配的重要性、元组与字典在内部存储的差异,以及调用时指定或省略参数的灵活性,帮助开发者掌握Python函数调用的最佳实践。
本文介绍如何使用Python的OpenCV库读取摄像头视频流,并通过cv2.imwrite函数将捕获的图像保存为本地文件。代码示例展示了实时显示与批量保存图像的基本流程,适用于简单的图像采集任务。
掌握Python列表的循环遍历与嵌套结构是数据处理的基础。本文详细说明如何通过while和for语句高效遍历列表,演示嵌套列表的创建与逐层访问方法,并结合分组查找及办公室人员随机分配等实际场景,提供可直接运行的代码示例与核心操作要点。
梳理Python的import底层原理,解析sys.modules缓存与路径搜索逻辑。结合importlib模块,演示运行时动态加载第三方库、构建轻量级插件系统以及安全重置模块状态的具体操作步骤与代码实现。
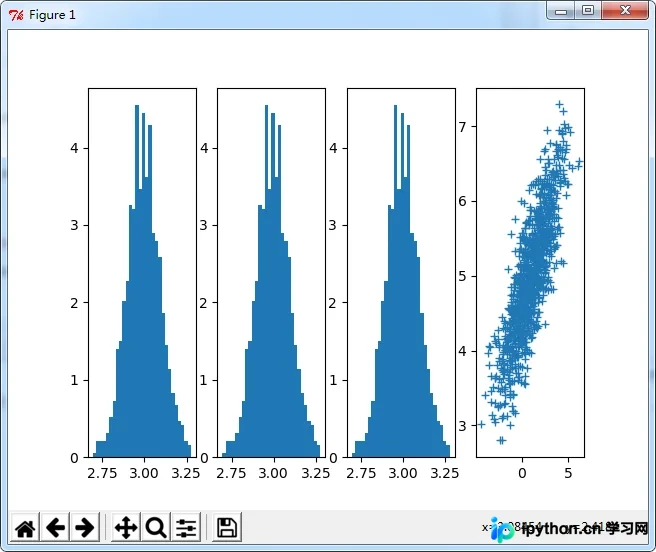
本文介绍如何在Python中使用numpy库生成正态分布随机数。通过示例演示一维正态分布的三种等效生成方式,以及利用Cholesky分解生成二维正态分布矩阵的方法,并包含概率密度函数的绘制代码。
本文介绍如何利用Python的pandas库处理爬虫获取的小型非结构化数据。通过示例演示如何安装pandas及依赖库openpyxl,并将字典列表转换为DataFrame后,直接导出为Excel、HTML或CSV格式文件,实现数据的直观展示与分析。
Python 的 socket 模块提供底层网络通信接口。基于 TCP 协议搭建稳定的客户端与服务端,需依次完成套接字创建、地址与端口绑定、监听分发、数据收发及连接释放。本文通过完整代码演示如何利用 threading 实现服务端并发处理,明确各核心参数的作用范围,并附带运行验证结果与常见断连排错方法。