Python数据清洗与处理的常用方法详解
在数据分析与建模前,原始数据常伴随缺失、重复、异常及格式混乱等问题。本文基于Python生态,系统梳理数据清洗的标准流程:涵盖缺失值的删除与多维填充、重复记录的清除与标记、异常值的阈值控制、类型转换与文本清洗,以及分组统计、连续变量分箱和特征归一化。掌握这些操作可快速提升数据质量,保障后续分析结果的可靠性。
2026-10-11
7
在数据分析与建模前,原始数据常伴随缺失、重复、异常及格式混乱等问题。本文基于Python生态,系统梳理数据清洗的标准流程:涵盖缺失值的删除与多维填充、重复记录的清除与标记、异常值的阈值控制、类型转换与文本清洗,以及分组统计、连续变量分箱和特征归一化。掌握这些操作可快速提升数据质量,保障后续分析结果的可靠性。
本文介绍如何使用 Python 的 requests 库来测试代理 IP 是否生效。通过配置代理字典和请求头,向icanhazip.com发起GET请求,并打印返回的IP地址。若返回的IP与代理IP一致,则说明代理设置成功。
本文介绍在 Python 中将字符串转换为整型和浮点型的两种主要方式。针对 Python 2.6 之前的版本,推荐使用 string 模块中的 atoi 和 atof 函数;而在 Python 2.6 及更高版本中,则直接使用内置的 int() 和 float() 函数。文章提供了具体的代码示例,展示了如何处理包含小数点的字符串转换及结果差异。
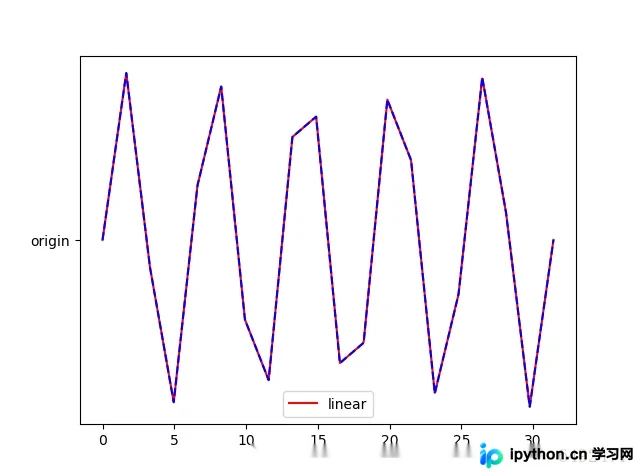
本文介绍如何在Python中使用SciPy库进行数据插值。通过scipy.interpolate.interp1d函数,分别演示了线性插值和三次样条插值的实现方法,并提供了完整的代码示例及可视化结果。
介绍在Python中如何准确测量代码执行时间。指出传统time.time()方法易受系统干扰且精度不足,进而详解timeit模块的核心参数、timeit()与repeat()函数的实际调用方式,以及命令行界面的快捷用法,帮助开发者高效进行代码性能基准测试与算法对比。
本文深入解析Python中实现全排列的两种核心方法:基于递归交换的手动算法与标准库itertools的高效实现。通过列表与字符串的具体案例,展示如何生成所有排列组合,并详细讲解递归逻辑、闭包变量修改技巧以及itertools.permutations函数的参数用法,帮助开发者根据场景选择最优方案。
本文详细解析 Flask-Principal 扩展的基本用法,涵盖安装、核心组件(Identity、Needs、Permission)及配置流程。通过完整代码示例,演示如何结合 Flask-Login 实现用户登录、权限信号监听及基于角色的访问控制(如 Admin 权限拦截),帮助开发者快速构建安全的 Flask 应用。
本文介绍如何使用Python统计代码文件中的代码、注释及空行数量。核心难点在于准确识别单行注释(#)与多行文档字符串('''或""")。通过遍历文件并维护一个状态变量,可以准确计算各类行数。
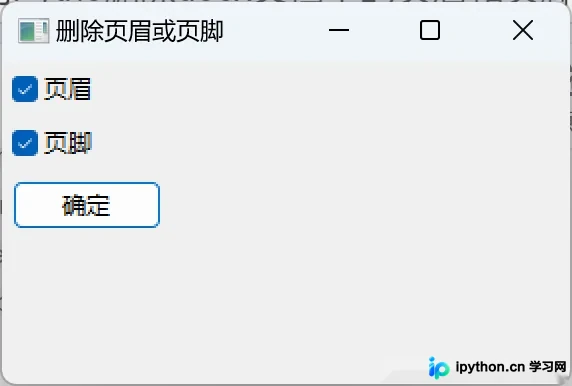
本文介绍如何使用Python结合wxPython与python-docx库,快速清理Word文档中的页眉和页脚内容。通过搭建轻量级图形界面,用户可一键导入指定文件并勾选目标区域,程序将自动遍历文档节并清空对应段落文本,最终另存为新文件,大幅降低人工编辑成本。
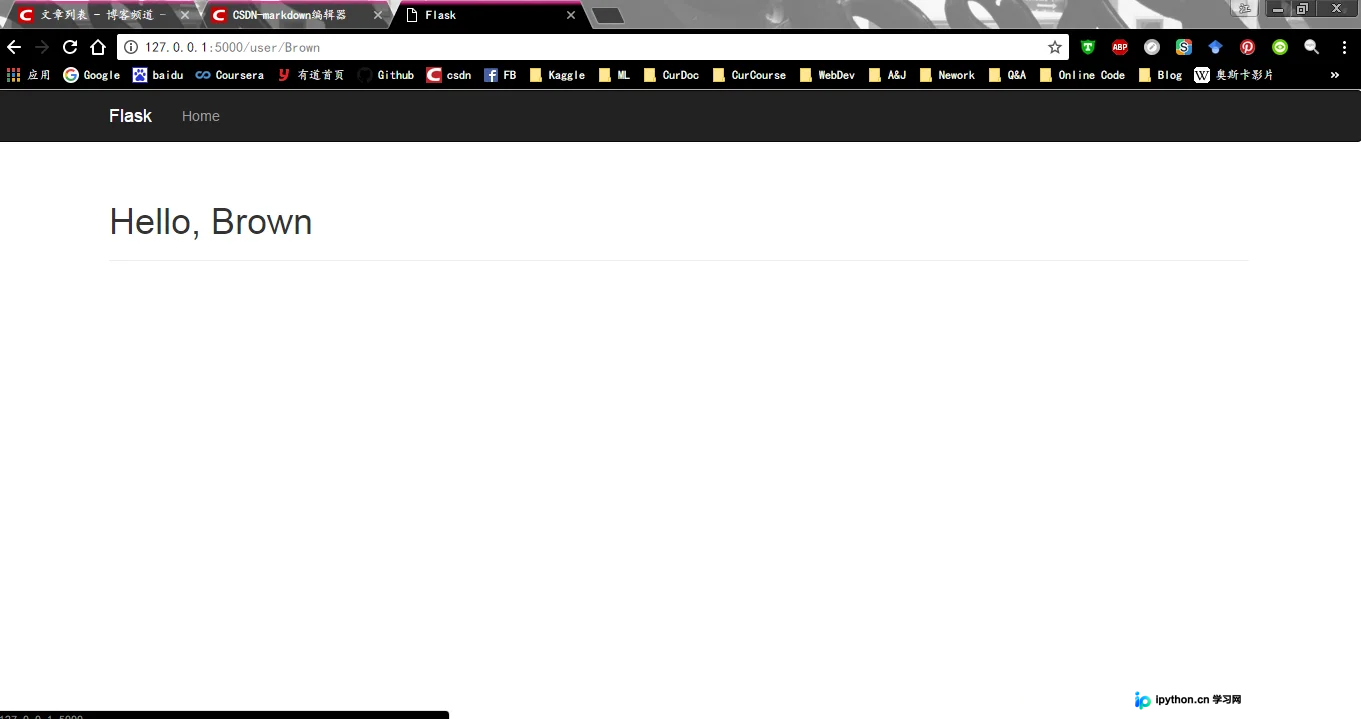
本文详细讲解如何在 Flask 项目中集成 Bootstrap 框架。通过安装 flask-bootstrap 库,复制基础模板文件,并编写自定义 HTML 模板与 Python 路由代码,实现带有导航栏和动态内容的 Web 页面。
本文深入解析Python中的复杂异常处理机制,系统讲解基础捕获结构、显式与隐式异常链、自定义异常设计、日志记录与重新抛出等进阶技巧。结合上下文管理器、装饰器及性能对比测试,提供可直接复用的工程化实践方案。
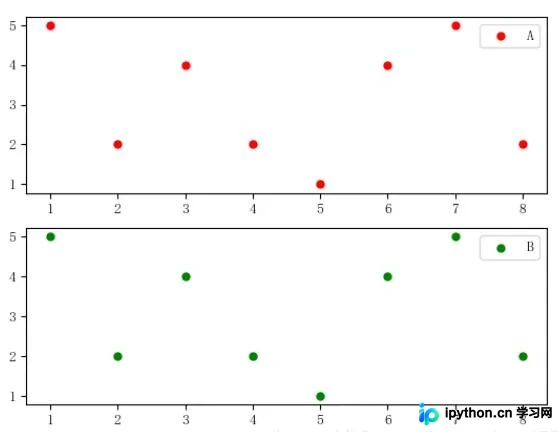
本文介绍在 matplotlib 中为子图添加图例的两种方法。第一种通过 plt.legend() 手动指定句柄和标签;第二种在绘图时直接设置 label 参数并调用 plt.legend()。文章提供了完整的代码示例及效果说明,帮助开发者快速掌握子图图例的添加技巧。