


Scrapy爬虫框架核心架构解析与实战项目搭建指南
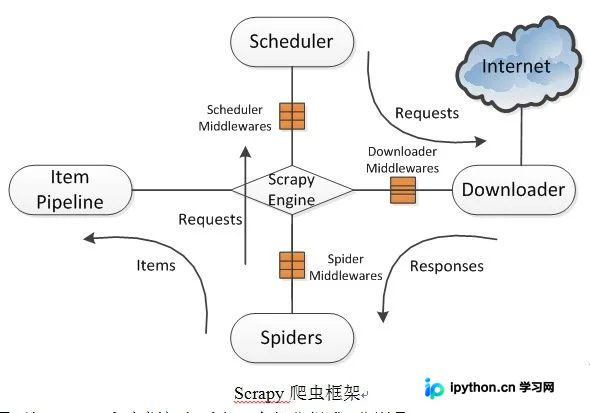
本文深入解析Scrapy网络爬虫框架的工作原理,详细阐述引擎、调度器、下载器、蜘蛛及管道五大核心组件的交互流程。同时提供基于Scrapy创建爬虫项目的完整命令行操作指南,涵盖项目结构解析、关键配置文件说明及程序执行方法,帮助开发者快速掌握Scrapy的数据采集与处理流程。
2026-10-13
8
本文深入解析Scrapy网络爬虫框架的工作原理,详细阐述引擎、调度器、下载器、蜘蛛及管道五大核心组件的交互流程。同时提供基于Scrapy创建爬虫项目的完整命令行操作指南,涵盖项目结构解析、关键配置文件说明及程序执行方法,帮助开发者快速掌握Scrapy的数据采集与处理流程。
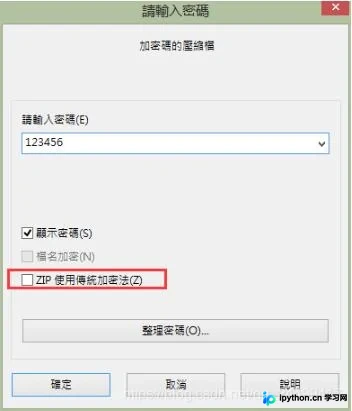
本文通过实例演示使用Python zipfile模块读取带密码ZIP文件的过程。发现默认压缩算法会导致RuntimeError: Bad password错误,而勾选“ZIP使用传统加密法”后可正常读取。结论指出zipfile模块仅支持传统加密方式,为处理加密压缩包提供明确参考。
本文详细介绍Python中的基本数据类型,重点解析整型(int)的定义、创建方法及加减乘除幂运算。深入探讨可变与不可变对象的区别,解释内存管理机制,并演示如何将整型转换为字符串,帮助开发者掌握Python基础编程核心概念。
本文介绍使用Python和pandas库将ARFF格式文件转换为CSV文件的完整代码示例。通过读取ARFF文件内容,按逗号分割数据并存入DataFrame,最终保存为CSV格式,适用于简单的数据格式转换需求。
本文介绍利用Python读取包含多个Sheet的Excel文件并合并数据的方法。通过xlrd获取工作表列表,结合pandas逐表读取并忽略指定行,最终使用dropna清理缺失值。该方法适用于需要整合分散在多个工作表中数据的场景,代码示例展示了核心处理逻辑。
本文介绍在Python中将文本文件数据转换为NumPy矩阵的两种常用方法。第一种通过手动读取、按行和空格分割字符串后构建列表再转为数组,适用于简单格式但需注意后续运算限制;第二种利用NumPy内置的loadtxt函数直接解析带分隔符的文件,支持直接进行数学运算。文中提供了具体代码示例及注意事项,帮助开发者根据实际需求选择合适方案。
本文介绍了在Python中读取CSV和TXT文件并将其转换为向量格式的具体实现。通过对比发现,直接读取CSV文件虽能获取数据但类型为字符串,而使用NumPy处理TXT文件则能保持数值类型并直接生成向量,适合需要数值计算的场景。
本文提供使用Python绘制二元函数三维图像的完整代码示例。通过导入NumPy和Matplotlib库,利用meshgrid创建网格数据,并调用Axes3D的plot_surface方法渲染曲面。代码展示了基础的数据生成与可视化流程,适用于初步学习Python科学计算与图形绘制。
本文介绍如何在Python3中通过ctypes模块调用C语言编写的动态库,并传递字符串类型的列表。通过示例展示了C端接收char指针数组以及Python端构造c_char_p数组的具体实现方式,帮助开发者解决跨语言调用中字符串列表传递的问题。
本文介绍如何在Python中使用ctypes模块获取NumPy数组的内存指针,以便与C语言进行交互。核心步骤包括确保数组为C连续内存,通过ctypes.data属性获取地址并转换为C指针类型,最后演示如何访问数组元素。
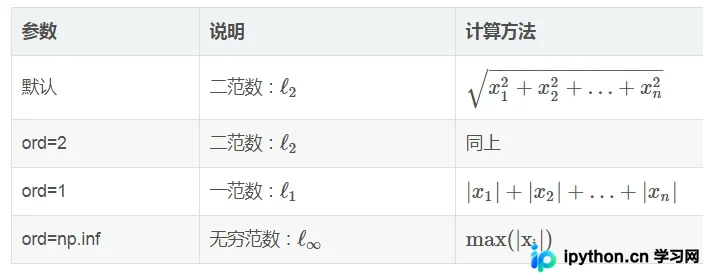
本文详细介绍Python中NumPy库的矩阵(matrix)与数组(array)的区别及转换方法。涵盖zeros、ones、eye等常见矩阵创建函数,深入解析矩阵乘法、点乘、求逆与转置运算。同时讲解nonzero索引、矩阵切片、合并分割以及范数计算等核心技巧,帮助开发者高效处理数值计算任务。
本文介绍如何在Python中通过ctypes调用C++动态库,实现整数数组的传递以及图像数据的处理。示例展示了如何定义C类型数组、赋值并调用C函数,同时C++端接收数组参数并处理图像文件,返回处理后的数据。