


Python 实现 URL 重定向并获取真实地址及重试机制
本文介绍在 Python 项目中处理 URL 重定向以获取真实地址的方法。通过 requests 库发送请求并提取最终 URL,同时补充了包含最大重试次数限制和状态码检查的完善代码,确保在网络异常时能自动重试,提高获取真实链接的稳定性。
2026-10-13
7
本文介绍在 Python 项目中处理 URL 重定向以获取真实地址的方法。通过 requests 库发送请求并提取最终 URL,同时补充了包含最大重试次数限制和状态码检查的完善代码,确保在网络异常时能自动重试,提高获取真实链接的稳定性。
本文介绍如何使用Python的yagmail库简化邮件发送流程。通过对比传统smtplib的复杂配置,展示yagmail仅需三行代码即可实现邮件发送。重点解析SMTP初始化参数及send方法中的收件人、主题、正文和附件设置,并详细说明邮箱授权码的获取方式,帮助开发者高效完成自动化邮件任务。
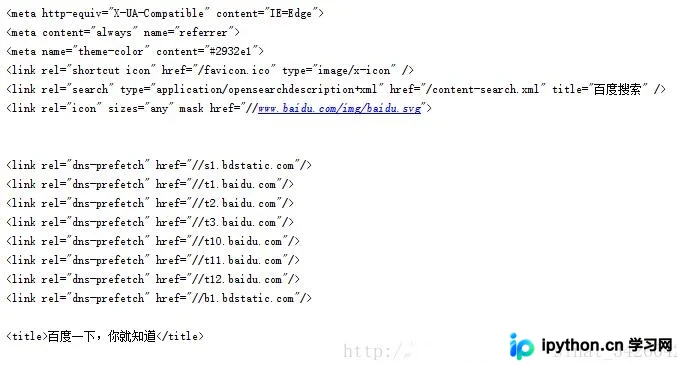
本文分析Python爬虫中中文显示乱码的根本原因,即默认Unicode解析与系统编码格式不匹配。通过示例代码展示如何利用urllib获取网页,将UTF-8内容解码后重新编码为系统默认格式,从而完美解决中文输出乱码问题,适用于百度等常见网页抓取场景。
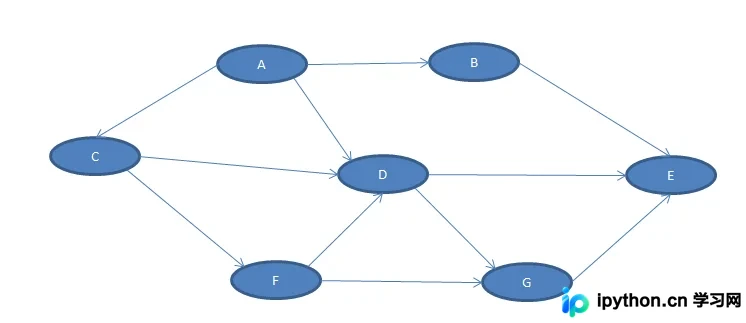
本文通过Python代码实例,详细演示了如何在图数据结构中查找起点到终点的所有路径。利用深度优先搜索(DFS)递归算法遍历节点,避免回路,并输出按路径长度排序的结果。代码包含图的定义、递归搜索逻辑及主程序调用,适合学习Python数据结构与算法的开发者参考。
本文介绍在Python中执行Shell命令的两种常见方法:一是通过subprocess模块捕获标准输出和错误流,将执行结果保存为字符串;二是将命令的标准输出和错误重定向至指定日志文件。文中提供了完整的代码示例,展示了如何处理进程状态及资源释放,适用于需要自动化执行系统命令并持久化结果的场景。
本文详解Python3中urllib与http模块的使用方法。urllib包负责URL处理,包含request、error和parse等子模块,支持通过urlopen打开网页及urlretrieve下载文件。http包提供底层HTTP协议封装,如HTTPConnection用于发送GET/POST请求并获取响应状态码及内容。文章结合代码实例,帮助开发者掌握网络编程基础。
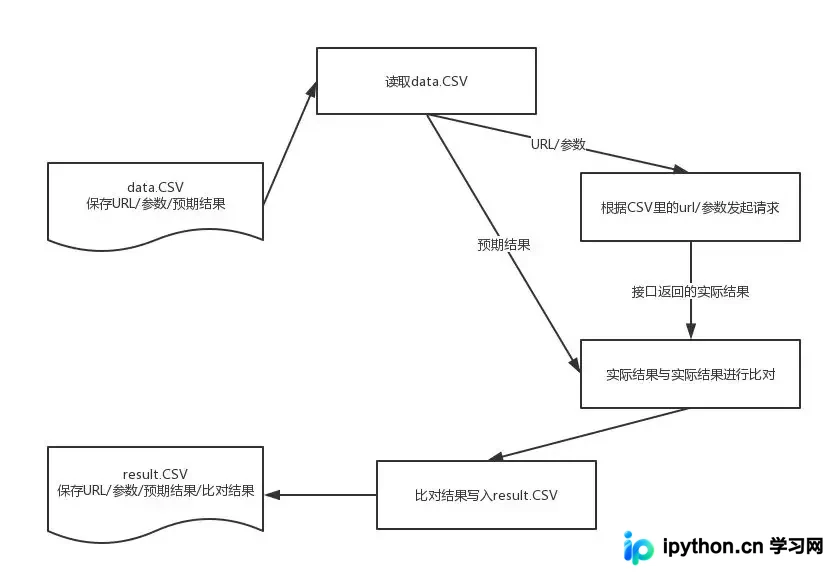
本文介绍如何使用Python结合csv和requests库,构建基于CSV文件的数据驱动接口自动化测试方案。通过预定义测试用例数据,自动发起GET或POST请求并比对响应结果,实现高效、可扩展的接口测试流程,适用于需要批量验证API参数的场景。
本文介绍如何解决Pandas中使用to_json()导出中文数据时出现的\uXXXXXX乱码问题。通过设置force_ascii=False参数,可直接在to_json中保留中文。此外,文章还演示了如何将DataFrame转换为Python原生列表,利用json.dumps的ensure_ascii=False参数生成格式化的JSON数组,并提供了完整的封装类源码供参考。

本文介绍如何利用Python的Splinter库进行浏览器自动化操作。通过两个具体案例,演示如何初始化浏览器、访问网页、填充表单元素以及模拟点击按钮。文章涵盖Google搜索跳转验证及126邮箱自动登录的实现细节,包括元素定位、等待机制及资源释放,为Web应用测试提供基础参考。
本文介绍在Python中清除字符串中间空格的三种常用方法。首先展示使用replace函数直接替换空格,虽然直观但效率有限;其次介绍利用split()分割后join()重组的方式,能有效处理多个连续空格;最后演示通过正则表达式re模块进行匹配替换的高级用法。三种方式各有适用场景,可根据实际需求选择。
本文分析了使用nohup重定向Python程序输出到文件时,因标准输出缓冲导致内容未实时写入的问题。提供了两种有效解决方法:一是在运行命令中增加-u参数以关闭缓冲;二是在代码中调用sys.stdout.flush()强制刷新缓冲区,确保日志正常保存。
本文介绍如何使用Python的re模块和lxml模块提取指定URL页面的title。通过对比正则表达式与XPath两种方法,重点解决特殊页面编码冲突导致的乱码问题,提供完整的代码实现与结果展示,帮助开发者高效获取网页标题信息。