


Python配置HTTP与HTTPS代理的三种实用方法
本文详解Python中使用代理的三种方式:通过urllib和requests库直接配置代理对象,利用HTTP_PROXY和HTTPS_PROXY环境变量全局生效,以及借助Fiddler等工具拦截修改请求。适用于解决国内网络限速或屏蔽问题,提升数据爬取效率与成功率。
2026-10-13
6
本文详解Python中使用代理的三种方式:通过urllib和requests库直接配置代理对象,利用HTTP_PROXY和HTTPS_PROXY环境变量全局生效,以及借助Fiddler等工具拦截修改请求。适用于解决国内网络限速或屏蔽问题,提升数据爬取效率与成功率。
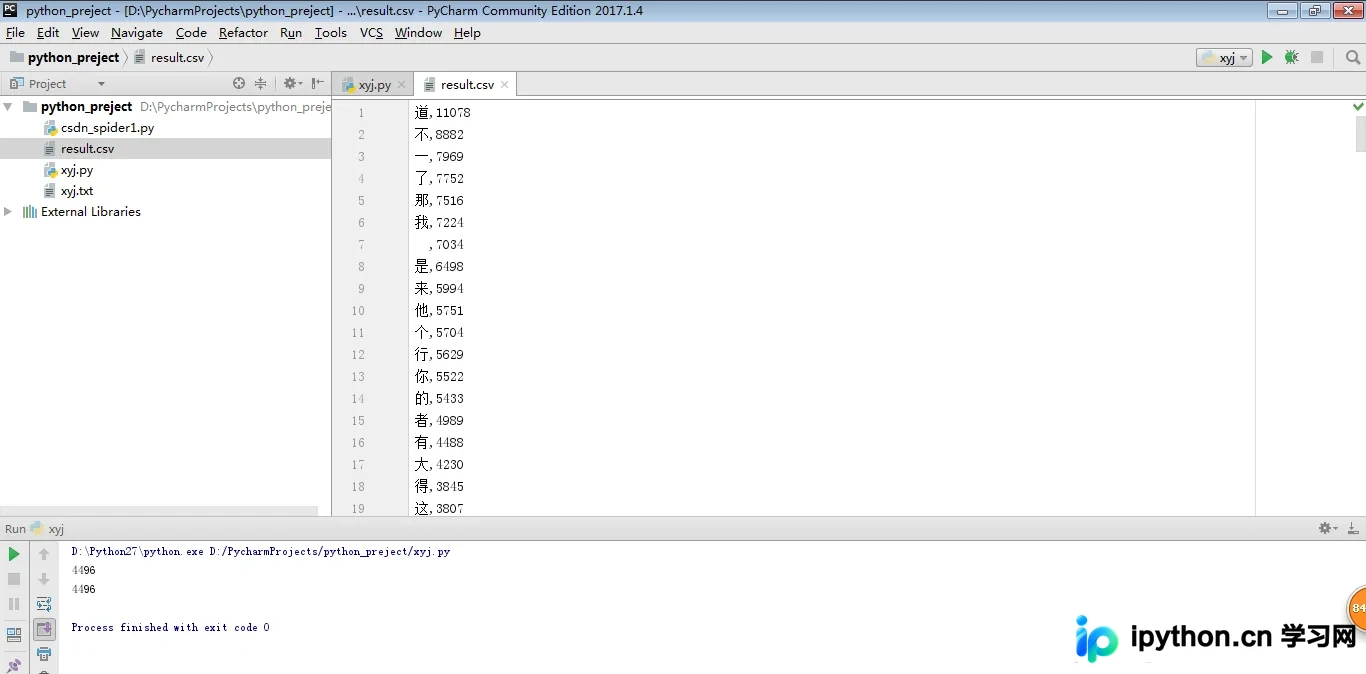
本文通过Python示例展示如何统计《西游记》文本中的汉字使用情况。程序读取xyj.txt文件,过滤标点与空白,利用字典记录每个汉字的出现次数。最终输出不同汉字的总数、各字频次,并按降序排列生成result.csv文件,帮助分析高频汉字。
本文系统整理了 Python 编码规范,涵盖代码编排、文档、空格使用、注释及命名规则。重点讲解缩进标准、行长度限制、模块导入顺序、变量与函数命名约定,以及异常处理和序列操作的性能优化建议,旨在提升代码可读性与维护性。
本文分享使用Python获取并验证免费代理IP的完整流程。通过正则表达式从西刺代理网站抓取IP及端口,利用多线程机制并行检测IP可用性,最终返回格式化的可用IP列表。代码包含getIP、check_one及mul_thread_check三个核心函数,适用于需要规避同一IP重复访问限制的数据抓取场景。
本文详细解析Python中函数作用域的查找机制,重点介绍LEGB(Local, Enclosing, Global, Built-in)规则。通过代码示例说明局部变量、嵌套函数及全局变量的访问顺序,并解释名称空间的概念及其在变量绑定中的作用,帮助开发者准确理解变量可见性与生命周期。
本文介绍使用Python抓取西刺代理网站IP并验证其可用性的完整流程。针对反爬机制,通过设置请求头、增加延时及切换备选网站(如IP巴士)来应对封禁。代码展示了从抓取、解析到通过测试URL验证代理有效性的具体实现,旨在为开发者提供可参考的免费代理获取方案。
本文介绍使用Python自动从网站批量抓取免费代理IP,并通过Socket连接验证其可用性的方法。代码包含IP抓取、有效性判断及本地JSON存储逻辑,支持定时更新以维持IP池的有效性,适合需要稳定代理资源的开发场景。
本文详解Python Requests库中代理服务器的配置方法。通过安装requests[socksv5]包,利用Heroku搭建代理服务,并在本地1080端口启动Socks服务。文章提供了完整的代码示例,展示如何定义http和https代理字典,解决直接访问受限网站时的报错问题,实现通过代理服务器获取资源的目标。
本文提供了Python中实现字符串处理的具体实例,重点展示如何在每个字符后添加空格。通过读取源文件并写入目标文件的完整代码,演示了利用列表推导式和join方法高效处理文本数据的技巧,同时包含对特定行进行特殊标记的逻辑,供开发者参考与复用。
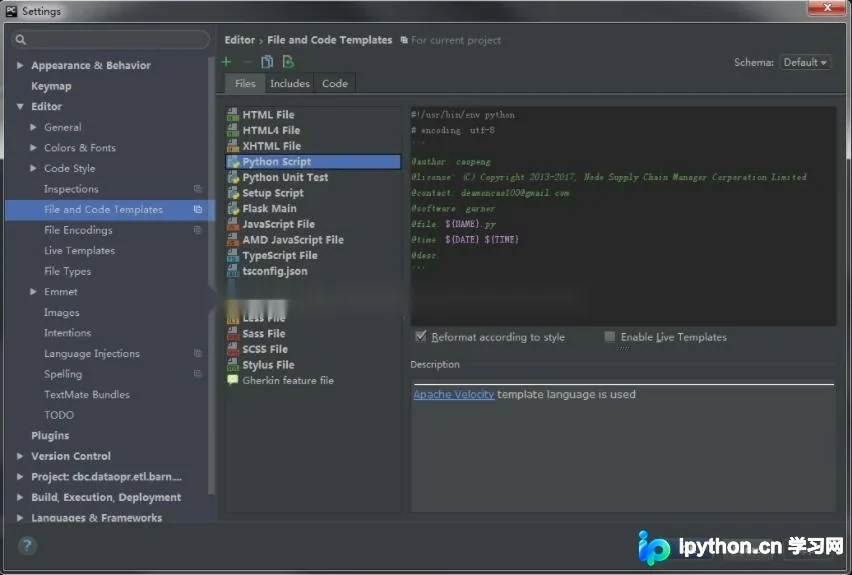
本文介绍如何在 PyCharm 中通过 File and Code Templates 配置 Python Script 模板,实现新建文件时自动插入包含作者、版权、时间及描述信息的文件头注释,提升代码规范性与开发效率。
本文介绍Python通过cx_Oracle库连接Oracle数据库的多种方法。重点解析当配置项中无SID时,如何直接使用tnsnames.ora中的SERVICE_NAME配置进行连接。同时提供完整的连接示例代码及一个封装好的Oracle操作类,涵盖查询、更新及资源释放功能,帮助开发者简化数据库交互流程。
本文介绍在Ubuntu环境下利用Python读取Word文档的方法。针对.docx格式,推荐使用python-docx库进行解析;对于旧版.doc格式,因该库不支持,需借助antiword工具。文章详细说明了python-docx的安装、代码实现以及antiword的编译安装与调用流程,提供完整代码示例供参考。