

Python实现《西游记》文本字数统计与高频字分析

本文通过Python示例展示如何统计《西游记》文本中的汉字使用情况。程序读取xyj.txt文件,过滤标点与空白,利用字典记录每个汉字的出现次数。最终输出不同汉字的总数、各字频次,并按降序排列生成result.csv文件,帮助分析高频汉字。
本文通过一个具体实例,演示如何使用Python进行文本统计,重点解析《西游记》一书的用字情况。内容旨在为读者提供实用的参考代码与思路。
一、数据准备
数据来源为文件 xyj.txt,内容为《西游记》全文,文件大小约为 2.2MB。
文本致敬原著作者吴承恩,共包含 4020 行(或段落)。
二、统计目标
本次任务旨在对《西游记》文本进行以下统计:
1. 计算文本中总共包含多少个不重复的汉字; 2. 统计每一个汉字在文中出现的总次数; 3. 筛选出出现频率最高的汉字列表。
三、核心技术点
本示例涉及以下 Python 基础操作: 1. 文件的读取操作; 2. 字典(Dictionary)数据结构的使用; 3. 字典内容的排序处理; 4. 文件的写入操作。
四、运行效果
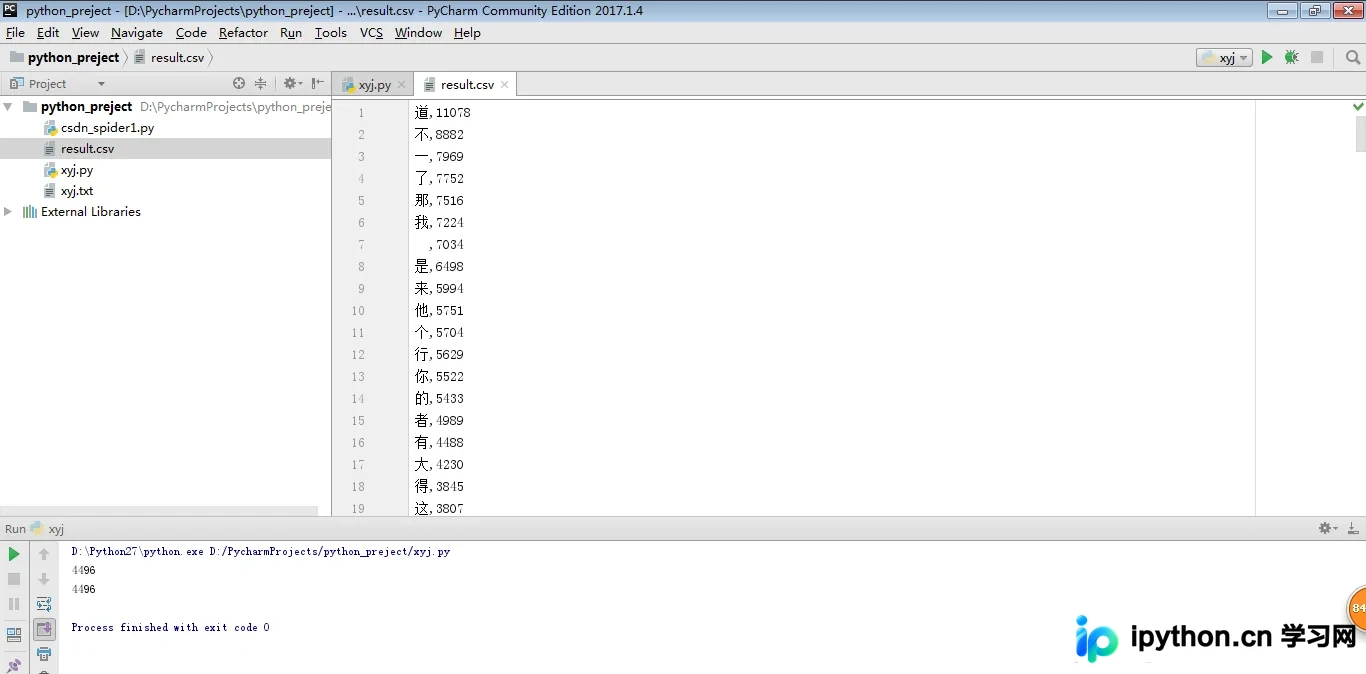
五、源代码实现
# coding:utf8
import sys
reload(sys)
sys.setdefaultencoding("utf8")
fr = open('xyj.txt', 'r')
characters = []
stat = {}
for line in fr:
  # 去掉每一行两边的空白
  line = line.strip()
  # 如果为空行则跳过该轮循环
  if len(line) == 0:
    continue
  # 将文本转为unicode,便于处理汉字
  line = unicode(line)
  # 遍历该行的每一个字
  for x in xrange(0, len(line)):
    # 去掉标点符号和空白符
    if line[x] in [' ','', '\t', '\n', '。', ',', '(', ')', '(', ')', ':', '□', '?', '!', '《', '》', '、', ';', '“', '”', '……']:
      continue
    # 尚未记录在characters中
    if not line[x] in characters:
      characters.append(line[x])
    # 尚未记录在stat中
    if not stat.has_key(line[x]):
      stat[line[x]] = 0
    # 汉字出现次数加1
    stat[line[x]] += 1
print len(characters)
print len(stat)
# lambda生成一个临时函数
# d表示字典的每一对键值对,d[0]为key,d[1]为value
# reverse为True表示降序排序
stat = sorted(stat.items(), key=lambda d:d[1], reverse=True)
fw = open('result.csv', 'w')
for item in stat:
  # 进行字符串拼接之前,需要将int转为str
  fw.write(item[0] + ',' + str(item[1]) + '\n')
fr.close()
fw.close()
此外,推荐两款实用的在线统计工具供读者参考:
在线字数统计工具: http://tools.jb51.net/code/zishutongji
在线字符统计与编辑工具: http://tools.jb51.net/code/char_tongji
若需深入了解 Python 相关技术,建议查阅本站以下专题:《Python文件与目录操作技巧汇总》、《Python文本文件操作技巧汇总》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》以及《Python入门与进阶经典教程》。
希望上述内容能对您的 Python 编程学习与应用有所帮助。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









