


NumPy数组过滤实战:布尔索引与高级筛选技巧
本文详解NumPy中利用布尔数组进行数组过滤的核心机制。通过布尔表达式生成筛选条件,可高效提取满足条件的元素。需注意布尔数组与布尔列表在索引行为上的差异,前者按逻辑值筛选,后者按整数值映射。此外,布尔索引支持直接修改元素,是数据处理中常用的高效手段。
2026-10-13
7
本文详解NumPy中利用布尔数组进行数组过滤的核心机制。通过布尔表达式生成筛选条件,可高效提取满足条件的元素。需注意布尔数组与布尔列表在索引行为上的差异,前者按逻辑值筛选,后者按整数值映射。此外,布尔索引支持直接修改元素,是数据处理中常用的高效手段。
本文介绍Python读取文本文件时因换行符导致输出多出一行的问题,并提供两种解决方案:一是在print函数中使用end=''参数避免自动换行;二是利用strip()方法去除每行末尾的换行符,确保输出格式整洁。
本文详细解析Python模块的标准文件结构,涵盖起始行、文档字符串、导入语句、变量与类定义及主程序块。重点讲解__name__变量在区分模块导入与直接执行中的作用,并强调被导入模块应减少顶级可执行代码的最佳实践,以提升代码复用性与安全性。
本文详细介绍Python中求质数的两种实现方式。首先通过维护已知质数列表进行整除测试,显著提升效率;其次对比暴力遍历法。文章包含完整代码、测试数据及耗时分析,展示不同算法在1000及100000以内质数查找时的性能差异,为Python编程学习提供参考。
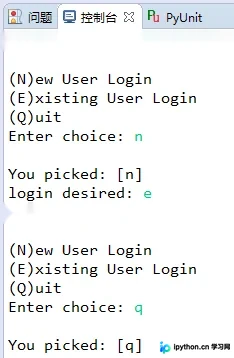
本文介绍了一个基于Python的用户登录系统实现,包含新用户注册与老用户验证功能。系统通过字典db存储用户信息,提供N、E、Q三个选项供用户选择。新用户注册时检查用户名是否已存在,老用户登录时验证密码。系统支持通过Q选项或中断退出,确保交互流程完整且逻辑清晰。
本文介绍使用Python实现简易负载均衡的方法。不同于Nginx的复杂策略,该方案将请求随机分配至可用的后端服务节点。若首选节点不可用,则自动重试其他节点,直至遍历所有地址或成功响应。适用于对压力感知无要求的简单场景。
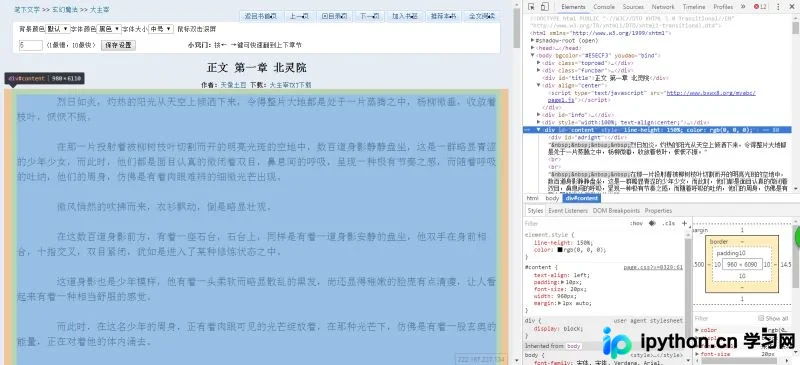
本文分享使用Python抓取网络小说的完整代码与思路。针对网页编码(如GBK与gb18030)导致的解码错误提供解决方案,利用BeautifulSoup提取标题、正文及下一章链接,实现自动循环抓取。代码包含主函数、URL解析及文件写入逻辑,最终生成适合Kindle导入的TXT文本,并建议配合epubBuilder进行二次排版以优化阅读体验。
本文通过对比测试解析 numpy.random.seed() 的核心行为。指出该函数指定的种子值仅对紧随其后的第一个随机数生成操作有效,而非全局持久生效。若不设置种子,系统依据时间自动生成,导致结果不同。理解这一机制有助于避免在循环或多次调用中产生非预期的重复随机数。
本文汇总了Python安装第三方模块时的高频报错及解决方案。针对gcc编译失败,需安装build-essential等系统依赖;遇到html5lib的AttributeError,建议升级相关库;若提示mysql_config未找到,需安装libmysqlclient-dev。掌握这些修复方法可高效解决环境配置问题。
本文介绍在Python中将网络文本数据直接加载到本地内存的四种常用方法。通过对比urllib、requests结合StringIO、numpy.genfromtxt以及pandas.read_csv的实现方式,展示如何高效获取远程CSV文件并转换为矩阵或DataFrame结构,适用于机器学习数据预处理场景。
本文详细介绍Python库PyQuery的使用方法,它实现了jQuery语法以解析HTML。内容涵盖初始化字符串、文件或URL,掌握CSS及伪类选择器定位标签,利用find、children等方法提取节点,以及通过attr和text获取属性与文本。此外,还演示了如何自定义opener以集成requests或selenium,实现更灵活的网页请求与数据提取。
本文提供使用Python Splinter库实现的自动化脚本示例,涵盖12306火车票预订与京东商品抢购场景。通过模拟浏览器操作、Cookie注入及DOM元素交互,演示了从登录、查询到提交订单的完整流程。代码包含异常处理与递归逻辑,旨在辅助技术学习与自动化测试参考。