Python列表与NumPy数组选型及性能优化指南
聚焦Python开发中异构数据管理与大规模数值计算场景,对比内置列表与NumPy数组的核心差异。通过内存分配机制、运算性能实测与类型参数说明选型逻辑,提供混合使用策略、视图切片与内存映射等进阶技巧,帮助开发者在灵活性与执行效率间做出最优决策。
2026-10-10
6
聚焦Python开发中异构数据管理与大规模数值计算场景,对比内置列表与NumPy数组的核心差异。通过内存分配机制、运算性能实测与类型参数说明选型逻辑,提供混合使用策略、视图切片与内存映射等进阶技巧,帮助开发者在灵活性与执行效率间做出最优决策。
面对PDF文档中的冗余页、敏感信息或重复排版,手动调整效率低下。本文基于Python生态,对比PyPDF2、Spire.PDF与PyMuPDF三大工具的特性差异,提供单页删除、多页面批量过滤及空白页自动清理的核心代码。结合内存耗时实测数据与加密文档处理技巧,帮助开发者快速定位技术选型并规避索引越界等常见陷阱。
在 Python 开发中,为了解决第三方依赖冲突与基础解释器版本隔离问题,通常采用虚拟环境进行项目管理。本文详解 venv、conda 以及 pyenv 组合方案的完整操作流程、核心参数与适用边界,帮助开发者根据纯 Web 开发或数据科学需求快速搭建稳定环境。
本文系统介绍 Python 中字符串查找与替换的核心方法。涵盖基础的 find 与 replace 操作、基于 re 模块的正则表达式精准匹配、利用 fuzzywuzzy 处理相似度文本,以及针对海量数据的逐行读取优化策略。结合日志分析实战场景,提供可直接运行的代码模板与性能调优建议。
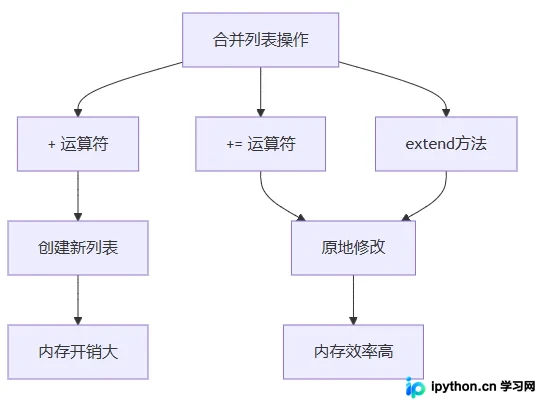
Python合并列表主要依赖`+`运算符、`+=`运算符与`extend()`方法。三者虽结果相似,但在原址修改、内存分配及数据类型兼容性上存在本质差异。本文结合底层执行逻辑与基准测试数据,明确各方法适用边界,提供高效编写列表拼接代码的选型策略。
本文解析多进程同时读写文件时因操作非原子性导致读取残缺数据的竞态条件问题。提供临时文件加原子替换、第三方库filelock实现文件锁以及引入数据库三种解决方案,附带Python完整代码实现与跨平台兼容、缓存落盘等关键避坑细节,帮助开发者按场景选择稳定可靠的文件并发控制策略。
本文系统讲解 FastAPI 中的异常处理机制,涵盖基础 HTTPException 抛出规范、全局异常处理器统一响应格式、自定义业务异常类设计以及 WebSocket 长连接异常关闭策略。通过代码示例说明如何构建健壮的错误响应体系,并附带常见避坑指南,帮助开发者避免服务崩溃与前端调试困扰。
在技术文档流转场景中,常需将结构化的Markdown笔记导出为标准Word报告。本文演示如何利用Python库Spire.Doc.Free本地完成Markdown到Docx格式的转换。通过指定FileFormat参数加载源文件并调用SaveToFile输出,可实现单文件处理与批量文件夹转换。该方法无需依赖Microsoft Word,运行时需注意免费版页数限制及少数特殊语法的兼容性。
在使用PyInstaller将XGBoost相关代码打包为独立可执行文件时,常会遇到运行时提示“super() has no attribute 'get_params'”的错误。该问题主要源于打包工具误识别了XGBoost内置的sklearn.py模块,导致与scikit-learn标准库发生命名冲突。通过手动重命名该冲突文件并重新打包,即可恢复依赖正常加载。
本文提供基于Python内置os模块的文件批量重命名脚本方案。通过配置目标路径、前后缀参数及字符替换规则,可高效处理大量文件名变更任务,同时保留原始扩展名并内置路径校验机制,适用于日常文档整理与资源归档。
在日常开发与运维中,手动管理Docker容器的生命周期效率较低。本文提供一套基于Python的自动化脚本方案,结合subprocess与psutil库,实现按名启动容器、通过chpasswd修改内部root密码、先stop后rm的安全清理,以及实时采集主机CPU、内存和磁盘使用率。脚本适用于Linux环境,可直接集成至运维平台或定时任务。
本文详解利用Python与OpenCV进行身份证号码识别的完整流程。通过图像预处理、轮廓检测与位置筛选定位18位数字区域,结合自定义模板匹配逐字输出识别结果。提供核心代码实现、参数调整方法及常见误差排查指南,适用于身份验证自动化录入等基础场景。