

Python合并列表核心方法:`+`、`+=`与`extend()`深度对比

发布时间:2026-10-10| 3人浏览过
Python合并列表主要依赖+运算符、+=运算符与extend()方法。三者虽实现类似的数据拼接效果,但在是否修改原对象、内存分配机制以及可接收的数据类型上存在明确差异。本文通过执行逻辑拆解与性能测试,说明不同场景下的最优调用方式。
基础机制与原生命令区别
Python在处理列表拼接时提供了三种常用途径。理解它们对底层容器的影响是正确选型的前提:
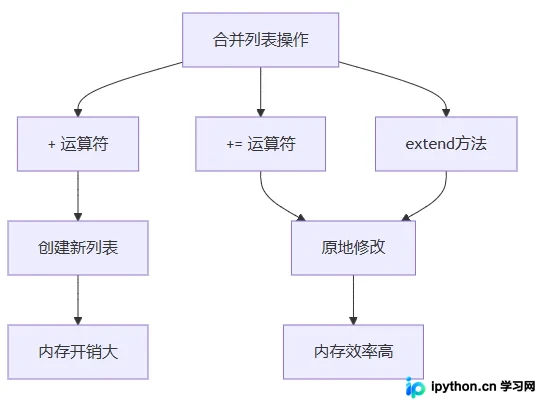
+运算符:执行浅拷贝并创建全新列表对象。原始参与运算的列表地址不变,适合需要保留历史数据的不可变处理流。+=运算符:等价于原地加法(iadd)。直接修改左侧列表的容器引用,不产生完整的新对象副本。extend()方法:遍历右侧可迭代对象的元素并逐个追加至当前列表末尾。行为与+=一致,但方法调用语法在意图表达上更为显式。
list1 = [1, 2, 3]
list2 = [4, 5, 6]

# 返回新对象,原列表保持原样
result = list1 + list2

# 就地修改 list1
list1 += list2

# 就地修改 list1
list1.extend(list2)
性能表现与内存分配逻辑
拼接操作的性能瓶颈通常源于内存重新分配与元素搬运次数。以下为标准环境下的耗时基准参考:
import timeit

def test_plus():
    a, b = [1, 2, 3], [4, 5, 6]
    c = a + b

def test_inplace_plus():
    a, b = [1, 2, 3], [4, 5, 6]
    a += b

def test_extend():
    a, b = [1, 2, 3], [4, 5, 6]
    a.extend(b)

print("+ 运算符:", timeit.timeit(test_plus, number=1000000))
print("+= 运算符:", timeit.timeit(test_inplace_plus, number=1000000))
print("extend():", timeit.timeit(test_extend, number=1000000))
运行结果参考:
+ 运算符: 0.312秒
+= 运算符: 0.125秒
extend(): 0.130秒
+较慢的原因在于每次调用都需分配目标容量、将左侧元素搬运一次、再将右侧元素搬运一次。+=与extend()均复用现有内部数组或按需平滑扩容,仅执行单次追加循环,因此在大规模批量处理中具备显著优势。
典型业务场景适配方案
构建动态聚合数据集
在循环内频繁累积数据时,避免反复触发新对象分配:
# 低效:循环内持续申请内存
accumulated = []
for i in range(1000):
    chunk = [i] * 1000
    accumulated = accumulated + chunk

# 推荐:原地追加,保持单一内存块
accumulated = []
for i in range(1000):
    chunk = [i] * 1000
    accumulated.extend(chunk)
跨来源异构数据整合
extend()与+=原生支持任意可迭代协议,可直接对接元组、集合键或生成器:
user_list = ["Alice", "Bob"]
sys_log = ("login_01", "logout_02")
meta_dict = {"key_a": 10, "key_b": 20}

combined = []
combined += user_list
combined += sys_log
combined.extend(meta_dict.keys())
print(combined)
类状态与队列管理
在自定义结构体中维护状态池时,明确区分一次性合并与增量追加:
class MessagePool:
    def __init__(self):
        self.pool = []

    def push(self, items):
        self.pool.extend(items)

    def merge_from(self, other):
        self.pool += other.pool

pool_a = MessagePool()
pool_a.push(["msg_1", "msg_2"])

pool_b = MessagePool()
pool_b.push(["msg_3"])
pool_a.merge_from(pool_b)
print(pool_a.pool)
常见误区与边界条件排查
嵌套追加与扁平化混淆
append()将参数视为单个元素插入,而extend()展开参数序列:
a = [1, 2]
a.append([3, 4])
print(a)

b = [1, 2]
b.extend([3, 4])
print(b)
不可变类型的语义陷阱
+=在可变容器上执行原地修改,但在元组等不可变类型上实为重新赋值:
t = (1, 2)
t += (3,)
l = [1, 2]
l += [3]
链式语法限制
+支持连续连接表达式,但+=属于语句级操作,无法作为表达式节点串联:
# 合法
x = [1] + [2] + [3]

# 非法:SyntaxError
y = [1]; y += [2] += [3]
选型总结与最佳实践
- 需保留输入数据快照或进行纯函数式数据处理:
+ - 追求极简洁写法且确认无需回溯旧值:
+= - 强调代码可读性、需接入非列表迭代源或处于密集写入循环:
extend() - 涉及千级别以上元素累积时,严格规避
+带来的重复拷贝开销
掌握上述底层分配差异与协议边界,即可根据业务流水线的状态要求与数据形态精准匹配指令。以上就是Python中合并List列表操作的详细内容,更多关于Python数据结构处理的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









