

基于OpenCV与Python实现身份证号码识别详解

本文详解利用Python与OpenCV进行身份证号码识别的完整流程。通过图像预处理、轮廓检测与位置筛选定位18位数字区域,结合自定义模板匹配逐字输出识别结果。提供核心代码实现、参数调整方法及常见误差排查指南,适用于身份验证自动化录入等基础场景。
一、识别原理与实现流程
身份证号码识别是计算机视觉在证件信息提取中的典型应用。本案例采用传统图像处理方案,整体遵循「预处理 → 定位 → 分割 → 匹配」的逻辑。首先对输入图像进行灰度化与二值化增强字符对比度,随后通过轮廓查找与坐标规则锁定18位数字所在的ROI区域,最后将截取出的单字图像与预先制作的数字模板进行相似度比对,输出识别字符串。
二、环境与素材准备
运行本方案需安装 Python 3.x 环境,并配置以下核心依赖:
opencv-python(cv2):负责图像读写、形态学操作与模板匹配numpy:支撑数组计算与边界框坐标处理
数据准备阶段需准备两张图片路径。第一张为包含标准数字 0-9 的模板图,用于建立特征库:
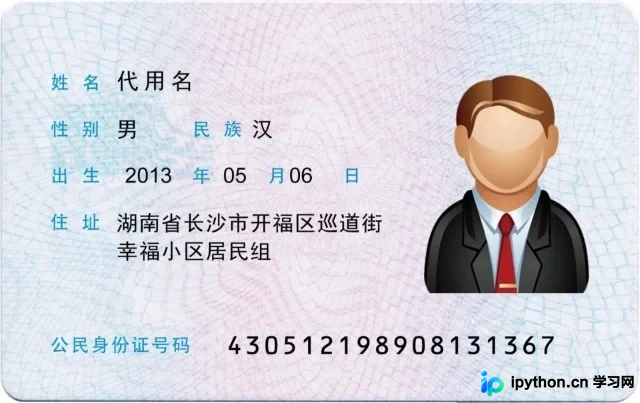
第二张为待处理的身份证原件图像:
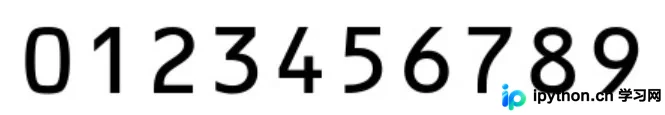
三、核心代码实现
第1步:导入依赖与辅助函数定义
目的:初始化交互窗口显示逻辑与轮廓排序规则,避免重复编写绘图代码。
入口:脚本头部导入模块。
动作:封装 cv_show 快速渲染图像,实现 sort_contours 按指定轴心对齐多个轮廓。
重要参数:method 支持 left-to-right / top-to-bottom 等枚举值。
完成状态:控制台无 ImportError,调用函数即可返回排序后的轮廓列表与边界框元组。
import cv2
import numpy as np

def cv_show(name, image):
    cv2.imshow(name, image)
    cv2.waitKey(0)
    cv2.destroyAllWindows()

def sort_contours(cnts, method='left-to-right'):
    reverse = False
    i = 0
    if method in ['right-to-left', 'bottom-to-top']:
        reverse = True
    if method in ['top-to-bottom', 'bottom-to-top']:
        i = 1
    boundingBoxes = [cv2.boundingRect(c) for c in cnts]
    (cnts, boundingBoxes) = zip(*sorted(zip(cnts, boundingBoxes),
                                        key=lambda b: b[1][i], reverse=reverse))
    return cnts, boundingBoxes
第2步:构建数字字符匹配模板
目的:从标准模板图中提取单个数字的像素分布,作为后续比对的基准源。
入口:读取 sfzh.png 文件。
动作:转灰度 → 反阈值二值化(数字白底黑字转为数字黑白背景)→ 查找外轮廓 → 提取 ROI 并统一缩放至固定分辨率。
重要参数:阈值设为 150 配合 THRESH_BINARY_INV;统一尺寸 resize 至 (57, 88) 以适配模板匹配矩阵大小。
完成状态:内存中生成 digits 字典,Key 为索引 0~9,Value 为标准化后的灰度掩膜。
# 读取模板并转灰度/二值
gray_template = cv2.imread("sfzh.png", 0)
ret, ref_bin = cv2.threshold(gray_template, 150, 255, cv2.THRESH_BINARY_INV)
cv_show('Binary Template', ref_bin)

# 提取轮廓并排序
_, contours, _ = cv2.findContours(ref_bin, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
sorted_contours, _ = sort_contours(contours, method='left-to-right')

# 构建模板字典
digits = {}
for idx, contour in enumerate(sorted_contours):
    x, y, w, h = cv2.boundingRect(contour)
    roi = ref_bin[y-2:y+h+2, x-2:x+w+2]
    roi = cv2.resize(roi, (57, 88))
    roi = cv2.bitwise_not(roi)
    digits[idx] = roi
cv2.destroyAllWindows()
第3步:定位号码区域并执行模板匹配
目的:在原图中精准切割出身份证底部的18位数字串并完成逐字解码。
入口:加载 sfz.jpg 原始照片。
动作:灰度化后二值化 → 全局轮廓遍历 → 基于 Y轴(330~360) 与 X轴(>220) 的硬性条件过滤掉无关边框文字 → 对剩余轮廓执行单字符自适应阈值与尺寸对齐 → 遍历模板字典计算皮尔逊相关系数得分 → 取最高分对应数字拼接输出。
重要参数:二值阈值 120;匹配方法 cv2.TM_CCOEFF;边界扩展 ±2 像素防止截断。
完成状态:终端 Print 输出连续18位字符,同时弹出叠加红色矩形框与文本标签的原图预览窗口。
img_id = cv2.imread('sfz.jpg')
img_copy = img_id.copy()
gray_id = cv2.imread('sfz.jpg', 0)
ret, id_bin = cv2.threshold(gray_id, 120, 255, cv2.THRESH_BINARY_INV)

# 轮廓筛选定位
_, contours_id, _ = cv2.findContours(id_bin.copy(), cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
locs = []
for (i, contour) in enumerate(contours_id):
    x, y, w, h = cv2.boundingRect(contour)
    if 330 < y < 360 and x > 220:
        locs.append((x, y, w, h))
locs = sorted(locs, key=lambda x: x[0])

# 逐字匹配与可视化
output = []
for (gX, gY, gW, gH) in locs:
    group = gray_id[gY-2:gY+gH+2, gX-2:gX+gW+2]
    group = cv2.threshold(group, 0, 255, cv2.THRESH_BINARY | cv2.THRESH_OTSU)[1]
    roi = cv2.resize(group, (57, 88))
    roi = cv2.bitwise_not(roi)

    scores = []
    for digit, template in digits.items():
        result = cv2.matchTemplate(roi, template, cv2.TM_CCOEFF)
        (_, score, _, _) = cv2.minMaxLoc(result)
        scores.append(score)

    jieguo = str(np.argmax(scores))
    output.append(jieguo)
    cv2.rectangle(img_copy, (gX-5, gY-5), (gX+gW+5, gY+gH+5), (0, 0, 255), 1)
    cv2.putText(img_copy, jieguo, (gX, gY-15), cv2.FONT_HERSHEY_SIMPLEX, 0.65, (0, 0, 255), 2)

cv_show('ID Card with Recognition', img_copy)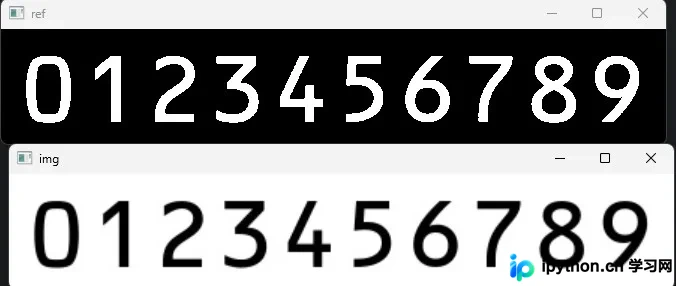
四、参数适配与常见排错
- 坐标阈值僵化问题:代码中的
330<y<360与x>220依赖于测试图的固定分辨率。若更换高清原图或拍摄角度变化,建议先注释掉硬编码判断,打印所有轮廓的(x,y,w,h)动态计算相对比例区间,或使用霍夫线变换辅助定位横线区域。 - 模板匹配失效场景:当证件存在明显倾斜或光照渐变时,
TM_CCOEFF易出现分数断层。此时可引入仿射变换cv2.warpAffine进行水平校正,或切换至 Tesseract OCR 引擎以获取更强的抗噪能力。 - 校验位逻辑缺失:示例代码仅输出纯数字串,未包含尾号校验位逻辑。正式接入业务前,应补充第18位模11加权求和验证函数,拦截非法输入串。
五、运行效果与总结
完整跑通上述流程后,控制台将稳定打印类似以下的18位解析结果:
识别结果:11010119900101123X该方案无需依赖重型深度学习框架,仅凭 OpenCV 基础算子即可完成证件号码的结构化提取,适合边缘设备或轻量级自动化录入系统部署。以上就是基于OpenCV与Python实现身份证号码识别的详细内容,更多关于计算机视觉证件识别与模板匹配的技术资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









